
机器学习与深度学习 / 系统课时
调整分类阈值
调整分类阈值
分类模型输出的正类概率不一定适合直接用默认的 0.5 阈值判定。通过验证集比较不同阈值下的误报、漏报和告警数量,可以在不重新训练模型的情况下,选出符合业务损失与处理能力的决策阈值。
学习目标
- 根据预测概率与指定阈值生成类别
- 理解阈值对正类数量、召回率和精确率的影响
- 根据验证集表现、业务成本和处理能力选择阈值
阈值改变什么
对于模型输出的正类概率 ,当 时预测为正类 1,否则预测为负类 0,其中 是分类阈值。阈值只影响最终类别判定,不会改变已经训练好的模型参数和预测概率。
降低阈值会预测更多正类,召回率不会降低,但通常也会增加误报;提高阈值会减少正类预测,可能降低召回率并增加漏报。精确率可能随阈值提高而改善,但不保证单调上升,因为被排除的样本中也可能包含真实正例。
例如,五个样本的预测概率分别为 0.15、0.35、0.55、0.72、0.91。当阈值从 0.3 提高到 0.5,再提高到 0.8,预测正类数量依次为 4、3、1。概率恰好等于阈值时,本课使用大于等于规则,将其判为正类。
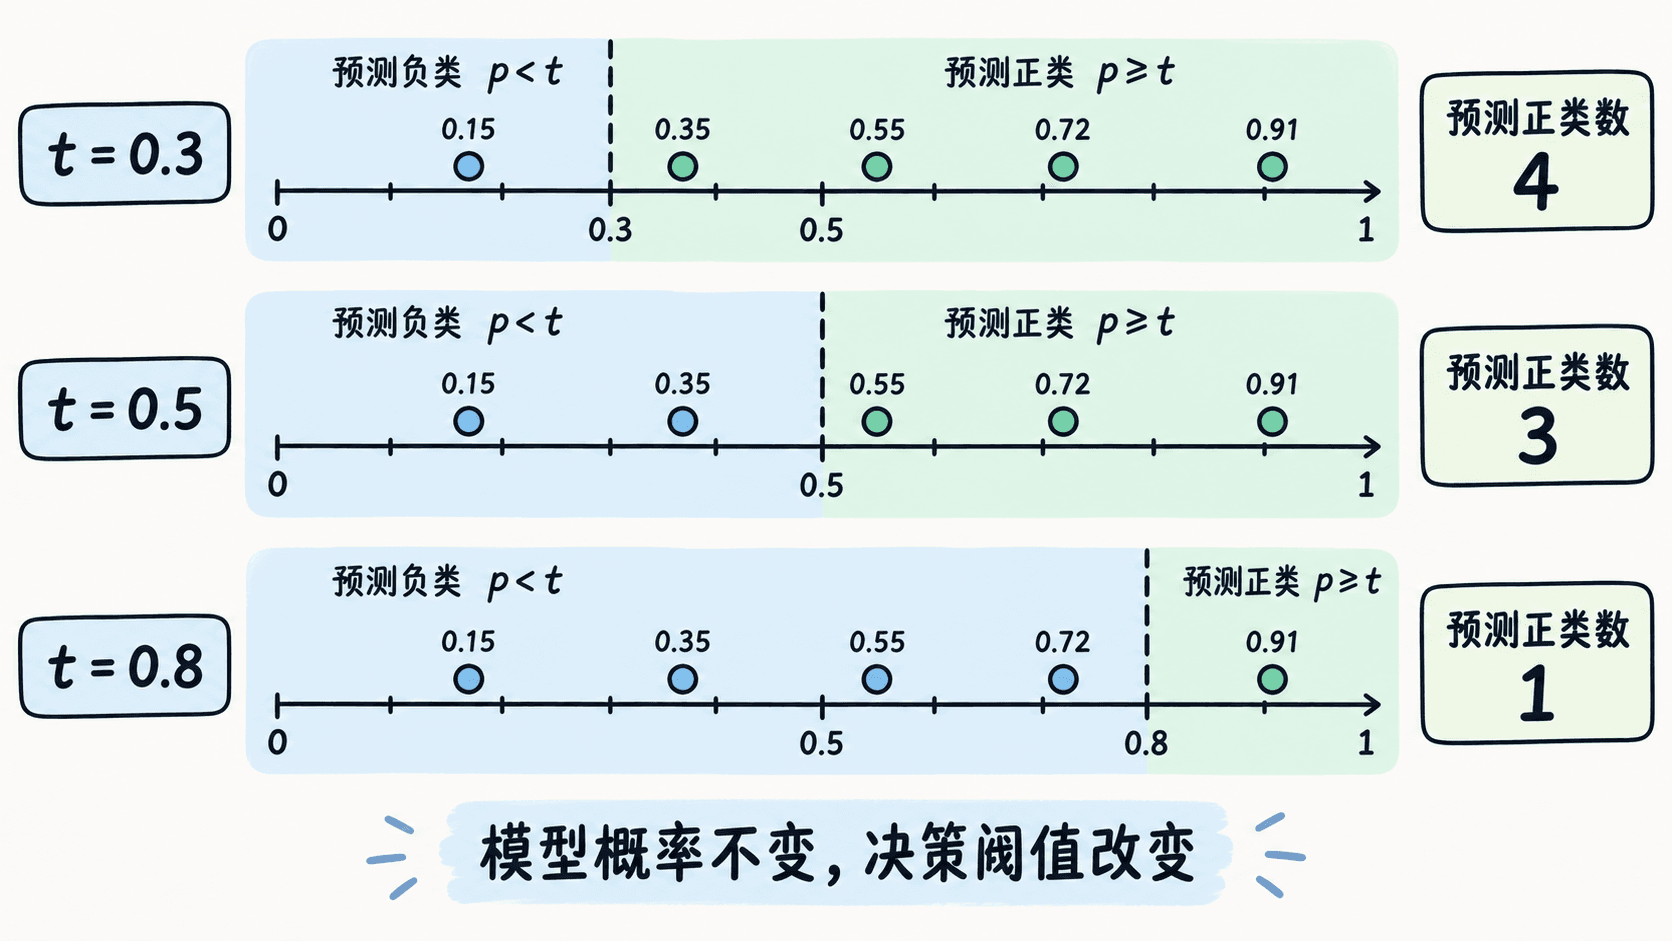
运行阈值对比
将代码保存为 threshold_demo.py。示例使用五条验证集样本,真实标签依次为 0、1、0、1、1。假设每次误报的业务成本为 2,每次漏报的成本为 5,两种成本使用相同单位。
除了观察预测类别,还要计算假正例 FP 和假反例 FN。FP 表示真实为负类却预测为正类,FN 表示真实为正类却预测为负类。示例通过比较两类错误的加权成本,演示如何筛选阈值。
import numpy as np

probabilities = np.array([0.15, 0.35, 0.55, 0.72, 0.91])
labels = np.array([0, 1, 0, 1, 1])  # 验证集真实标签
cost_fp, cost_fn = 2, 5

costs = []
for threshold in [0.3, 0.5, 0.8]:
    # 只调整决策规则,不重新训练模型
    predictions = (probabilities >= threshold).astype(int)

    # 分别统计误报和漏报,计算业务损失
    fp = np.sum((predictions == 1) & (labels == 0))
    fn = np.sum((predictions == 0) & (labels == 1))
    cost = int(cost_fp * fp + cost_fn * fn)
    costs.append((cost, threshold))

    print(f"阈值 {threshold:.1f}: {predictions.tolist()}")
    print(f"误报 {fp},漏报 {fn},成本 {cost}")

print(f"最低成本阈值:{min(costs)[1]:.1f}")
确保当前 Python 环境已安装 NumPy,然后运行:
python threshold_demo.py预期输出:
阈值 0.3: [0, 1, 1, 1, 1]
误报 1,漏报 0,成本 2
阈值 0.5: [0, 0, 1, 1, 1]
误报 1,漏报 1,成本 7
阈值 0.8: [0, 0, 0, 0, 1]
误报 0,漏报 2,成本 10
最低成本阈值:0.3
三组结果显示,随着阈值提高,预测正类数量从 4 降至 1。虽然阈值 0.8 没有误报,但漏掉两个真实正例,总成本达到 10;阈值 0.3 有一次误报,却没有漏报,总成本只有 2。因此在给定成本假设下,0.3 是这三个候选阈值中的最低成本选择。
这里的成本权重来自业务假设,并非模型自动估算。五条样本仅用于演示计算过程,不足以代表真实模型的统计表现,也不能直接作为生产环境的阈值选择依据。
在业务约束下确定阈值
实际选阈值时,不能只看误报与漏报的加权成本。还需要考虑人工审核量、每日告警上限,以及业务对召回率或精确率的最低要求。
例如,上面的五条样本若最多只能处理 3 条告警,阈值 0.3 虽然成本最低,但产生 4 条正类告警,已经超过处理能力。此时在三个候选值中,阈值 0.5 产生 3 条告警、成本为 7,阈值 0.8 产生 1 条告警、成本为 10,因此应选择 0.5。
真实项目中可以按以下顺序操作:
- 在独立验证集上保存模型预测概率与真实标签,不要提前把概率转换成固定类别。
- 设置一组候选阈值,例如从 0.1 到 0.9,每隔 0.05 测试一次,逐一计算 FP、FN、精确率、召回率和业务成本。
- 排除不满足最低召回率、误报容忍度或告警处理能力的阈值,再从剩余候选值中选择成本最低的方案。
- 固定最终阈值,用未参与训练与调参的测试集进行一次最终评估,并记录模型版本、阈值及评价指标。
上线后持续监控预测正类比例、实际误报率、漏报率及概率分布变化。如果业务成本或样本分布发生明显变化,应使用新的、具有代表性的验证数据重新评估阈值,而不是直接修改生产阈值后只观察告警数量。