
机器学习与深度学习 / 系统课时
使用核函数处理非线性
使用核函数处理非线性
本课解决原始特征空间中类别无法被直线分开的问题。完成后,你能够在圆环数据上比较线性核与 RBF 核,训练具有非线性决策边界的分类器,并通过独立测试集验证分类效果。
学习目标
- 理解核技巧的直观作用及其与非线性决策边界的关系。
- 比较线性核与 RBF 核在圆环数据上的分类效果。
- 理解
C和gamma如何影响模型复杂度,并掌握基本调参方法。
核技巧的作用
线性 SVM 在原始特征空间中寻找能够区分类别的直线或超平面。但有些数据天然具有非线性结构,例如一类样本集中在圆心附近,另一类样本分布在外侧圆环上。此时,无论怎样调整直线的位置和角度,都难以将两类样本完全分开。
核函数可以计算样本在更高维特征空间中的相似性,使原空间中的非线性问题在高维特征空间中更容易被线性超平面分开。这种方法称为核技巧(Kernel Trick)。
核技巧的关键优势是:训练时可以直接计算核函数值,不必显式构造所有高维特征坐标。
常见的核函数包括:
- 线性核(Linear Kernel):计算样本的内积,适用于原始特征空间中近似线性可分的数据。
- 径向基函数核(RBF Kernel):根据样本间的距离计算相似性,能够产生弯曲或闭合的非线性决策边界。
RBF 核的表达式为:
其中, 和 是两个样本, 控制距离对相似性的影响。距离越近,核函数值越接近 1;距离越远,核函数值越接近 0。
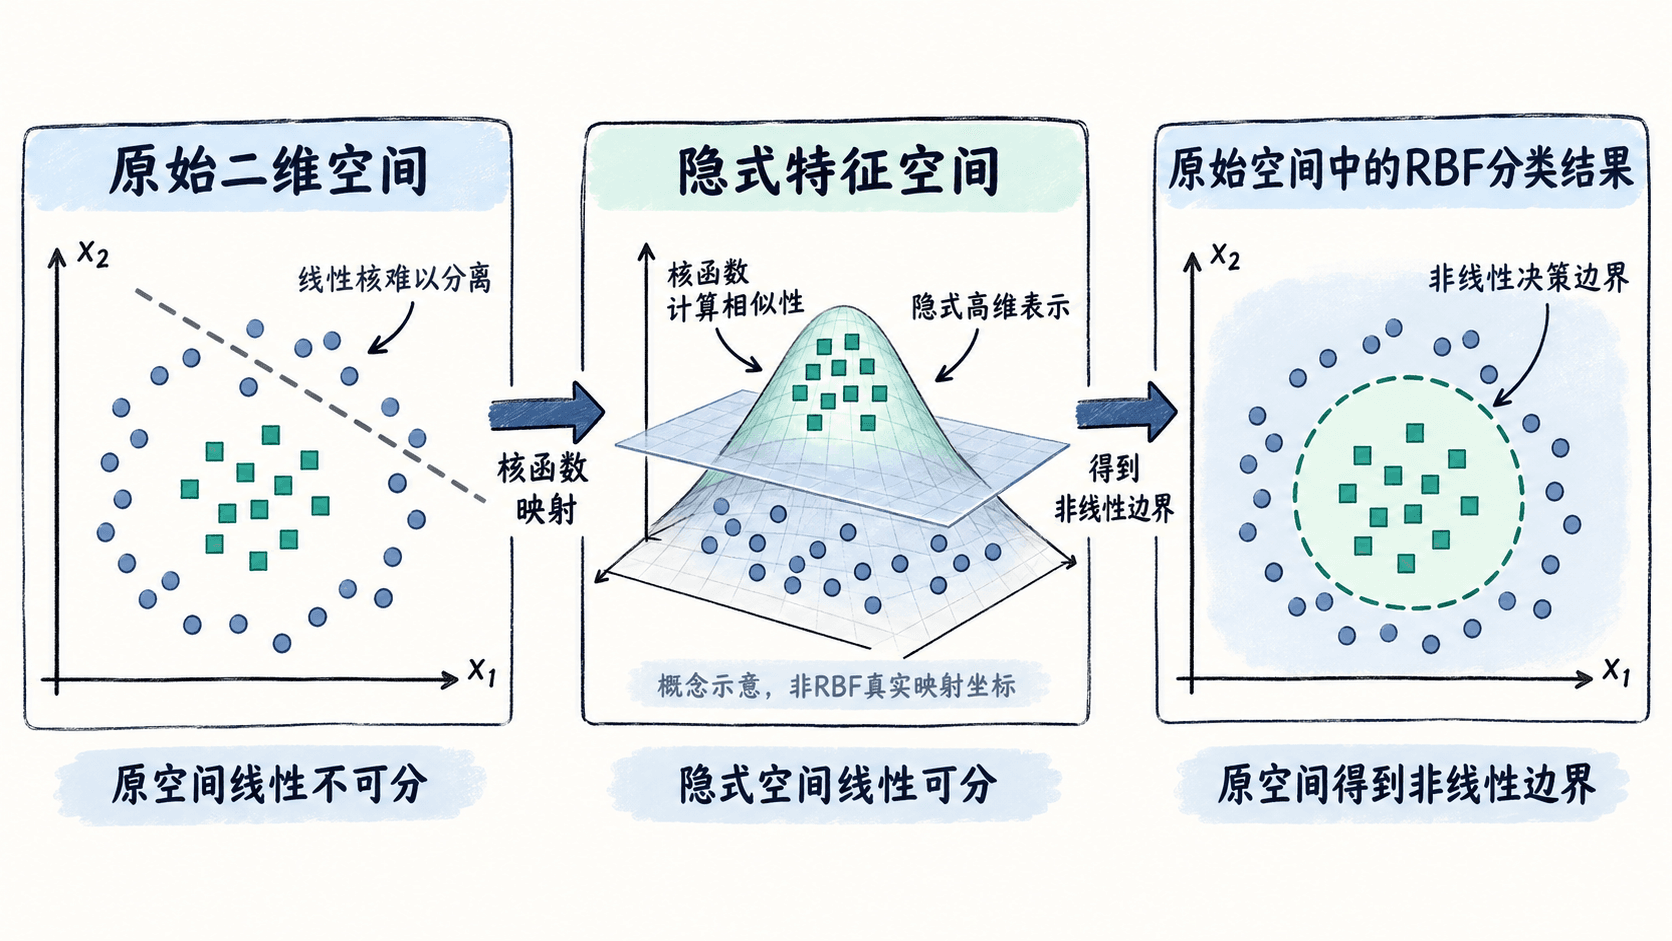
图中的高维空间只是核技巧的概念示意,并不是 RBF 核实际生成的三维坐标。RBF 核对应的特征空间通常是无限维的,但算法不需要显式计算这些坐标。
完整示例
下面在圆环数据上比较线性核和 RBF 核。两种模型使用相同的数据划分,使测试准确率具有可比性。
使用已安装 scikit-learn 的 Python 环境,将以下代码保存为 kernel_svm_demo.py。
from sklearn.datasets import make_circles
from sklearn.model_selection import train_test_split
from sklearn.svm import SVC

# 生成内外两圈数据,两类样本无法用一条直线完全分开
x, y = make_circles(
    n_samples=200,
    factor=0.4,
    noise=0.05,
    random_state=42,
)

# 分层划分,保证训练集与测试集的类别比例一致
x_train, x_test, y_train, y_test = train_test_split(
    x,
    y,
    test_size=0.25,
    random_state=42,
    stratify=y,
)

for kernel in ["linear", "rbf"]:
    # 两个模型使用相同数据,便于比较边界表达能力
    model = SVC(kernel=kernel, gamma="scale")
    model.fit(x_train, y_train)
    print(f"{kernel}: {model.score(x_test, y_test):.2f}")
代码使用 make_circles() 生成 200 个样本,其中 factor=0.4 控制内圈相对于外圈的半径,noise=0.05 添加少量随机扰动。random_state=42 固定随机过程,使示例可以复现。
train_test_split() 将 75% 的样本用于训练,剩余 25% 用于测试。SVC 是 scikit-learn 提供的支持向量分类器,通过 kernel 参数切换核函数。
运行命令:
python kernel_svm_demo.py预期输出:
linear: 0.56
rbf: 1.00
如何理解与验证结果
本例共有 50 个测试样本。线性核的准确率为 0.56,表示正确分类了 28 个样本;RBF 核的准确率为 1.00,表示这 50 个测试样本全部分类正确。
产生差异的原因不是 RBF 核看到了更多训练样本,而是两种核函数能够表达的决策边界不同:
- 线性核只能在原始二维空间中形成直线边界,难以区分内外圆环。
- RBF 核能够形成环绕中心类别的非线性边界,更符合这组数据的几何结构。
可以修改 make_circles() 的 noise 参数,例如从 0.05 增大到 0.2,重新运行程序并观察两种模型的测试准确率。噪声增加后,类别可能出现重叠,RBF 核也不再保证获得 100% 的正确率。
控制 C 和 gamma 防止过拟合
RBF 核具有更灵活的边界表达能力,但灵活性过高也可能使模型记住训练数据中的噪声。SVC 主要通过 C 和 gamma 控制这一行为。
C 控制违反间隔约束的惩罚强度。
C较大:更重视减少训练错误,可能形成复杂边界,对异常点更加敏感。C较小:允许更多间隔违反,正则化更强,边界通常更平滑,但过小可能欠拟合。
gamma 控制 RBF 核中样本相似性的影响范围。
gamma较大:相似性随距离衰减更快,单个样本的局部影响范围较小,边界可能变得曲折。gamma较小:相似性随距离衰减较慢,模型倾向形成更平滑的边界,过小可能无法识别局部类别结构。
示例中的 SVC(kernel="rbf", gamma="scale") 使用基于训练数据方差的默认 gamma 设置,C 默认为 1.0。线性核不使用 gamma 参数,因此在比较线性核和 RBF 核时,不能把 gamma 的作用归因于线性模型。
实际调参可以按以下步骤进行:
- 保留独立测试集,只使用训练集选择超参数。
- 对
C尝试0.1、1、10,对 RBF 核的gamma尝试0.01、0.1、1。 - 在训练集上使用 5 折分层交叉验证,比较不同参数组合的平均验证准确率。
- 选择验证表现较好的参数组合,在完整训练集上重新拟合,最后使用测试集评估一次。
如果训练准确率很高,但交叉验证准确率明显偏低,应优先检查是否过拟合,可尝试减小 C 或 gamma。如果训练和验证准确率都偏低,则需要检查是否欠拟合,不能只凭单个参数的大小判断。
核 SVM 的训练成本通常会随着样本数量快速增长,因此不适合直接无限扩展到超大规模数据。当数据量很大、线性模型效果已经足够好时,可以优先考虑线性 SVM;只有发现明显非线性结构且计算资源允许时,再尝试 RBF 核并通过交叉验证控制复杂度。