
机器学习与深度学习 / 系统课时
使用 K 近邻分类
使用 K 近邻分类
本课解决如何利用相似历史样本预测新样本类别的问题。你将用二维样本训练 K 近邻分类器,核对邻居距离与投票结果,并学会根据验证表现选择 K 值、处理特征尺度。
学习目标
- 理解距离计算、邻居选择和多数投票机制
- 训练 K 近邻分类器并验证预测结果
- 选择合适的 K,避免特征尺度干扰距离
KNN 如何工作
K 近邻分类(KNN)在训练时保存带标签的样本;预测时,先计算待预测点到各训练样本的距离,选出最近的 K 个邻居,再按类别投票。票数最多的类别就是预测结果。
KNeighborsClassifier 默认采用欧氏距离(Minkowski 距离的 p=2 情况)。对两个二维样本,距离为:
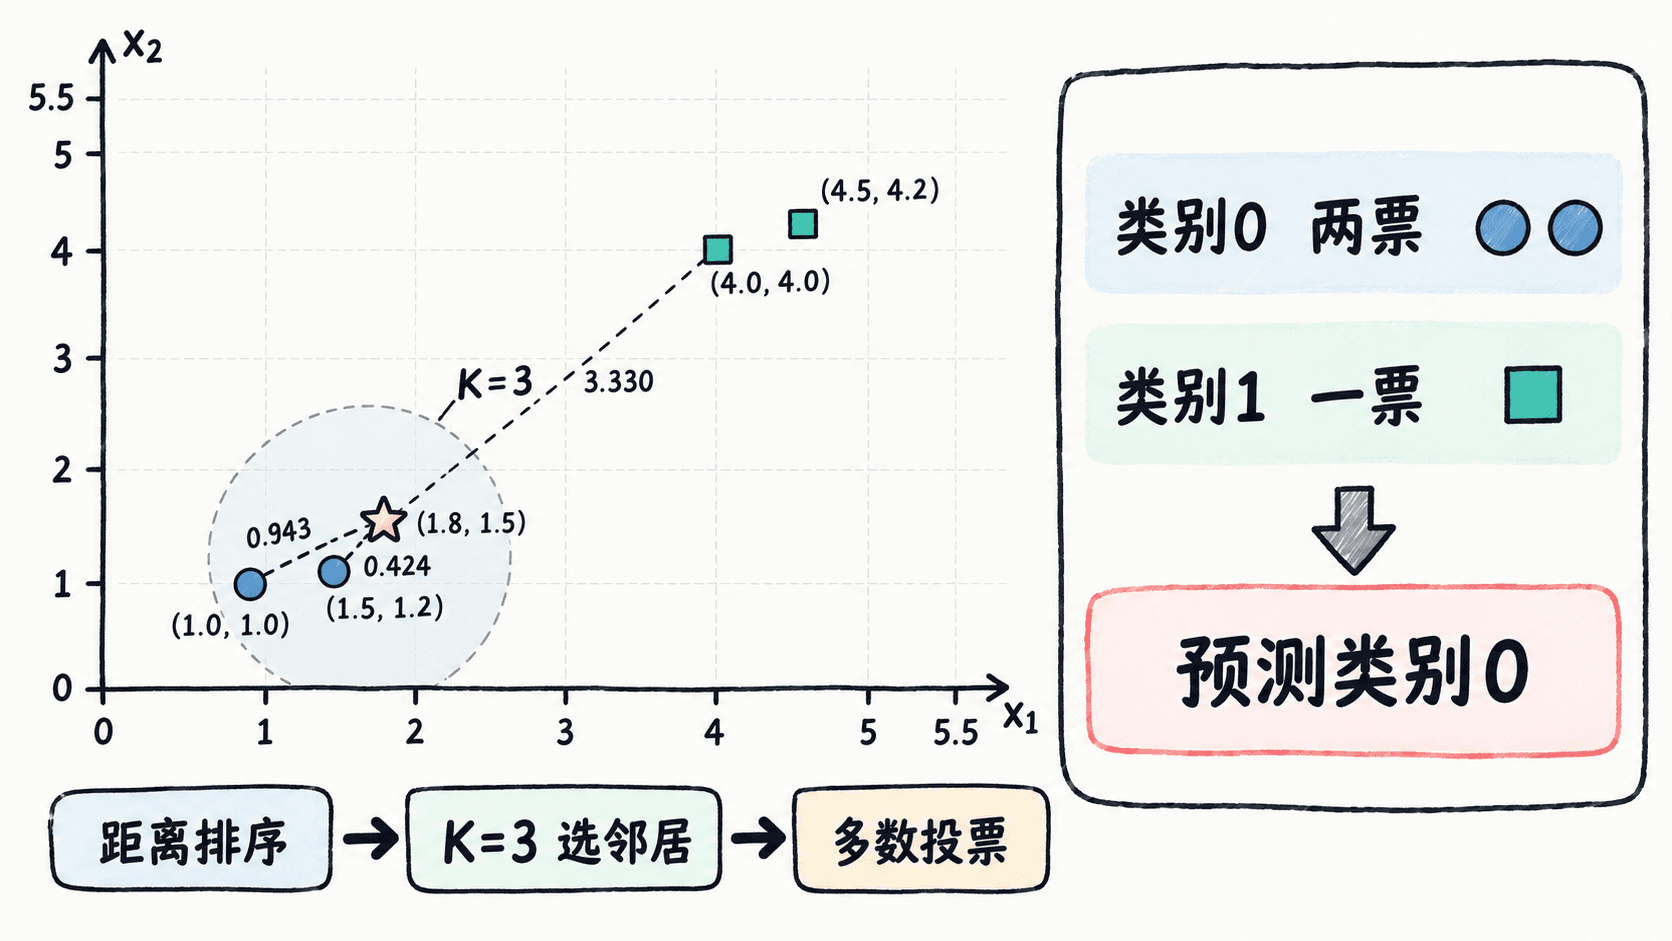
例如待预测点为 (1.8, 1.5),到 (1.5, 1.2) 和 (1.0, 1.0) 的距离分别约为 0.424、0.943。K=3 时还会选入 (4.0, 4.0):三个邻居的类别为 0、0、1,因此预测类别为 0。
完整示例
准备 Python 环境及 numpy、scikit-learn 依赖,将代码保存为 knn_demo.py。这组二维特征数值尺度相近,先不缩放,以便直接核对原始距离。
import numpy as np
from sklearn.neighbors import KNeighborsClassifier

x = np.array([
    [1.0, 1.0],
    [1.5, 1.2],
    [4.0, 4.0],
    [4.5, 4.2],
])
y = np.array([0, 0, 1, 1])

# K=3 时按最近的三个训练样本投票
model = KNeighborsClassifier(n_neighbors=3)
model.fit(x, y)

# 同时查看预测类别和最近邻距离
print("预测类别:", model.predict([[1.8, 1.5]])[0])
print("邻居距离:", np.round(model.kneighbors([[1.8, 1.5]])[0], 3))
运行命令:
python knn_demo.py预期输出:
预测类别: 0
邻居距离: [[0.424 0.943 3.33 ]]
kneighbors 返回的距离按从近到远排列,形状为“查询样本数 × 邻居数”,所以这里是 1×3。你可以将 n_neighbors 改为 1 再运行,检查返回距离的数量是否从三个变成一个;注意这个极小样本集只用于说明机制,不用于判断实际泛化能力。
选择 K 与特征尺度
K 太小容易让噪声点左右预测,太大则可能忽略局部结构。实际项目可先留出独立测试集,再仅在训练集上通过交叉验证比较 K=1、3、5、7、9 等候选值,按平均验证分数选定参数,最后只用测试集评估一次。候选 K 不得大于各折实际用于拟合的样本数;本例只有四条训练数据,不能直接照搬这组候选值做交叉验证。
距离还受量纲影响。例如年龄相差 5 岁、收入相差 5000 元时,未经缩放的欧氏距离几乎由收入决定。真实数据通常把 StandardScaler 与 KNN 放进同一个 Pipeline,并在交叉验证中拟合,确保每一折的验证数据不参与均值和标准差计算。预测新数据时也必须沿用训练时拟合的缩放参数。
使用边界
KNN 训练快,但预测时需要查找近邻;当样本量很大或特征维度很高时,查询开销增加,距离也可能难以区分类别。若出现 n_neighbors 超过训练样本数的错误,先检查 K 与实际拟合样本数。类别不均衡时,还可尝试 weights='distance' 让更近的邻居具有更高投票权重,并用验证集比较效果。