
机器学习与深度学习 / 系统课时
理解机器学习工作流
理解机器学习工作流
学习目标
完成本课后,你将能够:
- 描述机器学习项目从问题定义到部署监控的完整流程
- 说明训练集、验证集和测试集的职责
- 识别数据泄漏和离线指标失真的风险
完整工作流
一个可交付的机器学习项目通常包含以下阶段:
text
业务问题定义
    ↓
数据收集与理解
    ↓
数据清洗与特征工程
    ↓
划分训练集、验证集、测试集
    ↓
模型训练与调参
    ↓
离线评估与误差分析
    ↓
部署上线
    ↓
监控、反馈与再训练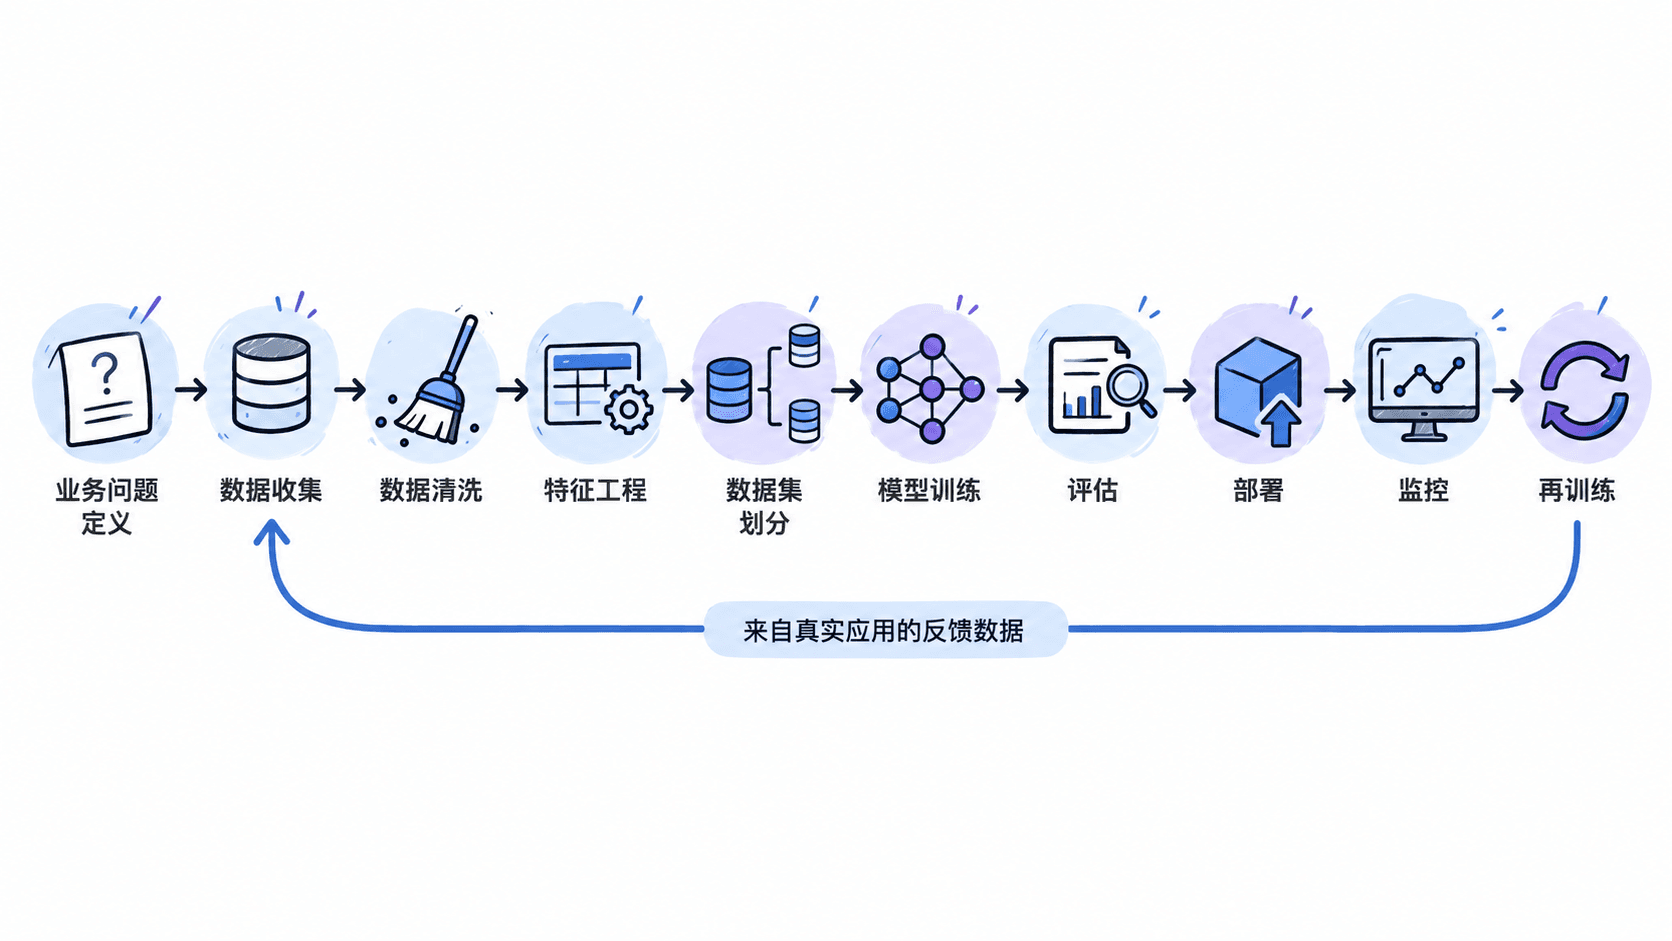
先定义业务问题和指标
模型训练前必须把业务问题改写成可计算任务。至少明确:
- 预测对象:对谁或什么进行预测。
- 预测时间点:模型在什么时候产生结果。
- 目标变量:预测连续值还是类别。
- 可用特征:预测时真正能够获得哪些数据。
- 评价指标:准确率、召回率、均方误差或业务收益。
- 使用方式:结果由系统自动执行,还是交给人工审核。
指标必须与业务成本一致。例如欺诈识别不能只看准确率,因为正常订单数量远多于欺诈订单。
训练集、验证集与测试集
| 数据集 | 用途 | 是否参与调参 |
|---|---|---|
| 训练集 | 学习模型参数 | 是 |
| 验证集 | 选择模型和超参数 | 是 |
| 测试集 | 最终一次独立评估 | 否 |
测试集如果被反复用于选模型,就不再独立,最终指标会被高估。时间序列数据还应按照时间顺序划分,不能随机把未来样本放入训练集。
一个最小工作流示例
python
from sklearn.datasets import load_iris
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split

features, labels = load_iris(return_X_y=True)

# 固定 random_state,确保每次划分一致,便于复现实验
x_train, x_test, y_train, y_test = train_test_split(
    features,
    labels,
    test_size=0.2,
    random_state=42,
    stratify=labels
)

model = LogisticRegression(max_iter=300)
model.fit(x_train, y_train)

predictions = model.predict(x_test)
print(f"测试集准确率: {accuracy_score(y_test, predictions):.2f}")
预期输出:
text
测试集准确率: 1.00这个结果只说明模型在当前小型测试集上的表现,不能直接代表生产环境长期效果。
上线后的监控重点
部署不是流程终点。生产阶段至少要监控输入字段缺失率、特征分布变化、预测分布、接口耗时、错误率和有真实标签后的业务指标。
当用户行为、政策、商品结构或数据采集方式改变时,训练数据与线上数据会产生偏移,需要重新评估和训练模型。
本课练习
- 为“预测用户 30 天内是否流失”定义预测对象、时间点和标签。
- 解释为什么不能使用退款发生后的字段预测订单是否退款。
- 为一个线上模型列出至少 4 个监控指标。
按自己的节奏,确认真正理解。