
机器学习与深度学习 / 系统课时
比较分类算法
比较分类算法
只凭算法名称或一次准确率选型,容易把训练集拟合误当成泛化能力。本课先用同一组异或样本观察线性与非线性分类器的差别,再给出公平验证步骤,最后结合预测成本与可解释性确定候选模型。
学习目标
- 比较常见分类算法的适用数据与能力边界
- 用统一样本和指标验证不同分类器的表现
- 通过无泄漏评估与工程约束完成选型
先根据数据缩小候选范围
逻辑回归适合作为快速、可解释的线性基线;KNN 适合小型低维数据,但预测需要搜索邻居;朴素贝叶斯常用于高维稀疏文本;线性 SVM 适合高维近线性边界;RBF SVM 适合中小规模非线性数据,但训练成本可能随样本量明显增加。
朴素贝叶斯还要匹配特征分布:文本词频常用 MultinomialNB,连续数值特征可尝试 GaussianNB。实际筛选时先记录样本数、特征维度、类别比例与预测时延要求,避免只按算法名决定候选。
完整示例
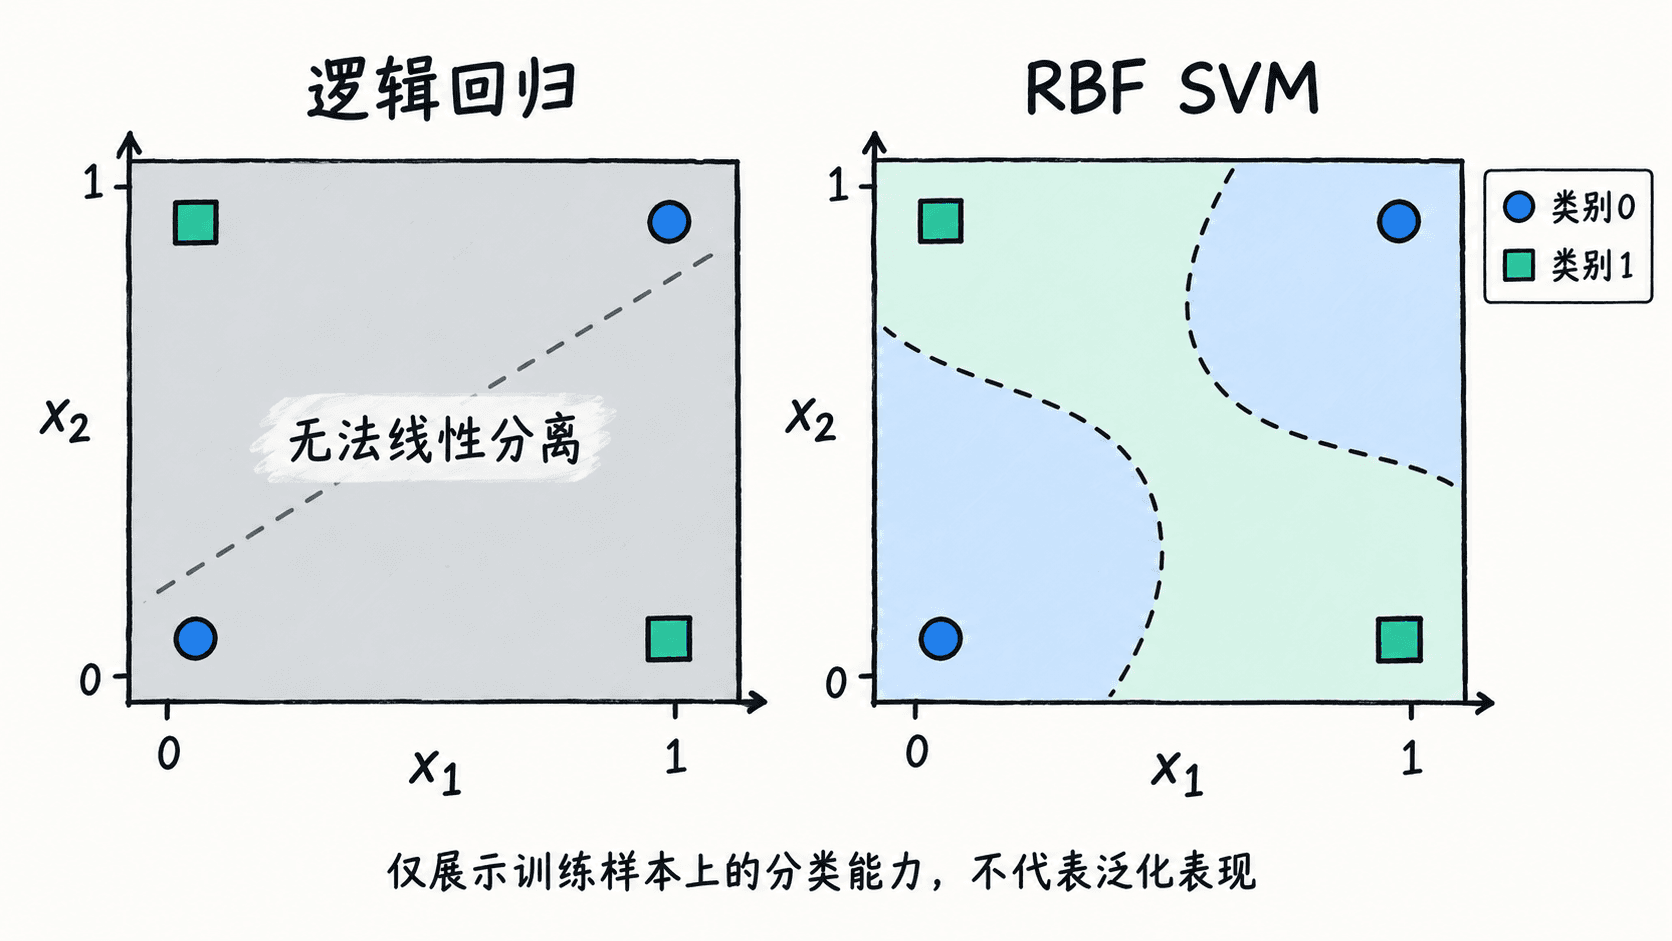
下面使用异或(XOR)数据展示线性模型和非线性模型的差异。四个样本中,对角点属于同类,单条直线无法把两类全部分开。将代码保存为 classifier_compare_demo.py;环境需安装 NumPy 和 scikit-learn。
python
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
from sklearn.naive_bayes import GaussianNB
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC

# 对角点同类,线性边界无法完全分离
x = np.array([
    [0.0, 0.0],
    [0.0, 1.0],
    [1.0, 0.0],
    [1.0, 1.0],
])
y = np.array([0, 1, 1, 0])

models = {
    "逻辑回归": LogisticRegression(),
    "KNN": KNeighborsClassifier(n_neighbors=1),
    "朴素贝叶斯": GaussianNB(),
    "RBF SVM": SVC(kernel="rbf", gamma=2, C=10),
}

for name, model in models.items():
    model.fit(x, y)
    # 本示例只用于观察边界能力,不代表正式泛化评价
    score = accuracy_score(y, model.predict(x))
    print(f"{name}: {score:.1f}")
运行命令:
bash
python classifier_compare_demo.py预期输出:
text
逻辑回归: 0.5
KNN: 1.0
朴素贝叶斯: 0.5
RBF SVM: 1.0
如何解释结果
逻辑回归只能学习线性边界,无法拟合异或关系;这组对称样本也让高斯朴素贝叶斯难以区分类别。KNeighborsClassifier(n_neighbors=1) 能记住四个训练点,RBF 核 SVM 则可形成非线性边界,因此两者的训练集准确率为 1.0。
公平比较与最终选择
正式比较要使用相同的目标定义、数据划分和指标,调参不能接触最终测试集。可按以下顺序执行:
- 将真实数据分层划分为 80% 训练集与 20% 测试集,固定
random_state=42;先封存测试集。 - 在训练集上用同一套五折
StratifiedKFold比较候选模型。将缺失值填充、标准化与估计器放进Pipeline,保证每一折只用该折训练部分拟合预处理;文本计数特征按模型要求单独处理。 - 使用宏平均 F1、混淆矩阵及业务关心的召回率判断效果;
k、C、gamma等超参数只在交叉验证中选择。 - 确定模型后,再用封存的测试集评估一次,并在相同硬件和批大小下测量预测延迟、训练耗时与模型大小。
例如风控任务要求正类召回率至少 0.90、单条预测 P95 延迟不超过 20 毫秒:先排除不满足任一约束的模型;若多个模型均达标且验证指标接近,优先选择更容易解释、部署和监控的方案。异或例子只能说明边界表达能力,真实选型仍以未见数据的表现为准。
按自己的节奏,确认真正理解。