
机器学习与深度学习 / 系统课时
训练单变量回归模型
训练单变量回归模型
把学习时长作为唯一输入特征,使用线性回归拟合学习时长与考试分数之间的关系,并对新样本预测分数。完成训练后,你将读取模型的系数和偏置,核对预测结果,并判断预测是否超出了训练数据范围。
学习目标
- 使用单个特征训练回归模型
- 读取系数、偏置和预测值
- 识别训练范围外预测风险
输入形状与线性关系
即使只有一个特征,scikit-learn 的特征输入仍应保持二维结构,形状为“样本数 × 1”;目标值通常是一维数组。例如,5 名学生各有一个学习时长特征,输入 x 的形状就是 (5, 1),目标 y 的形状是 (5,)。
单变量线性回归学习的关系可以表示为:
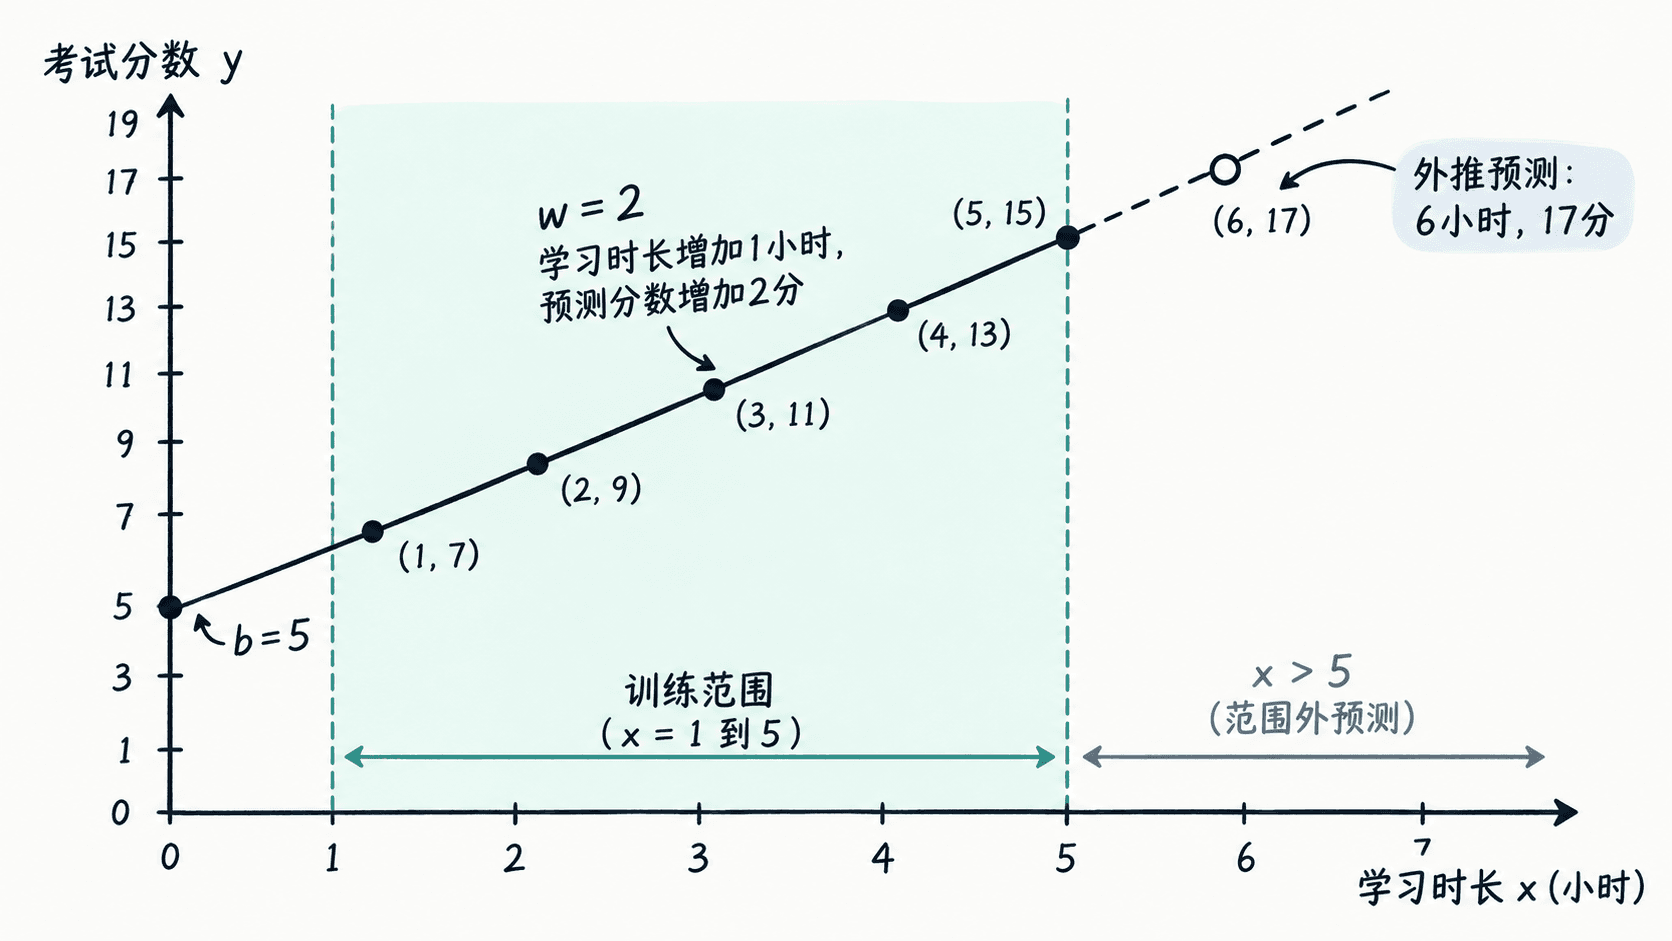
其中, 是学习时长, 是预测分数, 是回归系数, 是偏置。系数表示学习时长每增加 1 个单位时,预测分数变化多少;偏置表示模型在 时的预测值。
训练时,LinearRegression 会根据样本估计 和 ,使训练样本的预测值与真实值之间的平方误差之和尽可能小。对于本课这种严格符合直线关系的数据,模型可以得到与真实关系一致的参数。
完整示例
将代码保存为 single_regression_demo.py。运行前需要在 Python 环境中安装 numpy 和 scikit-learn。
import numpy as np
from sklearn.linear_model import LinearRegression

x = np.array([[1], [2], [3], [4], [5]], dtype=float)
y = np.array([7, 9, 11, 13, 15], dtype=float)

model = LinearRegression()
model.fit(x, y)

# 数据严格满足 y = 2x + 5,便于核对训练结果
print("系数:", model.coef_[0])
print("偏置:", model.intercept_)
print("x=6 的预测:", model.predict([[6]])[0])
这里的 fit(x, y) 使用全部五个样本训练模型,model.coef_[0] 读取唯一特征对应的系数,model.intercept_ 读取偏置。predict([[6]]) 则使用学习时长为 6 小时的新样本进行预测。
注意,预测接口与训练接口一样,要求特征输入为二维结构。[[6]] 表示一个样本、一个特征,而 [6] 是一维数组,直接传给 predict 会产生输入维度错误。
运行与验证
在保存脚本的目录中运行:
python single_regression_demo.py预期输出:
系数: 2.0
偏置: 5.0
x=6 的预测: 17.0
可以手动验证:训练样本满足 ,因此学习时长每增加 1 小时,分数增加 2 分;偏置为 5。代入 ,得到预测分数 ,与程序输出一致。
本例的预期结果还可以用来检查训练是否成功:系数应接近 2,偏置应接近 5,预测值应接近 17。真实数据存在噪声时,训练结果通常不会得到如此整齐的数值,可使用合理的浮点误差容忍范围进行比较。
结果判断与外推风险
训练样本的学习时长范围是 1~5 小时,预测 6 小时对应的分数虽然可以计算,但已经超出训练范围,属于外推预测。模型默认这段范围之外仍保持相同的线性规律,而训练数据并没有验证这一假设。
实际项目中,应先划分训练集与测试集,只使用训练集执行 fit,再对未参与训练的测试样本调用 predict,通过平均绝对误差(MAE)等指标评估预测效果。如果使用时间顺序数据,还应根据业务场景选择符合时间顺序的划分方式,避免未来信息进入训练过程。
训练集上的直线拟合不能代表真实泛化能力。尤其是预测值远离训练特征范围时,应明确标记为外推,并结合业务规律判断线性关系是否仍然成立。对于本例,17 分是模型根据已有关系计算出的结果,并不表示真实学生学习 6 小时就一定获得 17 分。