
机器学习与深度学习 / 系统课时
处理缺失值
处理缺失值
数据中的空值可能导致模型无法训练,也可能反映未采集、字段不适用等业务情况。本课通过一个五行数据集,统计缺失数量与比例,演示数值和类别特征的填充方法,并验证如何在不使用测试集统计信息的前提下完成处理。
学习目标
- 统计字段的缺失数量与比例,识别缺失范围
- 根据缺失原因选择删除或填充策略
- 只在训练集上计算填充值,避免测试集信息泄漏
先判断缺失值的含义
缺失值可能表示未采集、字段不适用、用户拒绝填写或系统上传失败。处理前先确认生成原因;关键标签缺失通常不能随意填充,普通数值特征才适合使用中位数等统计量。
在 pandas 中,isna() 用于识别缺失位置,isna().sum() 统计每列缺失数量,isna().mean() 计算每列缺失比例。例如,五条记录中有两条缺失年龄,缺失比例就是 40%。
缺失比例只能说明问题规模,不能单独决定处理方式。某个字段即使只有 5% 的缺失,如果缺失集中发生在高风险客户身上,直接删除这些记录仍可能让训练数据产生偏差。
完整示例
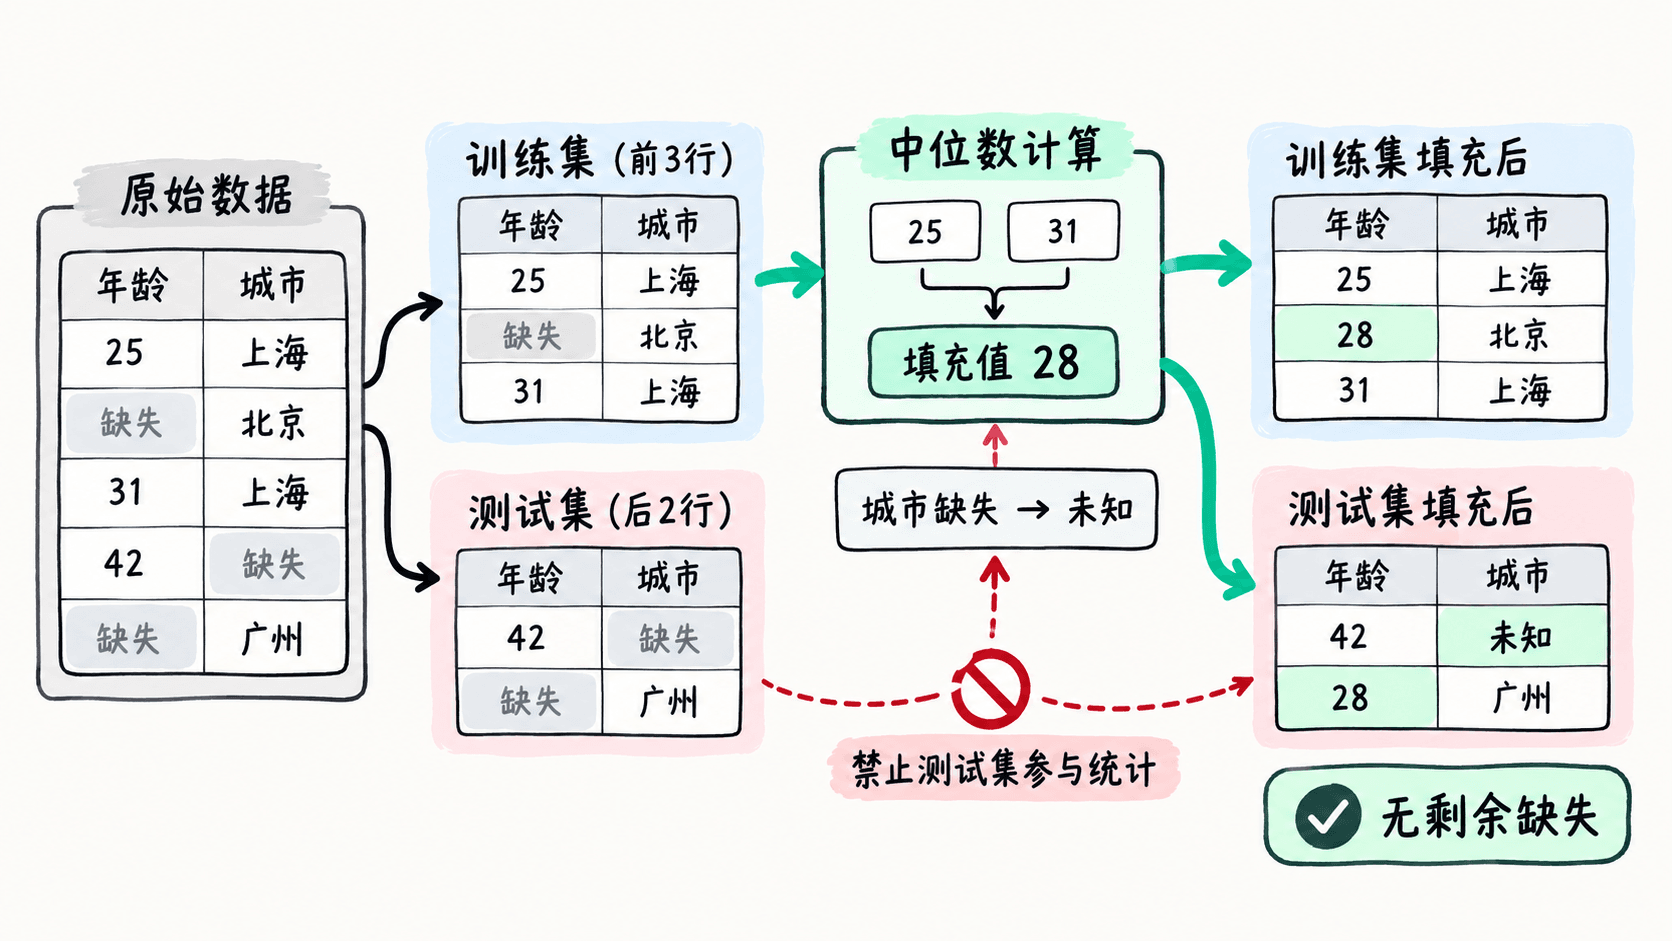
下面统计缺失值,并分别使用中位数和固定类别填充。为了演示训练集与测试集的正确关系,将前 3 行作为训练集、后 2 行作为测试集。代码保存为 missing_value_demo.py,运行前需安装 pandas。
训练集的有效年龄是 25 和 31,其中位数为 28;测试集中的年龄 42 不参与填充值计算。确定填充值后,训练集和测试集都使用同一个值进行转换。
import pandas as pd

data = pd.DataFrame({
    "age": [25, None, 31, 42, None],
    "city": ["上海", "北京", "上海", None, "广州"],
})

print("缺失数量:", data.isna().sum().to_dict())
print("缺失比例(%):", (data.isna().mean() * 100).round(1).to_dict())

# 固定划分仅用于演示,先划分再计算填充值
train = data.iloc[:3].copy()
test = data.iloc[3:].copy()

# 年龄存在极端值风险时,中位数通常比均值更稳健
age_fill = train["age"].median()

for subset in (train, test):
    subset["age"] = subset["age"].fillna(age_fill)
    # 使用明确类别保留“原值未知”这一信息
    subset["city"] = subset["city"].fillna("未知")

result = pd.concat([train, test], ignore_index=True)
print("训练集年龄填充值:", age_fill)
print(result.to_string(index=False))

# 验证填充完整性与测试集规则一致性
assert result.notna().all().all()
assert test.loc[4, "age"] == age_fill
print("验证通过:无剩余缺失,测试集复用训练集填充值")
运行命令:
python missing_value_demo.py预期输出:
缺失数量: {'age': 2, 'city': 1}
缺失比例(%): {'age': 40.0, 'city': 20.0}
训练集年龄填充值: 28.0
 age city
25.0   上海
28.0   北京
31.0   上海
42.0   未知
28.0   广州
验证通过:无剩余缺失,测试集复用训练集填充值
这里的缺失比例是在完整示例数据上计算的,用于展示统计方法。实际建模时,应主要依据训练集的数据分布选择预处理策略,避免根据测试集的特征分布反向调整训练流程。
选择策略与边界
不同缺失原因适合不同处理方式,常见选择如下:
- 删除记录:缺失比例较低、缺失近似随机,且删除后仍有足够样本时可以考虑。删除前应检查是否集中损失某类人群。
- 中位数填充:适用于年龄、收入等数值特征,尤其是分布偏斜或存在极端值时。若特征存在明显分组差异,可以考虑基于训练集计算分组统计量。
- 众数或固定类别填充:适用于类别特征。填写“未知”可以保留未提供信息的含义;使用众数则可能掩盖缺失本身的业务特征。
- 保留缺失指示特征:当缺失本身可能影响预测时,可增加一个标记字段。例如
age_missing使用 1 表示原始年龄缺失,0 表示原始年龄有效。
对于监督学习中的目标标签,如果真实值缺失,通常不能直接用均值或众数填充后继续当作真实标签训练。应优先恢复标签,无法恢复时通常需要排除相应的监督训练样本。
验证填充结果与防止数据泄漏
填充完成后,至少检查两项:一是必需特征是否仍存在缺失值,二是测试集是否复用了训练集确定的规则。本例通过两个 assert 分别检查完整性和年龄填充值;任一条件不成立,程序会抛出 AssertionError。
本例特意将数据划成训练集和测试集,展示统计量的来源。在真实项目中,应该先完成训练集划分,再用训练集拟合填充器,并对验证集、测试集及未来预测数据仅执行转换。使用 scikit-learn 时,可以通过 SimpleImputer 的 fit 和 transform 实现这一约束。
还要注意三个边界:训练集年龄全部缺失时无法计算有效中位数,需要另外制定策略;填充后的 28 不是真实观测年龄,不能当作原始事实解释;如果预测时字段缺失方式与训练时明显不同,需要重新检查数据采集链路及模型表现。
因此,缺失值处理完成的判断标准不只是数据中没有空值,还包括填充规则符合字段含义、训练与测试严格隔离,以及填充后的数据能够通过一致的验证规则。