
机器学习与深度学习 / 系统课时
理解线性回归
理解线性回归
本课解决如何用一个或多个特征预测连续数值的问题。完成后,你能够读懂线性回归模型,理解权重、偏置和残差的含义,通过一个简单示例完成拟合与预测,并判断模型是否适合当前问题。
学习目标
- 理解特征、权重和偏置在预测中的作用
- 说明拟合直线如何通过减少残差平方和来降低预测误差
- 完成一次线性回归计算,并判断模型的适用条件与边界
模型在学习什么
线性回归为每个特征学习一个权重,并学习一个偏置。单特征模型可以写成:
其中, 是输入特征, 是预测值, 是权重, 是偏置。
权重表示特征增加一个单位时,预测值变化多少。例如, 表示 每增加 1,预测值增加 1.7。偏置是模型的基准位置,即 时的预测值。如果零点不在训练数据的合理范围内,就不宜直接赋予偏置业务含义。
当输入包含多个特征时,模型扩展为:
每个特征有独立权重。某个权重表示其他特征不变时,该特征增加一个单位,预测值变化多少。但这种系数关系不等于因果关系,不能仅凭权重判断某个因素是否真正导致结果变化。
拟合直线与残差
模型通过寻找误差较小的直线或高维平面完成训练。真实值与预测值之间的差称为残差:
残差为正,表示模型预测偏低;残差为负,表示模型预测偏高。线性回归通常使用最小二乘法,寻找使训练样本残差平方和最小的参数。常用的均方误差(MSE)为:
其中 是样本数量。平方操作使正负残差都产生非负损失,并对较大的残差给予更重的惩罚。
例如,使用广告投入预测销售额,得到四组样本:、、、,其中两个数分别表示广告投入与销售额,单位均为万元。线性回归会寻找一条尽量接近这些样本点的直线,而不要求直线穿过全部样本。
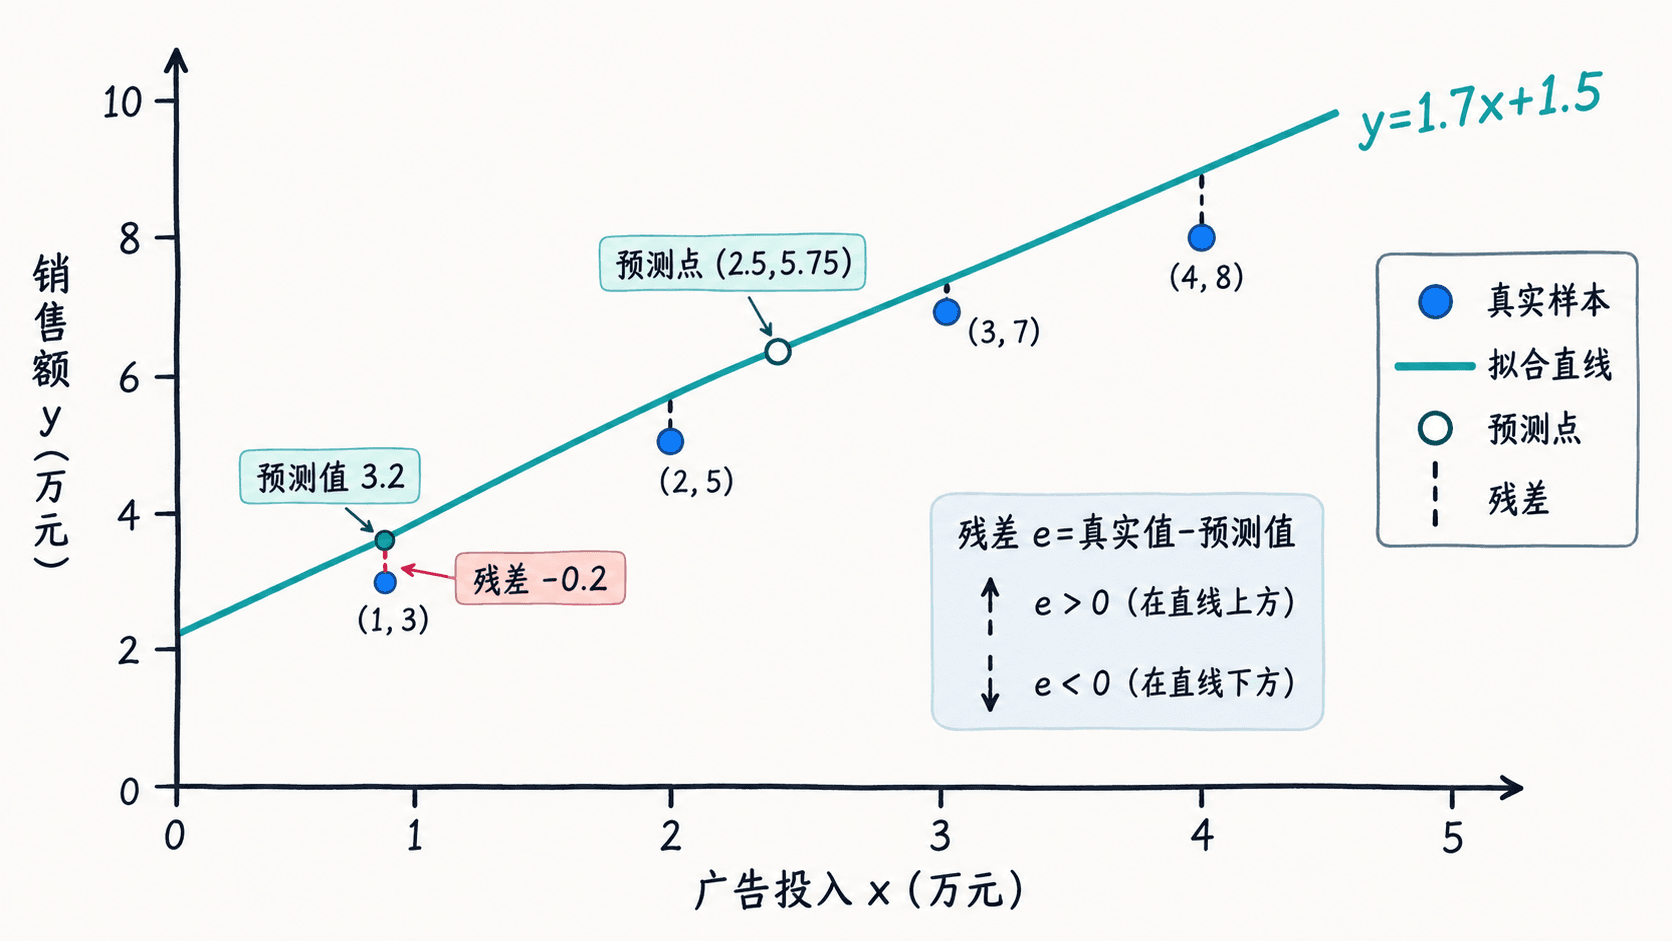
图中的竖直虚线表示残差。拟合完成后,不仅要检查误差大小,还要观察残差的分布。如果残差随特征增加而持续呈现弯曲趋势,说明简单直线可能没有充分表达数据关系。
用数据完成一次拟合
下面使用 Python 标准库,根据上述四组样本计算最小二乘拟合直线。单特征线性回归可以直接通过样本均值、协方差相关的求和项与平方偏差求出权重和偏置,无须额外安装机器学习库。
# 广告投入和销售额,单位均为万元
x = [1.0, 2.0, 3.0, 4.0]
y = [3.0, 5.0, 7.0, 8.0]

mean_x = sum(x) / len(x)
mean_y = sum(y) / len(y)

# 最小二乘法:计算斜率和截距
numerator = sum((xi - mean_x) * (yi - mean_y)
                for xi, yi in zip(x, y))
denominator = sum((xi - mean_x) ** 2 for xi in x)
w = numerator / denominator
b = mean_y - w * mean_x

# 用拟合参数计算预测值和训练集均方误差
predictions = [w * xi + b for xi in x]
mse = sum((yi - pred) ** 2
          for yi, pred in zip(y, predictions)) / len(y)

print(f'权重 w = {w:.2f}')
print(f'偏置 b = {b:.2f}')
print(f'x=2.5 的预测值 = {w * 2.5 + b:.2f}')
print(f'训练集 MSE = {mse:.4f}')
预期输出:
权重 w = 1.70
偏置 b = 1.50
x=2.5 的预测值 = 5.75
训练集 MSE = 0.0750
模型得到的直线为 。当广告投入为 2.5 万元时,预测销售额为 5.75 万元。对于第一组样本,实际销售额为 3 万元,预测值为 3.2 万元,残差为 万元。
验证时,可以把四组样本逐一代入拟合公式,计算残差平方,再取平均值,应得到 。这里使用训练样本自身计算误差,只能说明对已有数据的拟合程度,不能直接代表对新数据的预测能力。
适用条件与边界
线性回归适合连续目标和近似线性关系,例如根据面积预测房价、根据投入预测销售额。它的优势是计算简单、结果容易解释,但并不适合所有数据关系。
使用时重点检查以下情况:
- 明显非线性:如果残差呈系统性的弯曲趋势,直线可能欠拟合,可以考虑特征变换或加入非线性特征。
- 严重异常值:平方损失会放大较大残差的影响,少量极端样本可能明显改变拟合直线,应先核实数据来源。
- 特征高度共线:多个特征高度相关时,模型预测可能仍然可用,但单个权重容易不稳定,解释时需要谨慎。
- 训练范围外预测:示例中的广告投入只覆盖 1~4 万元。预测 5 万元甚至 20 万元投入时属于外推,原来的线性关系未必继续成立。
实际训练时,应将数据划分为训练集和验证集,在训练集上拟合参数,再用未参与拟合的数据检查 MSE、残差分布和预测偏差。如果训练误差很小,但验证误差明显增大,说明模型可能受到过拟合、异常数据或训练与验证数据分布差异的影响。
线性回归预测的是连续数值。如果目标是判断用户是否流失、邮件是否为垃圾邮件等离散类别,应选择适合分类任务的模型。对于连续数值预测,可以先用线性回归建立基准,再根据验证误差和残差特征判断是否需要更复杂的模型。