
机器学习与深度学习 / 系统课时
划分训练与测试集
划分训练与测试集
本课解决模型只在已见数据上表现良好、却无法判断泛化能力的问题。完成后,你能够建立独立测试集,使用分层抽样保持类别比例,并根据数据中的时间顺序和实体关系选择合适的划分方式,避免数据泄漏导致评估结果虚高。
学习目标
- 正确划分训练集和测试集,理解验证集的作用
- 使用分层抽样保持分类任务中的类别比例
- 识别时间和实体分组场景,避免不合理的随机划分
测试集不能参与开发
训练集用于学习模型参数,验证集用于调参和模型选择,测试集用于最终评价。测试集应模拟模型部署后遇到的未见数据,不能在开发过程中反复查看测试成绩并据此调整模型。
正确顺序是先划分数据,再使用训练数据拟合缺失值填充器、标准化器或特征选择器。验证集和测试集只能使用训练阶段得到的变换规则进行转换,不能参与这些规则的拟合。
如果需要调参,可以从训练部分进一步划分验证集,或只在训练部分进行交叉验证。确定模型、超参数和决策阈值之后,再使用保留的测试集进行最终评估。
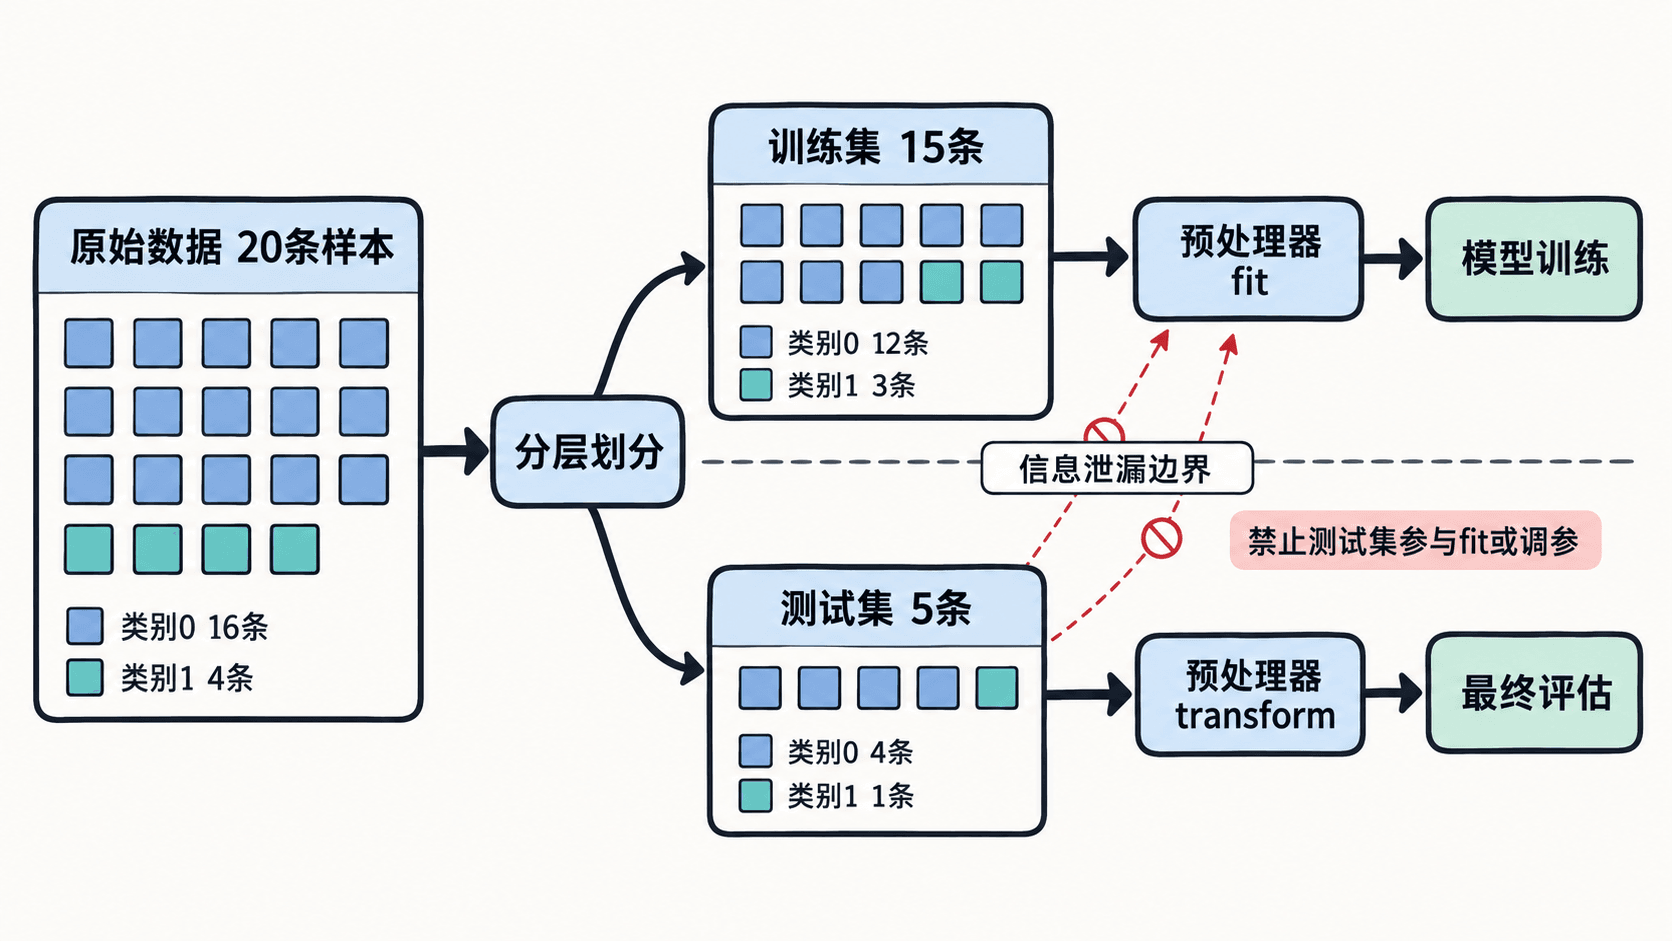
使用分层抽样保持类别比例
对于分类任务,如果数据中的不同类别数量差异较大,普通随机划分可能让少数类在测试集中数量过少,甚至完全缺失。分层抽样会按照标签类别分别抽取样本,使训练集和测试集尽量保持原始类别比例。
例如,20条数据中有16条类别0和4条类别1,类别比例为80%和20%。按照25%的测试集比例划分后,理想结果是训练集15条、测试集5条,其中测试集包含4条类别0和1条类别1。
下面使用分层划分保持类别比例。将代码保存为 split_demo.py,运行前确保已安装 scikit-learn。
from collections import Counter
from sklearn.model_selection import train_test_split

features = list(range(20))
labels = [0] * 16 + [1] * 4

x_train, x_test, y_train, y_test = train_test_split(
    features,
    labels,
    test_size=0.25,
    random_state=42,
    stratify=labels,
)

print("数量:", len(x_train), len(x_test))
print("训练类别:", Counter(y_train))
print("测试类别:", Counter(y_test))
这里的 test_size=0.25 表示将25%的样本分配给测试集;random_state=42 固定随机划分结果,便于复现;stratify=labels 指定按照目标标签进行分层抽样。函数会同步划分特征和标签,保持每条样本与其标签的对应关系。
运行命令:
python split_demo.py预期输出:
数量: 15 5
训练类别: Counter({0: 12, 1: 3})
测试类别: Counter({0: 4, 1: 1})训练集和测试集中的类别0、类别1均保持80%和20%的比例。random_state 保证使用相同数据和环境时可以复现划分,但不会自动防止数据泄漏。
不能随机划分的情况
分层随机划分适用于样本近似独立、允许打乱顺序的分类数据。但如果样本之间存在时间依赖或实体关联,即使类别比例正确,也可能得到过于乐观的评估结果。
- 时间预测:使用过去的数据训练、未来的数据测试。例如,用1月至9月的交易记录训练,用10月的记录测试,不能随机将10月记录混入训练集。需要滚动验证时可考虑
TimeSeriesSplit,并根据特征窗口设置必要的时间间隔。 - 实体重复记录:同一用户、设备或门店有多条记录时,应按实体分组划分,避免同一主体同时出现在训练集和测试集。可以使用
GroupShuffleSplit,传入用户ID或设备ID作为分组标识。 - 重复或高度相似样本:如果同一原始记录经过复制、切片或数据增强形成多个样本,应确保有关联的样本不会跨越训练和测试边界。
例如,一个用户有10条消费记录,随机划分可能让其中8条进入训练集、2条进入测试集。模型可能利用该用户的固定特征取得高分,却不能准确反映面对新用户时的效果。如果评估目标是预测新用户,应以用户ID为单位整体划分。
选择划分方式时,应先确定部署时模型面对的是随机新记录、未来时间段,还是全新实体,再让测试集尽可能模拟对应的数据分布。
检查划分是否正确
完成划分后,应检查样本数量、类别分布和数据隔离情况,而不能只确认程序正常运行。
- 数量检查:训练集与测试集的样本数量之和应等于原始样本数;本例为15加5等于20。
- 标签检查:分类任务比较各集合的类别数量与比例;本例两个集合都包含类别0和类别1。
- 边界检查:确保同一原始样本没有同时进入训练集和测试集;对于分组任务,还应检查两个集合的实体ID是否存在交集。
- 预处理检查:确认均值、标准差、缺失值填充值等统计量仅来自训练数据,测试集只执行已有规则的转换。
实际项目中应保存训练和测试的样本索引或划分规则,以便后续实验使用一致的评估数据。对于分类任务,除了整体准确率,还应根据需要查看各类别的召回率等指标,避免少数类表现被总体成绩掩盖。
划分比例并没有统一的最佳值,80%训练、20%测试或75%训练、25%测试都是常见起点。数据量较小时,应优先保证各类别有足够的评估样本,并考虑在训练部分使用交叉验证。测试集一旦确定,就应保持独立,直到最终评估阶段再使用。