
机器学习与深度学习 / 系统课时
理解函数与梯度
理解函数与梯度
训练模型时,损失函数会随着参数改变而变化。理解导数、偏导数与梯度,就能判断参数朝哪个方向调整,以及为什么沿负梯度更新通常会降低损失。本课用一个二元函数计算梯度,观察参数更新前后的函数值,并用数值差分验证结果。
学习目标
- 解释函数、导数、偏导数和梯度之间的关系。
- 理解梯度表示函数局部增长最快的方向,以及负梯度的下降意义。
- 通过 Python 计算梯度、更新参数,并用数值差分检查结果。
从函数到导数
函数描述输入与输出之间的关系。例如, 把输入 映射为它的平方。导数描述函数在某一点附近的瞬时变化率,也就是函数曲线在该点的切线斜率。
对于这个函数,导数为 。在 时,,意味着输入向右移动一个很小的距离时,函数值大约增加该距离的 6 倍。
例如,从 增加到 ,实际函数值变化为 ,而导数给出的局部近似值为 。两者非常接近。
导数的符号也有明确含义:正值表示函数在该点向右局部上升,负值表示局部下降,零表示该点的切线水平,但不一定是最小值。例如, 在 的导数为零,却不是极小值。
偏导数与梯度
机器学习中的损失函数通常依赖多个参数。对于多变量函数,偏导数表示固定其他变量时,函数沿某一个变量方向的变化率。
考虑二元函数:
分别对 和 求偏导数,可以得到:
将全部偏导数组成向量,就是梯度:
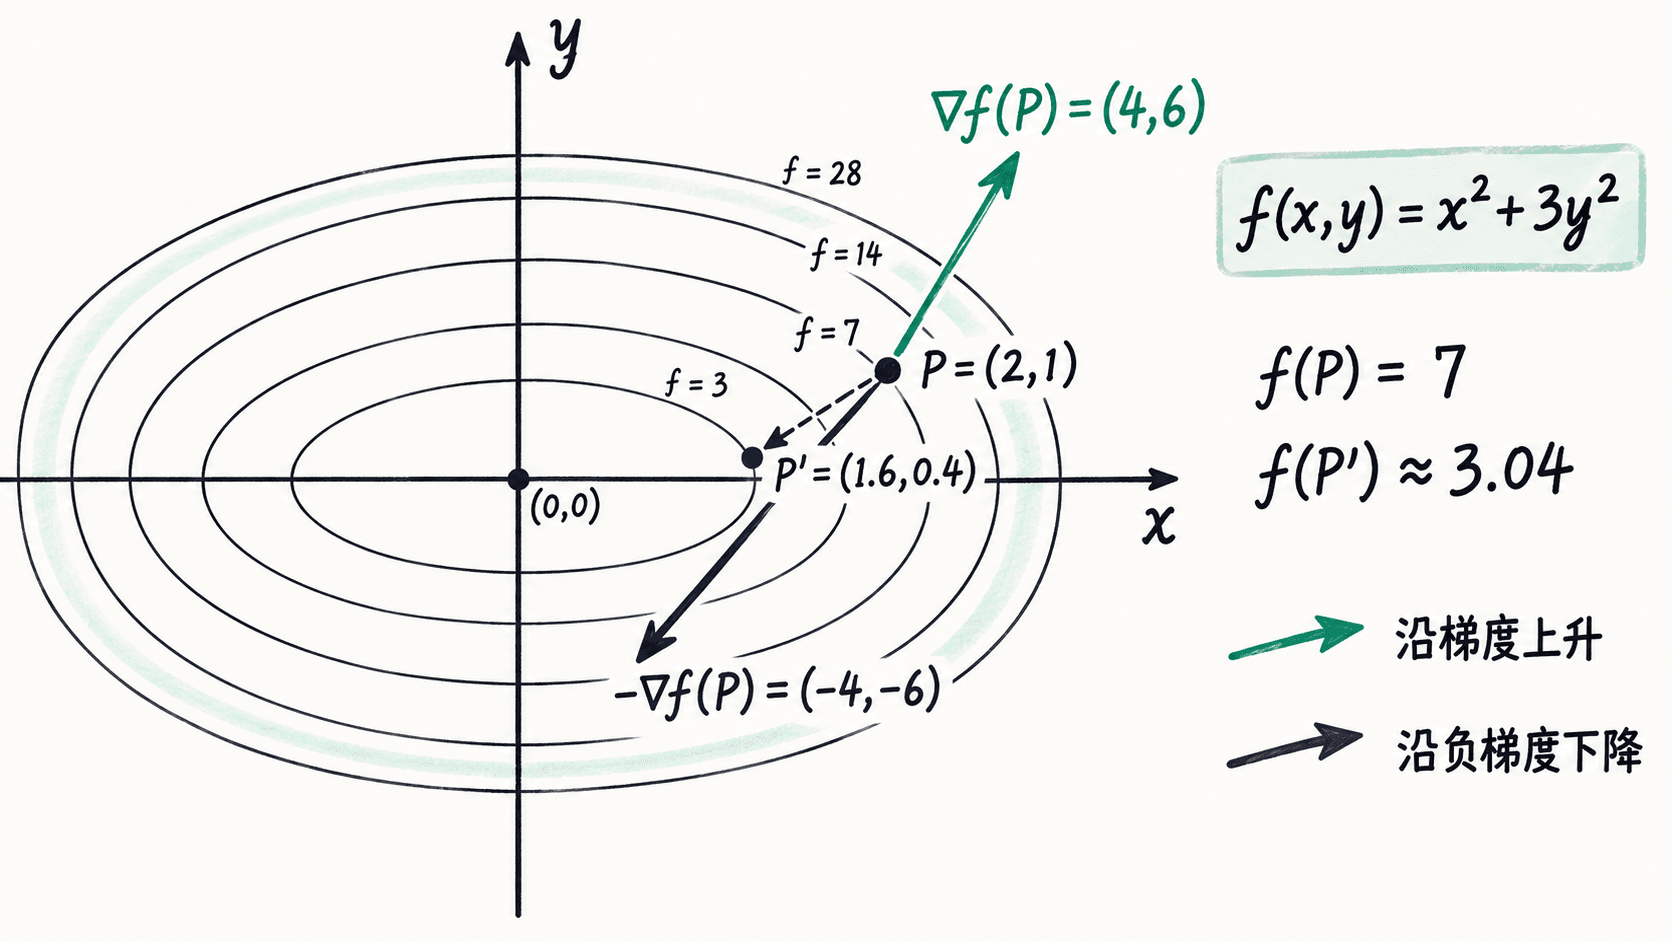
在点 ,梯度为 。这表示当两个变量分别增加很小的量时,函数对 方向的变化更敏感,因为该点沿 轴的偏导数绝对值更大。
在通常的欧氏距离度量下,梯度方向是函数值局部增长最快的方向,而负梯度方向是局部下降最快的方向。这里比较的是相同长度的微小移动,并不意味着任意大的更新步长都能降低函数值。
用代码计算梯度
梯度下降通过重复沿负梯度方向更新参数,尝试降低目标函数值。一次更新可以写为:
其中, 是学习率,控制每次更新的步长。下面使用 NumPy,在点 计算函数值和解析梯度,再取学习率 执行一次更新。
运行前确保 Python 环境已安装 NumPy。
import numpy as np

def function(x, y):
    return x ** 2 + 3 * y ** 2

def gradient(x, y):
    # 根据解析结果直接返回两个方向的偏导数
    return np.array([2 * x, 6 * y], dtype=float)

point = np.array([2.0, 1.0])
grad = gradient(point[0], point[1])

print("函数值:", function(point[0], point[1]))
print("梯度:", grad)

# 学习率控制沿负梯度方向移动的距离
new_point = point - 0.1 * grad
print("沿负梯度移动后的点:", new_point)
print("新的函数值:", function(new_point[0], new_point[1]))
预期输出:
函数值: 7.0
梯度: [4. 6.]
沿负梯度移动后的点: [1.6 0.4]
新的函数值: 3.0400000000000005
初始点的函数值为 。更新后,参数从 移动到 ,函数值下降到约 ,说明这一步更新确实使目标函数减小。
学习率并不是越大越好。如果把同一个点的学习率改为 ,新位置将变成 ,函数值反而上升到 。因此,负梯度提供的是局部下降方向,过大的步长仍可能越过低值区域。
数值梯度用于验证
当解析导数较复杂时,可以通过有限差分近似导数。常用的中心差分方法是在目标点左右各取一个距离为 的位置,用函数值之差估算变化率:
对于多变量函数,可以逐个变量计算中心差分,每次只扰动一个变量,其余变量保持不变。以 和点 为例,取 :
- 沿 方向:。
- 沿 方向:。
因此,数值梯度为 ,与代码计算的解析梯度一致。实际项目中可以逐个比较数值梯度与解析梯度或自动微分结果,检查求导实现是否正确。比较浮点数时应使用允许误差的方法,而不是直接要求完全相等。
动手验证
- 对函数 求导,并计算 时的导数。检查结果是否为 ,再解释这个数值对应的局部变化率。
- 求函数 在 的梯度,并尝试用中心差分分别验证两个分量。解析结果应为 ;将学习率设为 ,检查更新后的函数值是否从 降到 。
当解析梯度、数值差分和实际函数值变化能够互相印证时,就可以更有把握地判断梯度计算是否正确,以及当前学习率是否适合这次参数更新。