
AI Agent / 系统课时
组织 Agent 项目目录
组织 Agent 项目目录
这一课把 Agent 项目按模型、工具、状态、流程、评测和接口拆成清晰边界,并给出一套可直接创建的最小目录。目标不是追求目录数量,而是让依赖方向可控、模块职责稳定。
学习目标
- 按变化原因拆分模型、工具、状态、流程、评测和接口代码。
- 建立单向依赖规则,避免工作流与基础模块相互引用。
- 用最小目录起步,并知道项目变大后该继续拆哪里。
先按变化原因拆目录
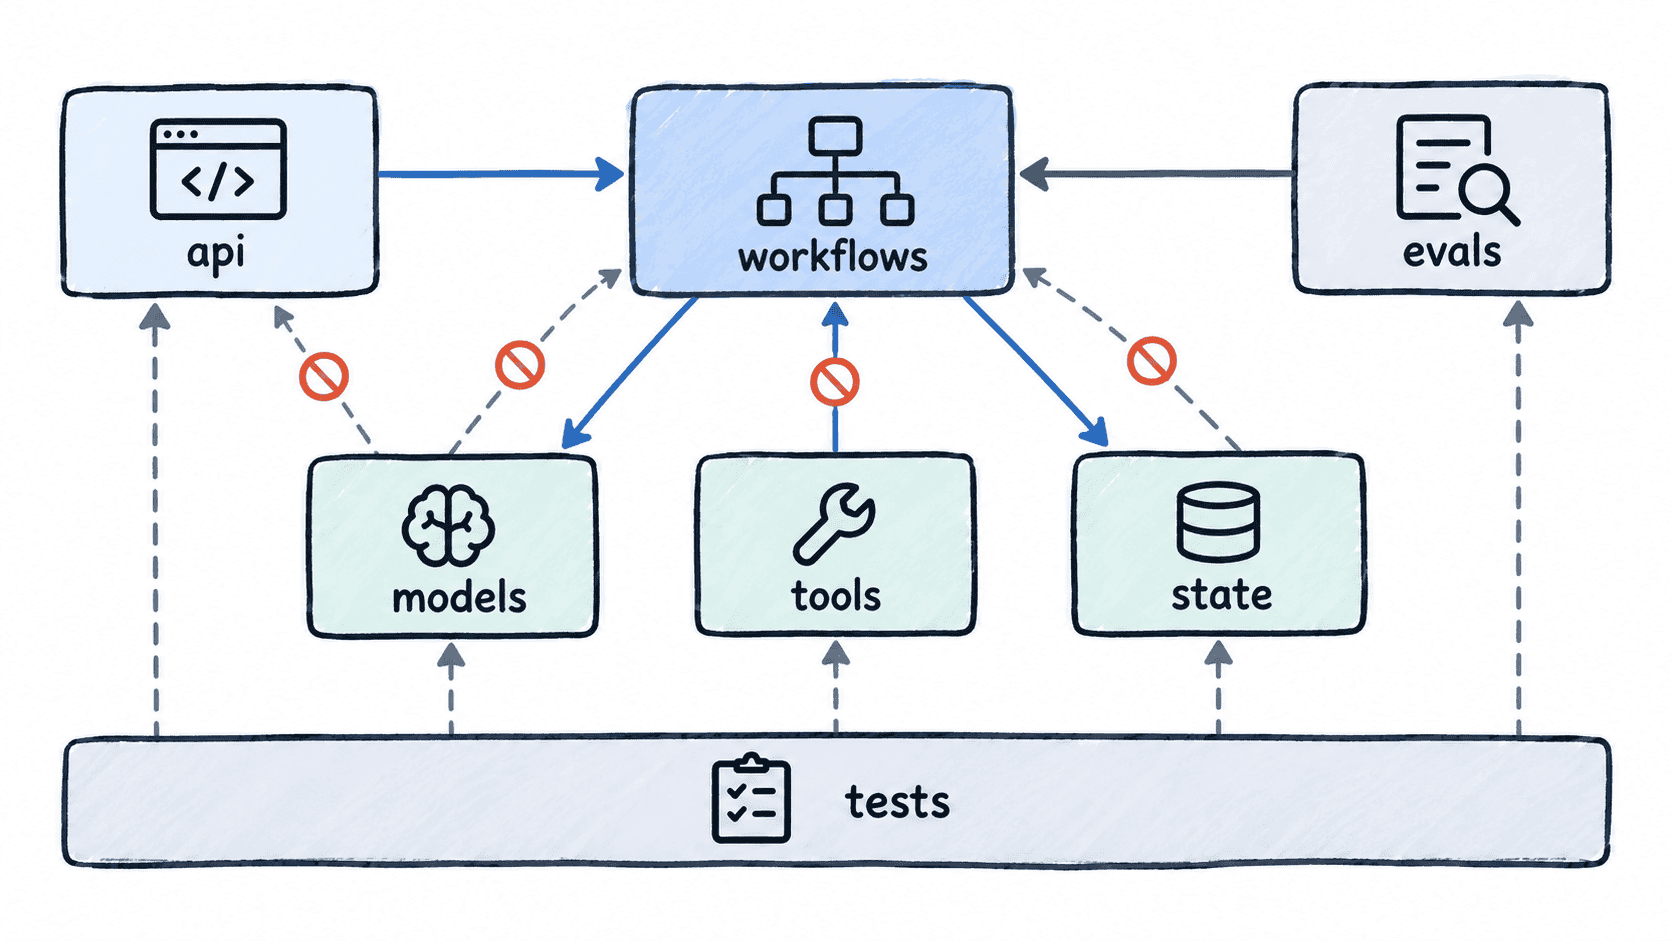
目录设计的核心不是“文件放得整齐”,而是把不同变化频率的代码隔开。模型适配会随供应商变化,工具会随外部能力变化,状态定义会随任务上下文变化,工作流负责组合这些能力,接口层只处理 HTTP 或 CLI 边界,评测则应尽量独立于生产入口。
| 目录 | 主要职责 | 不应承载 |
|---|---|---|
models/ |
模型客户端、供应商适配、请求与响应转换 | 业务流程编排 |
tools/ |
搜索、数据库、文件等可调用能力 | Agent 主流程 |
state/ |
会话状态、任务状态、持久化结构 | HTTP 路由 |
workflows/ |
节点编排、决策、重试与流程控制 | 供应商细节 |
evals/ |
数据集、评测器、回归脚本 | 在线请求入口 |
api/ |
HTTP/CLI 入参、鉴权、响应转换 | 模型和工具实现 |
建立最小目录
下面创建最小 src 目录和可运行入口。把脚本保存为 init_layout.py,在项目根目录运行。脚本只新建缺失文件,重跑会保留已有内容。
from pathlib import Path

root = Path("agent_app")
files = {
    "src/agent/__init__.py": "",
    "src/agent/models/__init__.py": "",
    "src/agent/tools/__init__.py": "",
    "src/agent/state/__init__.py": "",
    "src/agent/workflows/__init__.py": "",
    "src/agent/api/__init__.py": "",
    "src/agent/workflows/main.py": 'def run():\n    return "agent-layout-ready"\n',
    "src/agent/api/cli.py": "from agent.workflows.main import run\n\nif __name__ == '__main__':\n    print(run())\n",
    "evals/.gitkeep": "",
    "tests/.gitkeep": "",
}

for name, content in files.items():
    path = root / name
    path.parent.mkdir(parents=True, exist_ok=True)
    try:
        with path.open("x", encoding="utf-8") as file:
            file.write(content)
    except FileExistsError:
        pass
进入 agent_app/src,执行 python -m agent.api.cli,预期输出 agent-layout-ready。从 src 目录运行是这个小例子的约定。真正打包时,可通过 pyproject.toml 声明包所在目录并做可编辑安装,届时就不必切换到 src。前两课的模型客户端可以移到 models/,移动后应把对应 import 一起改成包内路径。
约束依赖方向
推荐把依赖方向固定为 api -> workflows -> models/tools/state。接口层负责接收外部请求并调用工作流;工作流可以组合模型、工具和状态,但基础模块不反向导入工作流或接口层。
评测代码可以调用工作流来跑离线样本,却不应被线上代码依赖。测试可以按需要访问各模块,但测试辅助代码也不要混回生产目录。这样做能显著减少循环依赖,并让模型客户端、工具或接口框架可以独立替换。
什么时候继续拆分
当某个目录开始同时承担两个明显不同的变化原因时再拆。例如 tools/ 同时包含数据库、浏览器和内部服务调用,可以继续按领域分子目录;workflows/ 出现多个完全独立的 Agent 流程时,也可以按业务场景拆开。
反过来,如果项目只有一个模型、两个工具和一条流程,就没有必要一开始引入插件系统、依赖注入容器或复杂分层。目录结构的验收标准是:新人能快速找到代码,修改一个模块不会迫使无关模块一起变化,依赖方向也能保持单向。