
AI Agent / 系统课时
重排并组装上下文
重排并组装上下文
检索拿到的片段并不等于可以直接交给模型的上下文。本课把候选片段按相关性、来源可信度和重复度重新排序,再控制总长度并按来源组织,最终得到更紧凑、可解释、适合生成答案的上下文。
学习目标
- 理解为什么向量检索后的候选片段还需要重排与去重
- 能按分数、来源和长度预算筛选高价值片段
- 能把最终片段组装成带来源标记的模型上下文
从候选片段到最终上下文
一次 RAG 检索通常会返回多个候选片段,其中可能同时存在高相关片段、内容重复片段和只命中少量关键词的噪声。直接把它们全部拼进提示词,会挤占上下文窗口,还可能让模型被低价值证据干扰。
更稳妥的顺序是:先对候选片段重排,再限制重复来源或相似内容,然后依据 Token 或字符预算截断,最后保留来源标记后再交给模型。
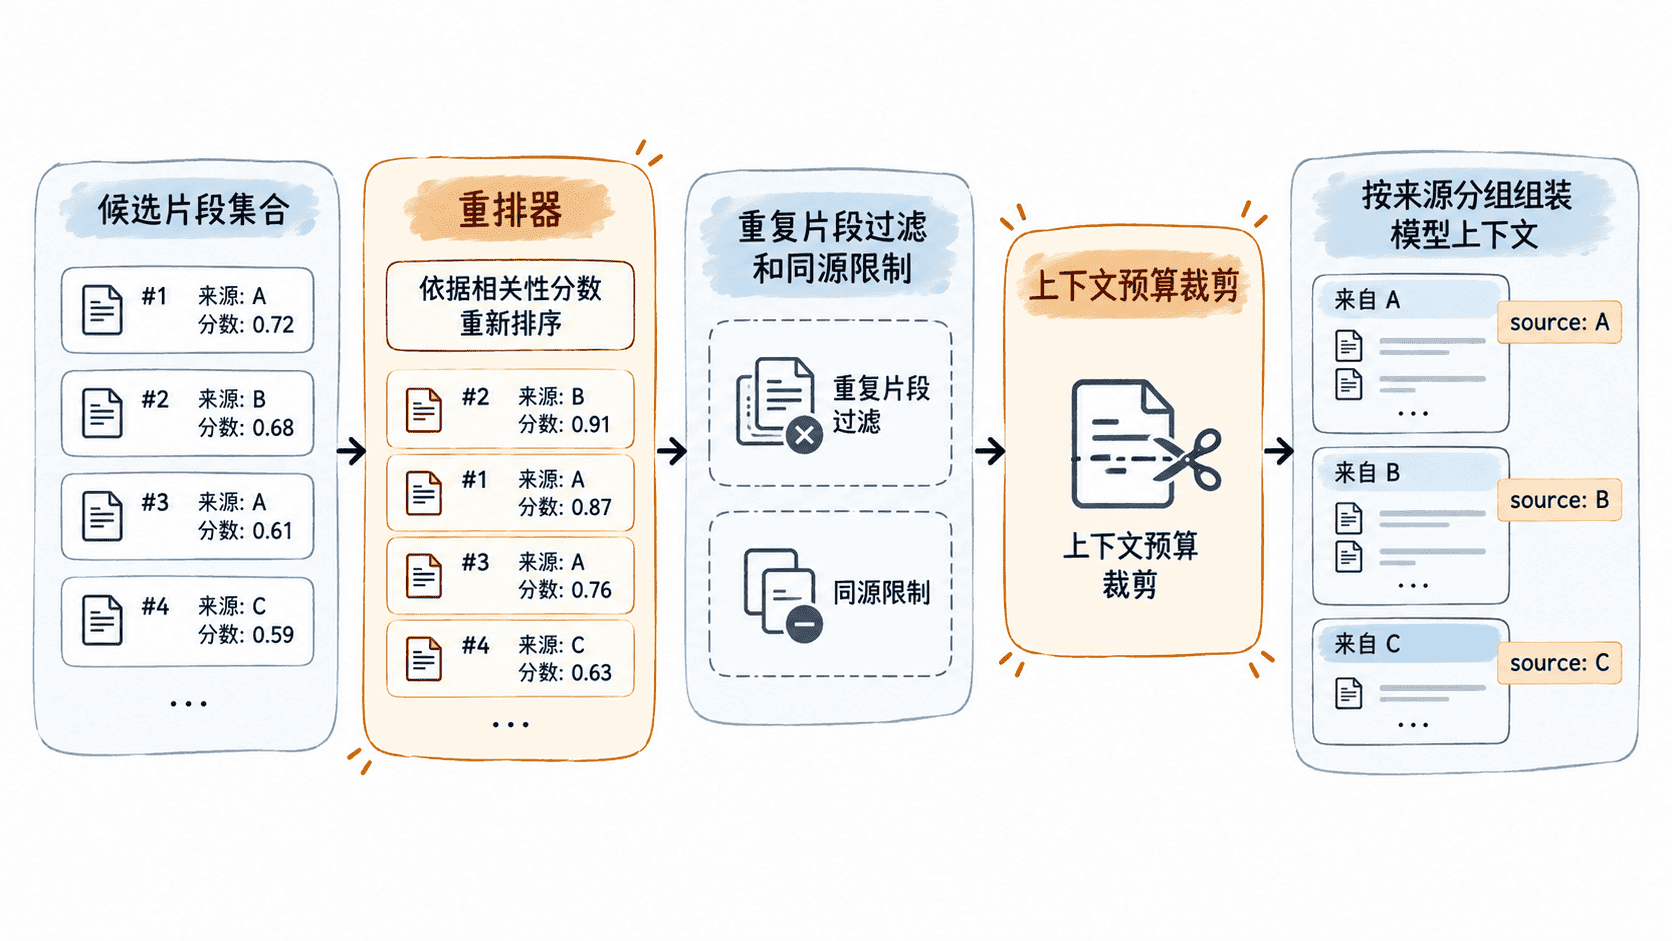
用一个主流程完成筛选与组装
把代码保存为 rag_context.py。使用上一课的排序结果,先重新校验权限和活动版本,再按文档版本去除相同正文。示例把候选打包成 JSON 数据,给实际入选的片段分配本次请求专用编号。模型只接收编号与正文,完整来源映射由服务端保管。
python
import json

from rag_index import load_catalog
from rag_retrieve import can_read, demo_scope, retrieve


def build_context(ranked_rows, scope, limit=2, max_chars=180):
    if type(limit) is not int or limit < 0 or type(max_chars) is not int or max_chars < 0:
        raise ValueError("invalid context budget")
    selected, citation_map, seen = [], {}, set()
    payload = ""
    for row in ranked_rows:
        if len(selected) == limit:
            break
        if not can_read(row, scope):
            continue
        dedup = (row["doc_id"], row["revision"], row["text"])
        if dedup in seen:
            continue
        label = f"S{len(selected) + 1}"
        item = {"id": label, "text": row["text"]}
        proposed = json.dumps([*selected, item], ensure_ascii=False, separators=(",", ":"))
        if len(proposed) > max_chars:
            continue
        selected.append(item)
        citation_map[label] = row
        seen.add(dedup)
        payload = proposed
    return payload, citation_map


if __name__ == "__main__":
    scope = demo_scope()
    rows = retrieve("退款多久到账", load_catalog(), scope)
    context, sources = build_context(rows, scope)
    print(context)
    print([(label, row["source"], row["revision"]) for label, row in sources.items()])
预期输出
text
[{"id":"S1","text":"退款通常在 3 到 5 个工作日到账。"},{"id":"S2","text":"退款到账异常请核对支付渠道。"}]
[('S1', 'kb/refund', 'v2'), ('S2', 'kb/support', 'v2')]
控制预算与来源覆盖
预算包含实际序列化后的字符,编号、引号、分隔符和转义字符都计入。真实应用要按目标模型的 tokenizer 计算整个请求,为应用规则、历史、当前问题、工具定义和输出预留空间。片段放不下时可以跳过,或在组装前按适合的结构拆分并保留新的原文区间。
重排可以使用专用相关性模型,也可以从当前名次开始。保留同一来源的不同片段有时是必要的,例如结论和例外条款相邻。去重时还应区分不同版本和不同来源的证据,避免把冲突掩盖。组装后的 JSON 属于检索数据,其中包含的指令文字无权改变应用规则。可引用集合只从实际发送的证据建立。
按自己的节奏,确认真正理解。