
AI Agent / 系统课时
实现可追溯回答
实现可追溯回答
RAG 的答案不仅要“看起来正确”,还要能指出依据来自哪里,并在证据不足时停止猜测。本课实现一套最小可追溯输出协议:上下文带来源编号,答案显式返回引用,并在缺少足够证据时给出拒答结果。
学习目标
- 区分本次请求的短编号和真实文档版本、片段与位置
- 验证答案中的引用是否真的存在于当前上下文
- 在证据不足或无法支持结论时返回明确拒答
先定义可追溯输出协议
最小协议至少需要三部分:答案正文、引用列表和状态字段。引用应指向当前请求实际提供给模型的证据,而不是让模型自行编造 URL、文件名或数据库 ID。
推荐让上下文片段使用 [S1]、[S2] 这类短编号,模型只返回编号;应用层再把编号映射到真实来源。这样可以把“生成答案”和“展示来源”分离,避免模型篡改元数据。
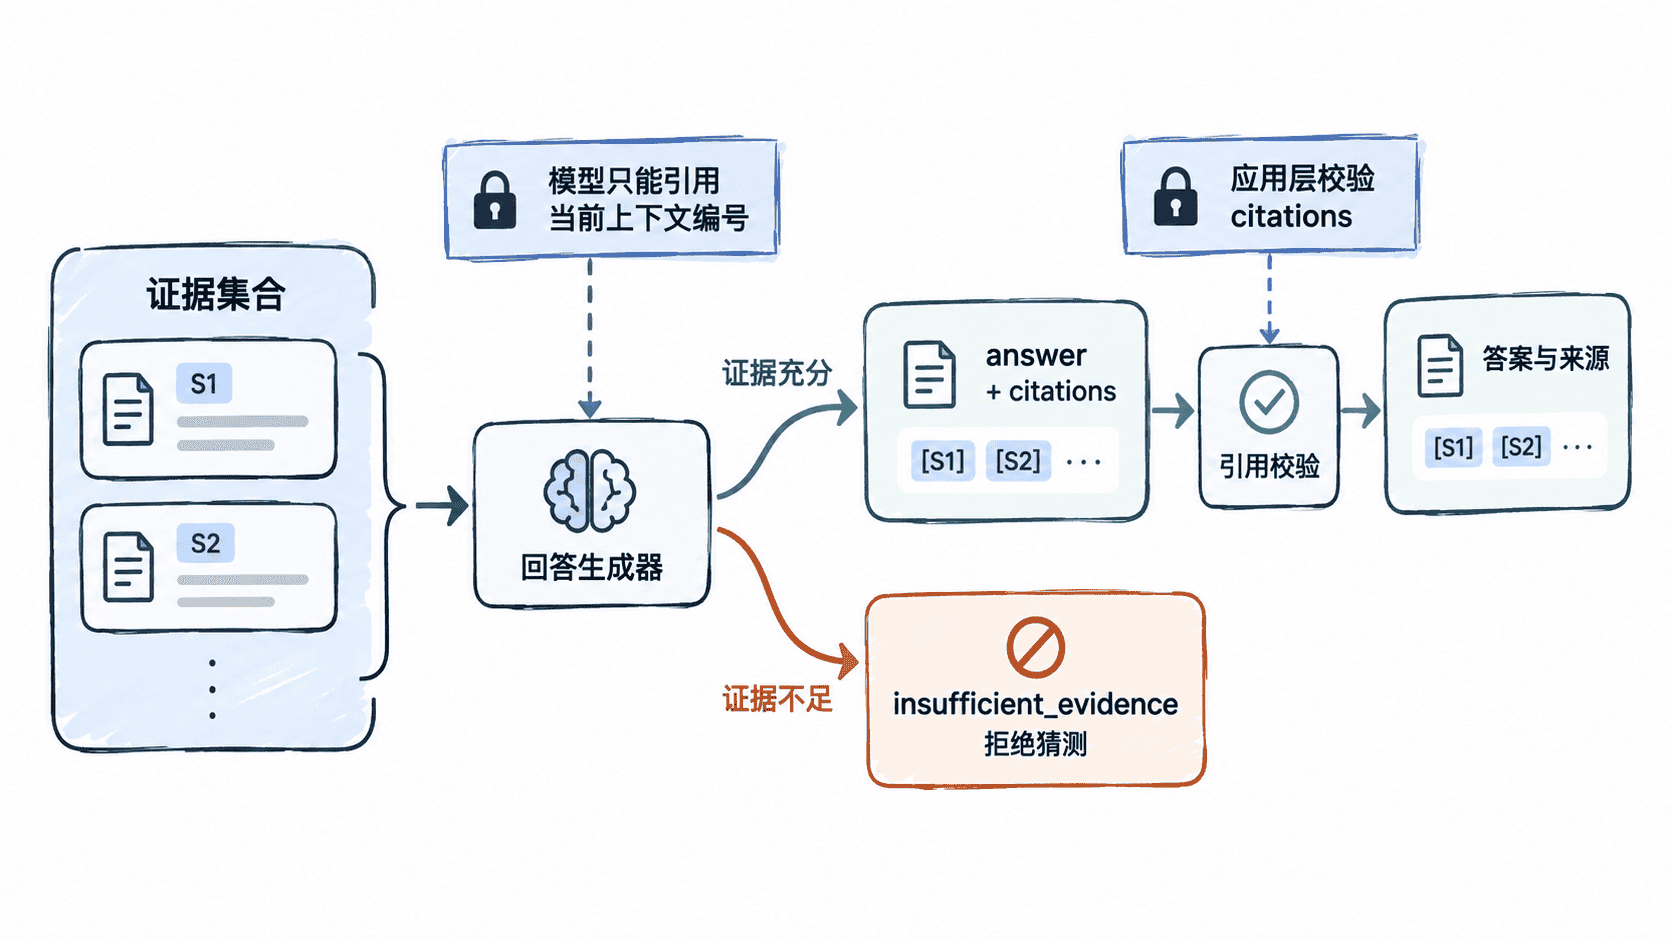
用应用层门禁约束回答
把代码保存为 rag_answer.py。示例把问题限定为“退款到账周期”。应用从可信配置选定要回答的字段。经过人工维护的事实表记录哪些片段支持该字段和值,模型仅提议数值和引用。代码用固定模型响应展示放行和拒绝路径,无需联网。开放领域问答没有这张事实表,需要另外设计主张级证据核验。
python
from rag_context import build_context
from rag_index import load_catalog
from rag_retrieve import can_read, demo_scope, retrieve


def verify_answer(field, sent_sources, scope, facts, output):
    def rejected(status):
        return {"status": status, "answer": "现有证据不足,无法可靠回答。", "citations": []}

    if output is None or (isinstance(output, dict) and output.get("status") == "abstain"):
        return rejected("insufficient_evidence")
    if (
        not isinstance(output, dict) or output.keys() != {"status", "value", "citations"}
        or output["status"] != "answer"
        or not isinstance(output["value"], str) or not output["value"].strip()
    ):
        return rejected("invalid_answer")

    eligible = {label: row for label, row in sent_sources.items() if can_read(row, scope)}
    cited = output["citations"]
    if (
        not isinstance(cited, list) or not cited
        or any(not isinstance(label, str) or label not in eligible for label in cited)
        or len(set(cited)) != len(cited)
    ):
        return rejected("invalid_citation")

    supported = {
        label: facts[(row["chunk_id"], field)] for label, row in eligible.items()
        if (row["chunk_id"], field) in facts
    }
    if len(set(supported.values())) != 1:
        return rejected("insufficient_evidence")
    if any(supported.get(label) != output["value"] for label in cited):
        return rejected("insufficient_evidence")

    return {
        "status": "ok", "answer": f"退款通常在 {output['value']} 到账。",
        "citations": [
            {key: eligible[label][key] for key in ("source", "revision", "start", "end")}
            for label in cited
        ],
    }


if __name__ == "__main__":
    scope = demo_scope()
    catalog = load_catalog()
    rows = retrieve("退款多久到账", catalog, scope)
    _, sent_sources = build_context(rows, scope)
    refund = next(row for row in catalog if
                  (row["tenant_id"], row["doc_id"], row["revision"]) == ("acme", "refund", "v2"))
    # 模拟一条审核后写入的事实。运行时不会从模型输出填充事实表。
    field = "refund_period"
    facts = {(refund["chunk_id"], field): "3 到 5 个工作日"}
    good = {"status": "answer", "value": "3 到 5 个工作日", "citations": ["S1"]}
    for reply in (good, {**good, "citations": ["S2"]}, {**good, "citations": ["S9"]}):
        print(verify_answer(field, sent_sources, scope, facts, reply)["status"])
预期输出
text
ok
insufficient_evidence
invalid_citation
明确拒答条件
编号存在只证明该片段进入了上下文。示例中的 S2 提到异常时核对支付渠道,无法支持“3 到 5 个工作日”的结论。即使检索最高分很高,也可能缺少关键证据、用错地区或版本,或包含未解决的冲突。拒答时可提示用户提供缺失条件,或转给具备授权的人工核验流程。
对于有多个事实的回答,应逐项绑定引用并核对支持关系。先过滤不适用的来源,再核对不同来源是否冲突。相似度和 RRF 排名只适合作为筛选信号。用代表性的可答、不可答、旧版本和冲突样本评估错误回答率及过度拒答率。展示来源之前重新校验权限,通过应用持有的文档 ID、版本和原文区间定位证据。
按自己的节奏,确认真正理解。