
AI Agent / 系统课时
执行检索与过滤
执行检索与过滤
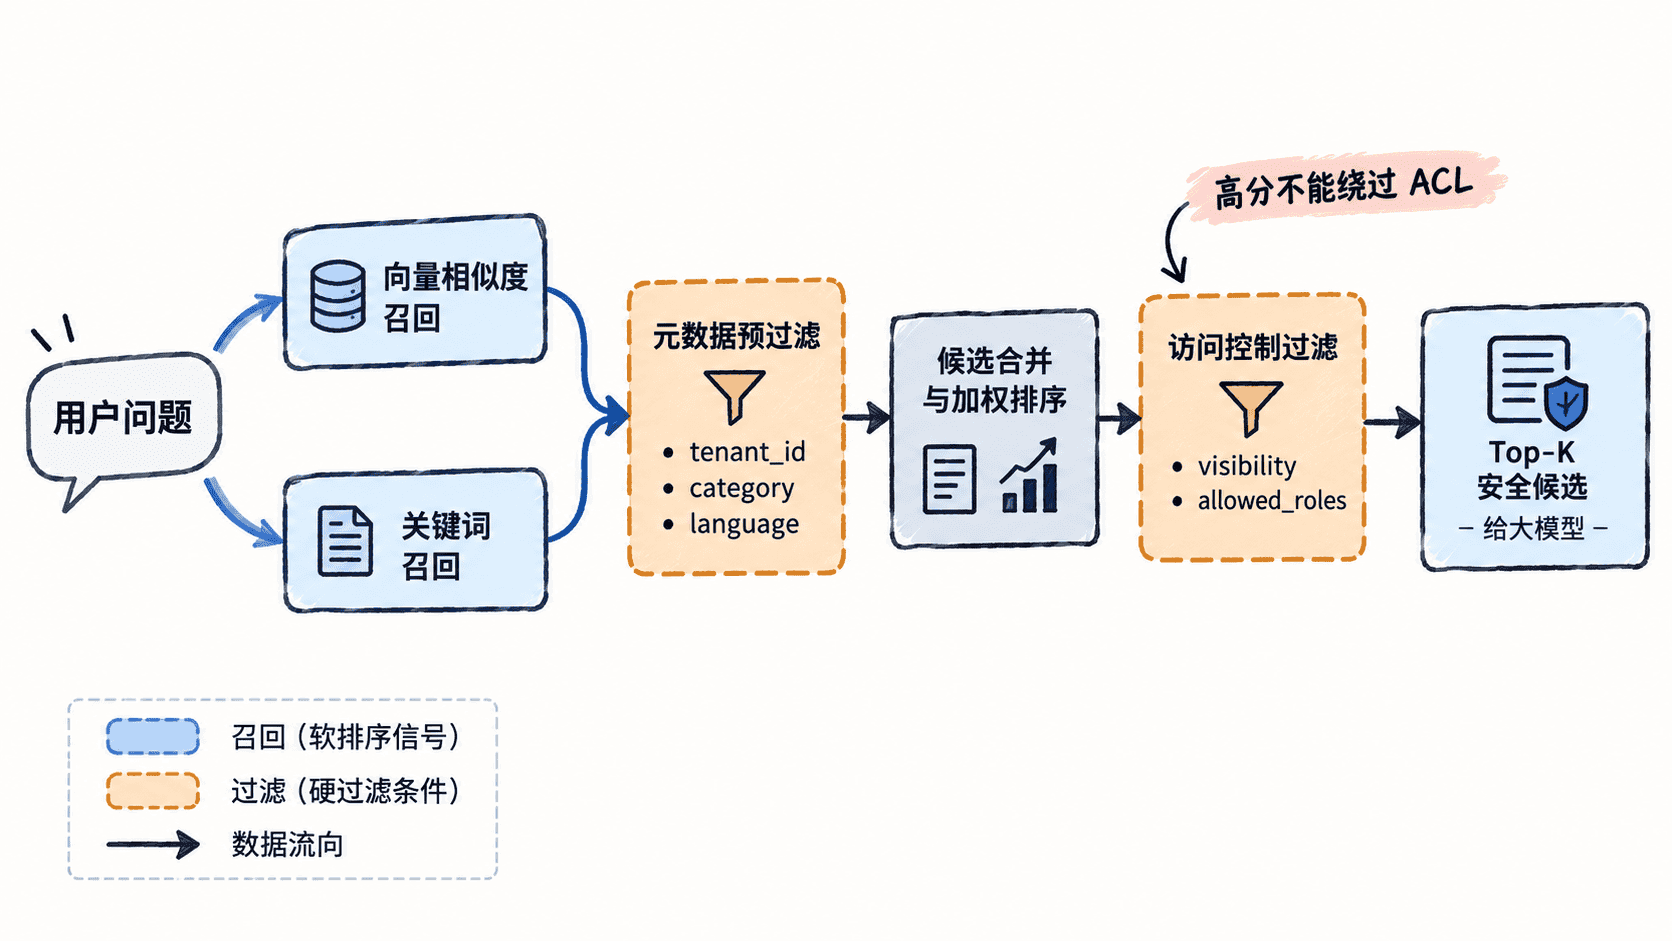
这一节把用户问题转成检索请求,同时使用向量相似度、关键词得分和元数据条件召回候选内容。重点不是单纯算一个分数,而是在排序前后都守住租户、分类和角色边界,得到可安全交给模型的上下文。
学习目标
- 组合向量相似度与关键词命中,避免只依赖单一召回信号。
- 使用元数据和访问范围过滤候选内容。
- 根据分数、过滤条件和候选数量验证检索结果是否符合预期。
检索不是只做一次相似度排序
一个实用的 RAG 检索请求通常同时包含三类信号:语义相似度负责找“意思相近”的内容,关键词负责保留产品名、错误码等精确词,元数据负责限制租户、知识分类、语言或时间范围。权限条件属于硬约束,不能因为某条内容相似度高就绕过。
用一个主示例组合三种条件
把代码保存为 rag_retrieve.py,先运行上一课的 rag_index.py 生成目录。示例分别生成向量排名和关键词排名,再用倒数排名融合(RRF)。候选在任何评分之前已经过硬性权限筛选。应用从已验证身份及当前 ACL 创建 Scope,模型和前端请求不能替换这些字段。
python
import re
from dataclasses import dataclass

from rag_index import build_flat, embed, load_catalog


@dataclass(frozen=True)
class Scope:
    tenant_id: str
    roles: frozenset[str]
    revisions: dict[str, str]


def can_read(row, scope):
    if row["tenant_id"] != scope.tenant_id:
        return False
    if scope.revisions.get(row["doc_id"]) != row["revision"]:
        return False
    if row["visibility"] == "tenant":
        return True
    return row["visibility"] == "roles" and bool(scope.roles.intersection(row["allowed_roles"]))


def bigrams(text):
    chars = re.sub(r"\W+", "", text.lower())
    return {chars[i:i+2] for i in range(len(chars) - 1)}


def retrieve(query, rows, scope, limit=4):
    if type(limit) is not int or limit < 1:
        raise ValueError("positive result limit required")
    candidates = [row for row in rows if can_read(row, scope)]
    if not candidates or not query.strip():
        return []
    index = build_flat(candidates)
    vector = embed(query)
    dense = []
    if vector is not None:
        scores, positions = index.search(vector.reshape(1, -1), len(candidates))
        positive = [(float(s), int(p)) for s, p in zip(scores[0], positions[0]) if p >= 0 and s > 0]
        dense = [
            p for _, p in sorted(positive, key=lambda entry: (-entry[0], candidates[entry[1]]["chunk_id"]))
        ]

    features = bigrams(query)
    overlap = [len(features & bigrams(row["text"])) for row in candidates]
    keyword = sorted(
        (p for p, hit in enumerate(overlap) if hit),
        key=lambda p: (-overlap[p], candidates[p]["doc_id"], candidates[p]["chunk_id"]),
    )
    fused = {}
    for ranking in (dense[:limit], keyword[:limit]):
        for rank, position in enumerate(ranking, start=1):
            fused[position] = fused.get(position, 0.0) + 1 / (60 + rank)
    positions = sorted(fused, key=lambda p: (-fused[p], candidates[p]["chunk_id"]))
    return [candidates[p] for p in positions[:limit]]


def demo_scope(roles=frozenset({"support"})):
    return Scope("acme", roles, {"refund": "v2", "support": "v2", "finance": "v2", "shipping": "v2"})


if __name__ == "__main__":
    catalog = load_catalog()
    for roles in (frozenset({"support"}), frozenset()):
        results = retrieve("退款多久到账", catalog, demo_scope(roles))
        print([(row["tenant_id"], row["doc_id"], row["revision"]) for row in results])
预期输出
text
[('acme', 'refund', 'v2'), ('acme', 'support', 'v2')]
[('acme', 'refund', 'v2')]
权限过滤与排序各自处理什么
同样含“退款”和“到账”的外租户条目、旧版制度以及财务内部条目不会进入支持人员的候选集。只有权限已通过的候选才参与排序。业务上还可先按可信的知识库、语言和适用时间过滤,普通语义相关性仍交给召回与排序。模型只接收授权片段及短编号,ACL 留在服务端。
RRF 使用各路排序名次累加分数,能避开向量与关键词原始分值量纲不同的问题。课堂取常数 60 和每路有限候选。排名只表示检索偏好,不能解释为概率或答对的把握。精确索引每次查遍过滤后的集合,便于验证。部署 ANN 时,应先验证所用索引与客户端如何执行权限过滤;若只能全局召回后再删除结果,应评估召回缺口、隔离和日志边界,不能把未经授权的候选暴露给生成端。缓存也需要绑定身份权限、索引版本和查询条件,避免串用。
按自己的节奏,确认真正理解。