
AI Agent / 系统课时
构建长期记忆
构建长期记忆
长期记忆解决的是跨轮次、跨会话复用信息的问题:先从对话中提取稳定事实,再写入可持久化存储,需要时按条件检索并注入当前上下文。本节用 SQLite 完成一个最小可运行版本,并说明哪些信息值得保存、如何避免记忆越积越乱。
学习目标
- 区分可长期复用的事实与一次性对话内容
- 将提取后的事实持久化,并按关键词检索
- 为长期记忆加入来源、去重和更新策略,减少错误记忆
先确定什么值得长期保存
适合长期记忆的内容通常具有稳定性和复用价值,例如用户明确表达的长期偏好、项目固定约束、已经确认的事实或长期目标。一次性的上下文、临时口令、瞬时状态和未经确认的模型推断不应直接写入长期存储。
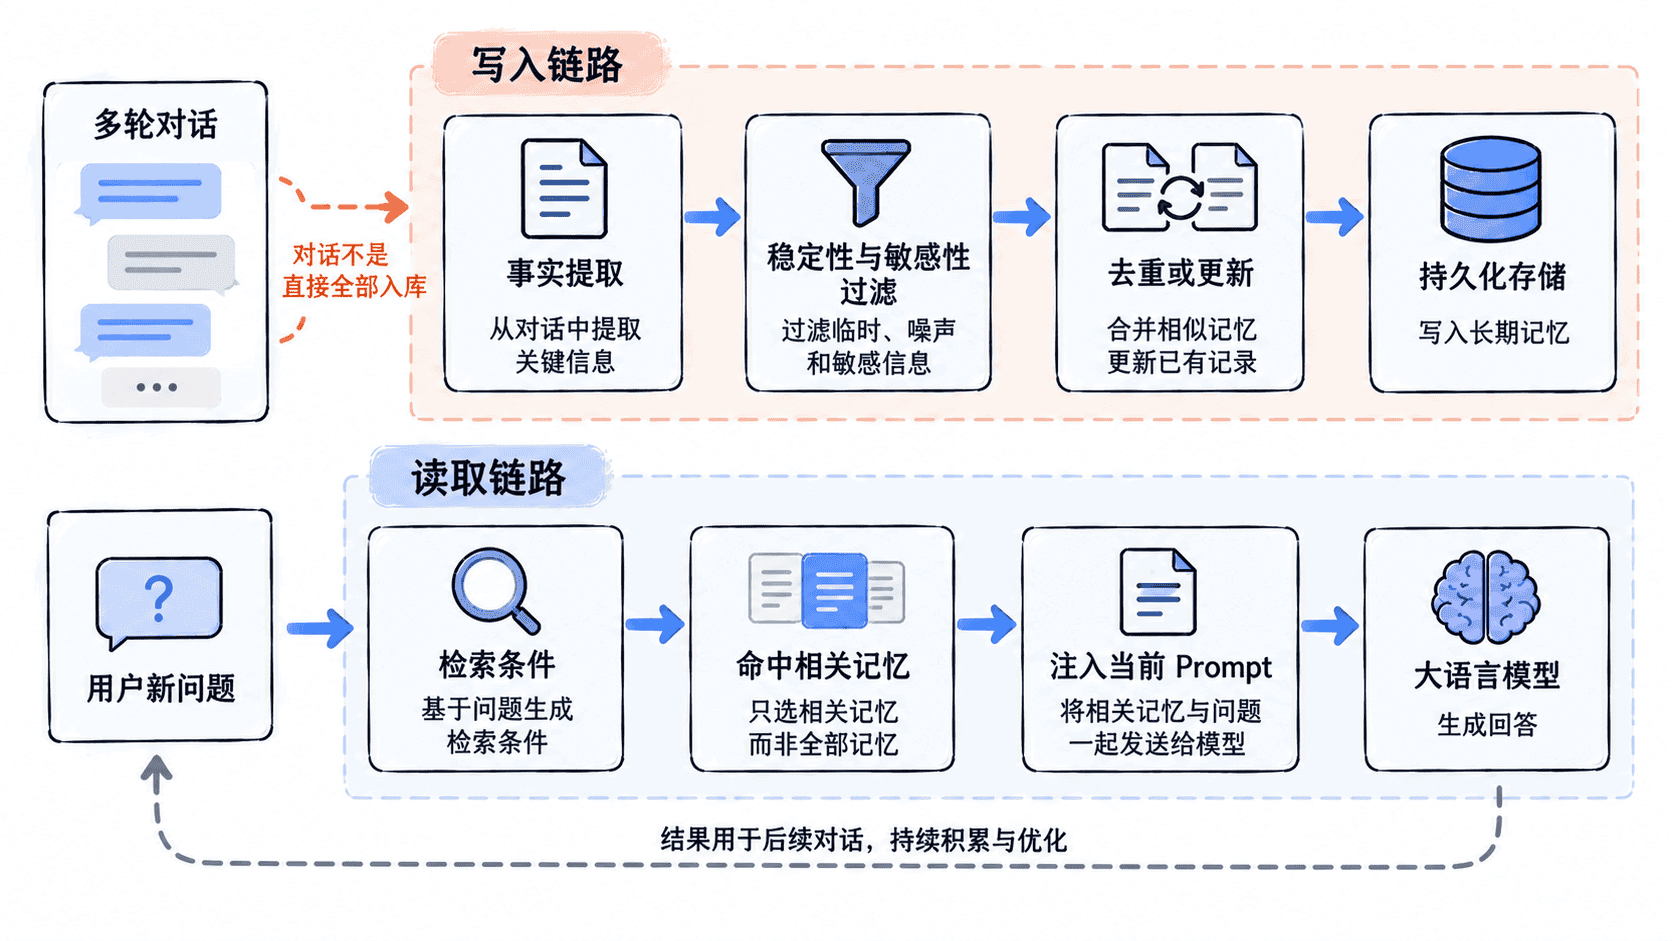
一个稳妥的写入流程是:先提取候选事实,再判断是否稳定、是否允许保存,然后按业务键去重或更新。读取时也不要把整个数据库塞给模型,而是只召回与当前问题相关的少量记录。
用 SQLite 保存可复用事实
以下将一个已确认的事实按租户、用户和事实键保存,并记录来源和过期时间。查询用字面子串匹配,限制结果数量。
import sqlite3
from contextlib import closing
from pathlib import Path
from tempfile import TemporaryDirectory

def init_db(conn):
    conn.execute("""
        CREATE TABLE IF NOT EXISTS memory (
            tenant TEXT NOT NULL, user_id TEXT NOT NULL, key TEXT NOT NULL,
            value TEXT NOT NULL, source TEXT NOT NULL, expires_at INTEGER,
            PRIMARY KEY (tenant, user_id, key)
        )
    """)

def remember(conn, tenant, user_id, key, value, source, expires_at=None):
    with conn:
        conn.execute("""
            INSERT INTO memory(tenant,user_id,key,value,source,expires_at)
            VALUES (?,?,?,?,?,?)
            ON CONFLICT(tenant,user_id,key) DO UPDATE SET
                value=excluded.value, source=excluded.source, expires_at=excluded.expires_at
        """, (tenant,user_id,key,value,source,expires_at))

def search(conn, tenant, user_id, keyword, now):
    if not keyword.strip():
        return []
    return conn.execute("""
        SELECT key,value,source FROM memory
        WHERE tenant=? AND user_id=?
          AND (expires_at IS NULL OR expires_at>?)
          AND (instr(key,?)>0 OR instr(value,?)>0)
        ORDER BY key LIMIT 10
    """, (tenant,user_id,now,keyword,keyword)).fetchall()

with TemporaryDirectory() as folder:
    database = Path(folder) / "memory.db"
    with closing(sqlite3.connect(database)) as conn:
        init_db(conn)
        remember(conn,"t1","u1","hotel","地铁旁的酒店","msg-1")
        remember(conn,"t1","u2","hotel","机场酒店","msg-2")
        remember(conn,"t1","u1","temporary","暂住酒店","msg-3",expires_at=100)
    with closing(sqlite3.connect(database)) as conn:
        print(search(conn,"t1","u1","酒店",now=100))
        print(search(conn,"t1","u1","%",now=100))
重开数据库后只召回 [('hotel', '地铁旁的酒店', 'msg-1')],百分号查询得到空数组。另一个用户的同名键和到期记录均未进入结果。示例数据库在临时目录中。真实服务要从认证信息取得租户、用户,并另外实现删除和清理。时间过滤只限制读取,过期记录仍需后台删除。
从对话中提取再写入
生产级 Agent 通常会让模型输出结构化候选事实,例如 {"key":"hotel_preference","value":"优先选择靠近地铁的酒店","confidence":0.95},再由程序做二次校验后写库。重点是模型负责提出候选,程序负责决定是否持久化,不要把模型的每句话都当成事实。
可用的过滤条件包括:是否是用户明确表达、是否可能长期复用、是否与已有记忆冲突、是否属于敏感信息、是否需要过期时间。对于会变化的数据,例如当前城市或临时预算,可以增加 updated_at 和 expires_at,让旧记忆自动失效。
检索时只召回相关内容
示例中的 instr 适合小规模字面匹配。按内容做复杂检索时,应先收紧租户、用户和授权范围,再做相关性排序。数据量增大后,可以换成全文检索或向量检索,并在结果上做数量限制、相关性排序和时间衰减。无论底层技术是什么,都应保持同一原则:只把当前问题真正需要的记忆注入 Prompt。
例如用户询问“帮我订东京酒店”时,住宿偏好和预算值得召回;如果用户改问“写一段 Python 代码”,这两条旅行记忆就不应进入上下文。这样既节省上下文窗口,也减少无关记忆对回答的干扰。
长期记忆的质量取决于写入门槛和召回精度,而不是记录数量。先把“提取、过滤、去重、持久化、检索、注入”这条闭环跑通,再考虑更复杂的向量数据库或自动总结,会更容易控制正确性和数据成本。