
AI Agent / 系统课时
生成向量并建立索引
生成向量并建立索引
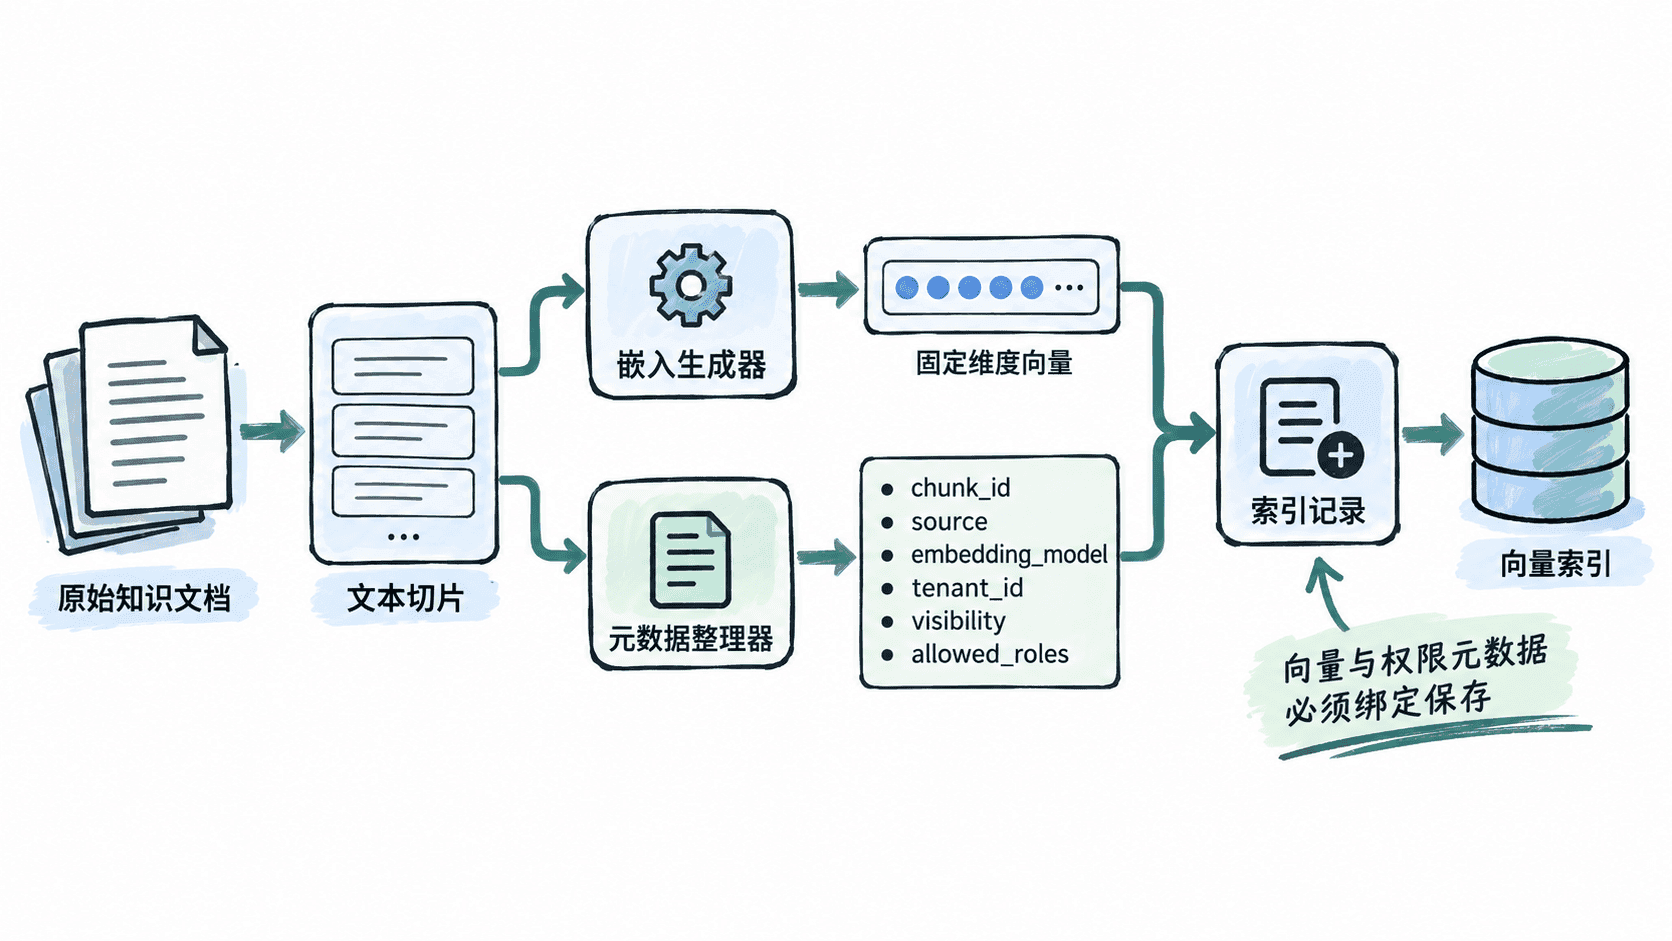
本节把上一课的切片与来源、模型版本、访问范围一起保存成 JSONL 目录,并从经授权的记录建立 Faiss 精确向量索引。Faiss 搜索返回的是内部行号,应用要将它映射回可信的切片记录。
学习目标
- 把文本切片转换为固定维度向量,并记录嵌入模型与内容版本。
- 将向量、正文、来源元数据和访问范围保存为同一条索引记录。
- 判断精确检索与 HNSW、IVF 等近似索引的适用边界。
一条向量记录应该保存什么
RAG 索引不是只存一个浮点数组。至少要把 chunk_id、原文、向量、来源、嵌入模型版本和权限字段绑定在一起。否则后续即使召回了正确向量,也可能无法展示来源、判断是否过期,甚至无法执行租户或角色隔离。
| 字段 | 作用 |
|---|---|
chunk_id |
稳定标识文本切片,便于更新和删除 |
text |
召回后真正交给模型的上下文 |
vector |
用于计算相似度的固定维度嵌入 |
source |
记录文档、页面或业务对象来源 |
embedding_model |
防止不同模型或维度的向量混用 |
access |
保存租户、可见性和角色范围 |
用可复现脚本生成索引记录
把代码保存为 rag_index.py,与 rag_chunks.py 放在同一目录。在 Python 3.11 虚拟环境安装 python -m pip install numpy==1.26.4 faiss-cpu==1.13.2。示例用四维词频向量解释管道,Faiss 的索引和内积搜索都实际运行。课程数据均为虚构,固定词表无法理解同义表达。
import json
from pathlib import Path

import faiss
import numpy as np

from rag_chunks import chunk_document

VOCAB = ("退款", "到账", "支付", "物流")
MODEL = "classroom-terms-v1"
DIMENSION = len(VOCAB)
CATALOG = Path("rag-index.jsonl")
DOCS = [
    ("acme", "refund", "v2", "tenant", (), "退款通常在 3 到 5 个工作日到账。"),
    ("acme", "refund", "v1", "tenant", (), "退款通常在 9 个工作日到账。"),
    ("other", "refund", "v2", "tenant", (), "退款到账说明:退款当天到账。"),
    ("acme", "support", "v2", "roles", ("support",), "退款到账异常请核对支付渠道。"),
    ("acme", "finance", "v2", "roles", ("finance",), "退款到账需要财务复核。"),
    ("acme", "shipping", "v2", "tenant", (), "发货后可查询物流。"),
]


def embed(text):
    counts = np.array([text.count(term) for term in VOCAB], dtype=np.float32)
    norm = np.linalg.norm(counts)
    return counts / norm if norm else None


def records():
    for tenant, doc, version, visibility, roles, text in DOCS:
        for chunk in chunk_document("## 说明\n" + text, tenant, doc, version):
            vector = embed(chunk["text"])
            if vector is None:
                continue
            yield {
                **chunk, "doc_id": doc, "revision": version,
                "tenant_id": tenant, "source": f"kb/{doc}",
                "visibility": visibility, "allowed_roles": list(roles),
                "embedding_model": MODEL, "vector": vector.tolist(),
            }


def build_flat(authorized_rows):
    index = faiss.IndexFlatIP(DIMENSION)
    if not authorized_rows:
        return index
    if any(row["embedding_model"] != MODEL for row in authorized_rows):
        raise ValueError("embedding model mismatch")
    matrix = np.ascontiguousarray([row["vector"] for row in authorized_rows], dtype=np.float32)
    if (
        matrix.shape != (len(authorized_rows), DIMENSION)
        or not np.isfinite(matrix).all()
        or not np.allclose(np.linalg.norm(matrix, axis=1), 1)
    ):
        raise ValueError("invalid unit vector matrix")
    index.add(matrix)
    return index


def load_catalog(path=CATALOG):
    with path.open(encoding="utf-8") as file:
        rows = [json.loads(line) for line in file]
    if len({row["chunk_id"] for row in rows}) != len(rows):
        raise ValueError("duplicate chunk ID")
    return rows


if __name__ == "__main__":
    rows = list(records())
    with CATALOG.open("w", encoding="utf-8") as file:
        for row in rows:
            file.write(json.dumps(row, ensure_ascii=False, allow_nan=False) + "\n")
    # 演示为单一租户的两条当前、租户可见记录建索引。
    sample = [
        row for row in load_catalog()
        if row["tenant_id"] == "acme" and row["revision"] == "v2"
        and row["visibility"] == "tenant"
    ]
    print(f"records={len(rows)} dimension={DIMENSION}")
    print(f"{CATALOG.name}: demo_index={build_flat(sample).ntotal}")
预期输出
records=6 dimension=4
rag-index.jsonl: demo_index=2
对 L2 归一化后的文档和查询向量,Faiss 的内积排序与余弦排序相同。使用真实嵌入时,模型、版本、维度、距离度量和归一化策略一起确定索引兼容性。即使两个模型输出维度一样,它们的向量也不宜混用。
建索引时要守住的数据边界
小规模知识库可以直接遍历全部归一化向量计算相似度,这属于精确检索,结果稳定、实现简单。数据量上升后再使用 HNSW、IVF 等 ANN 索引,把“候选召回速度”作为优化层;ANN 不应改变 chunk_id、来源和权限这些业务语义。
向量索引和授权系统需要明确的连接方式。此例的 JSONL 只作受控的数据目录,不能放在用户可下载的路径。查询前由应用筛选当前租户、可见版本和角色,再用已授权记录建小型内存索引。下一课实现这一步。真实系统通常按租户或权限分区管理索引,或者让支持权限过滤的引擎在候选阶段执行过滤。ACL 仍应从可信业务数据派生,并在候选进入上下文前复核。
更新时先建立新内容版本与索引,验证后切换活动版本,再移除旧数据。更换嵌入模型时用独立索引重建。上线 ANN 前,用同一份已授权数据和精确检索结果比较召回率、时延与内存消耗。JSONL 目录和索引映射需要作为同一版本管理。