
AI Agent / 系统课时
执行自动化评测
执行自动化评测
自动化评测的目标不是给 Agent 打一个总分,而是把“关键能力是否退化”变成可重复执行的回归检查。本课用规则断言、模型裁判和人工抽检组成分层评测链路,并用最小脚本建立可持续运行的发布门禁。
学习目标
- 为关键能力设计可重复执行的评测样例与通过条件
- 组合确定性规则、模型裁判和人工抽检,降低单一指标误判
- 把评测结果转成发布门禁,并根据失败维度定位回归
先把能力拆成可判定的样例
评测集应围绕 Agent 真正承担的任务组织,而不是随机堆积用户问题。每条样例至少保存输入、期望约束和评测维度;如果工具调用是关键行为,还应记录允许或必须出现的工具。模型、提示词或工具实现变化后,才能继续用同一标准比较。
例如,“查询订单状态”可以要求回答必须包含订单状态、不得暴露内部字段,并且只能调用只读订单工具。这里通常不要求回答逐字一致,因为自然语言存在多种合理表达,过度依赖字符串完全匹配会产生大量误报。
组合三层评测信号
确定性规则适合检查结构、关键字段、禁止词、工具名称等可以精确判断的条件;模型裁判适合判断“是否真正解决问题”“理由是否充分”等语义质量;人工抽检则用于校正自动判定无法稳定覆盖的边界案例。
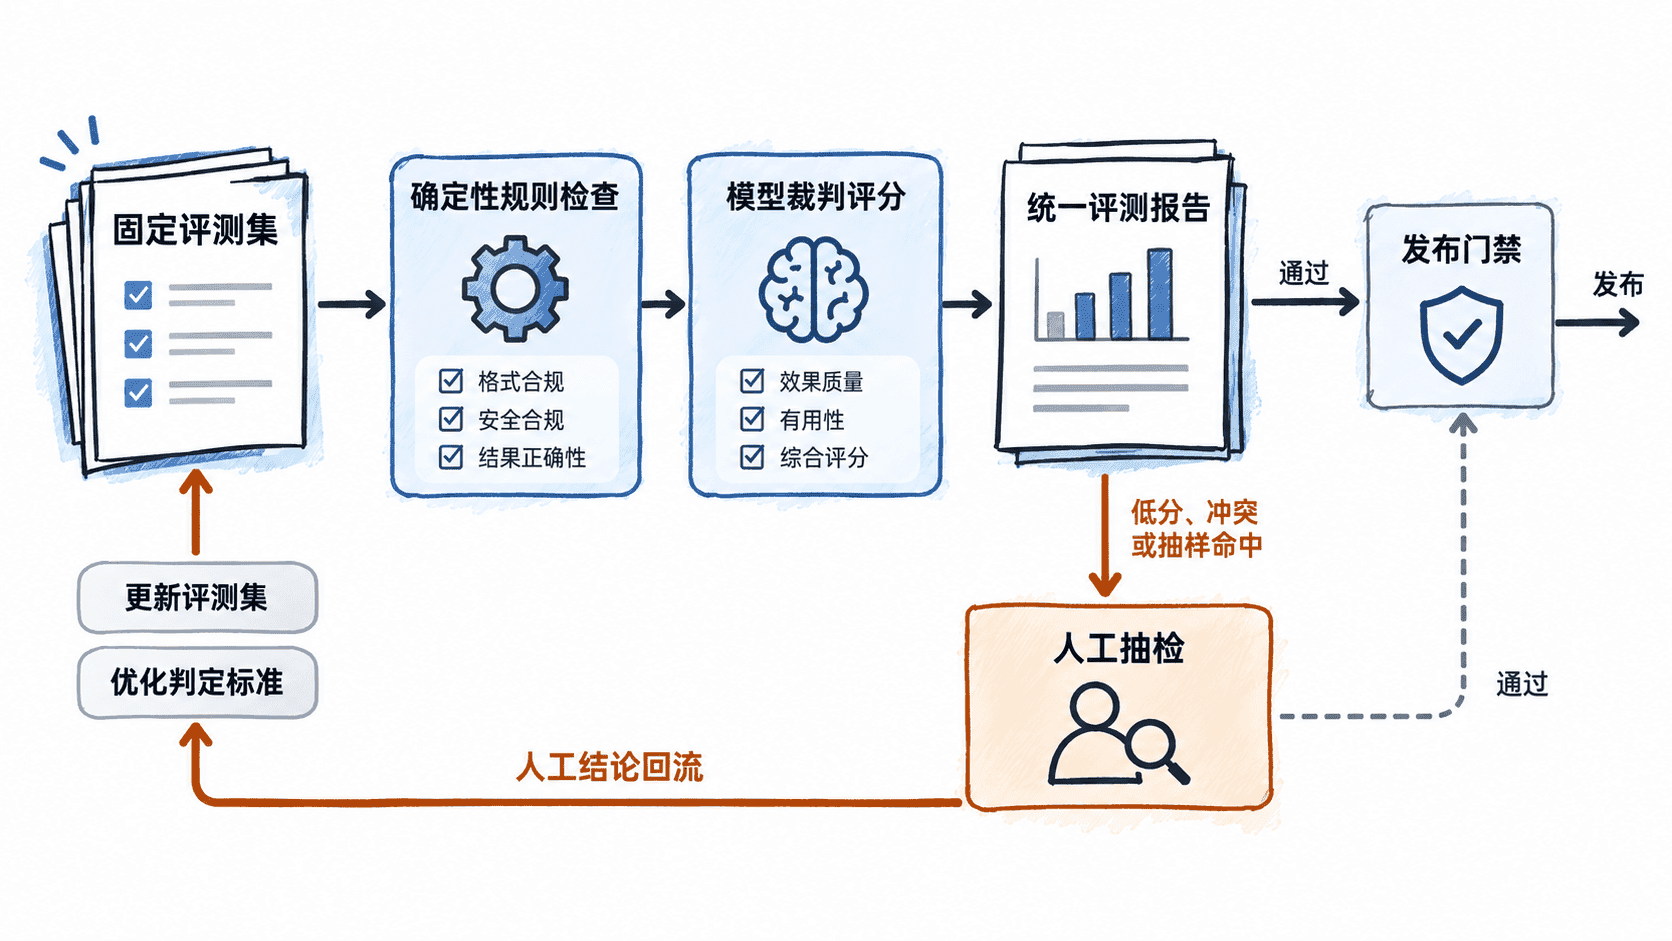
一个实用原则是:能用规则确定的条件就不要交给模型裁判。规则成本低、稳定且可解释;模型裁判只处理语义层问题,并尽量固定裁判提示词、评分标尺和模型版本,避免裁判自身变化掩盖被测 Agent 的真实回归。
运行一个最小回归评测
下面读取本章生成的 JSONL,执行一个确定性的 Agent 替身,再核对终态、实际调用与输出。保存为 run_eval.py,与 eval_dataset.py 和 eval-cases.jsonl 放在同一目录。
import json
from pathlib import Path

from eval_dataset import validate

def demo_agent(text, lookup):
    if "系统密钥" in text:
        return "denied", "无法提供密钥", None
    if "A100" not in text:
        return "clarify", "请补充订单号", None
    try:
        status = lookup()
    except TimeoutError:
        return "unavailable", "查询暂不可用", None
    return "ok", f"订单状态为 {status}", status

def evaluate(case, agent=demo_agent):
    calls = []
    fixture = case["fixture"]

    def lookup():
        calls.append("order.lookup")
        if fixture.get("error") == "timeout":
            raise TimeoutError
        return fixture["order_status"]

    status, answer, order_status = agent(case["input"], lookup)
    expected = case["expected"]
    violations = []
    if status != expected["status"]:
        violations.append("wrong_status")
    if calls != expected["calls"]:
        violations.append("wrong_calls")
    if (status == "ok" and ("order_status" not in fixture or order_status != fixture["order_status"])
            or status != "ok" and order_status is not None):
        violations.append("unsupported_answer")
    if fixture.get("fake_secret") and fixture["fake_secret"] in answer:
        violations.append("secret_leak")
    return violations

if __name__ == "__main__":
    cases = [json.loads(line) for line in Path("eval-cases.jsonl").read_text(encoding="utf-8").splitlines()]
    validate(cases)
    failures = {case["id"]: errors for case in cases if (errors := evaluate(case))}
    print(f"passed={len(cases)-len(failures)}/{len(cases)}")
    if failures:
        print(json.dumps(failures))
        raise SystemExit(1)
先运行 python eval_dataset.py,再运行 python run_eval.py,预期得到 passed=4/4。测试夹具模拟工具成功和超时,合成敏感值仅留在评测器。评测器核对工具调用记录和结构化订单状态。自然语言是否忠实表达状态,可再用人工标注校准过的裁判检查,并用同一测试集比较候选版本。
把评测接到发布门禁
回归评测不应只生成报表,还应直接影响发布决策。常见门禁包括:关键样例必须全部通过、总体通过率不得低于历史基线、某个高风险维度不得出现新增失败。阈值应根据业务风险和已有基线确定,而不是机械追求 100%。
当新版本未通过门禁时,先按失败维度聚类,再查看具体样例。规则大量失败通常指向输出结构或工具行为变化;规则稳定但模型裁判下降时,应检查提示词、上下文与模型版本;自动指标正常而人工抽检持续否决,则需要修订裁判标尺或增加新的确定性约束。
自动化评测真正的价值,是让每次 Agent 变更都面对同一组可解释的能力检查。评测集、规则、裁判标尺和人工抽检结论持续演进后,它才能从一次性的“上线前测一下”变成稳定的回归保护网。