
AI Agent / 系统课时
实现 ReAct 循环
实现 ReAct 循环
ReAct 的关键不是让模型一次给出完整答案,而是让它在“决定下一步动作—调用工具—读取观察结果”之间循环,直到满足结束条件。本节会实现一个可运行的最小循环,并补上步数上限、工具白名单和异常观察等必要护栏。
学习目标
- 理解 ReAct 循环中模型决策、工具动作与观察结果的职责边界
- 实现可运行的工具调用循环,并能正确判断何时停止
- 为循环加入步数上限、工具校验和错误观察,避免失控执行
ReAct 循环的控制权放在哪里
一个稳健的 ReAct Agent 通常由调度器掌握循环控制权:模型只负责根据当前上下文选择下一步动作,工具只负责执行动作并返回事实,调度器负责校验动作、调用工具、追加观察并判断是否继续。这样可以把模型的不确定性限制在明确边界内。
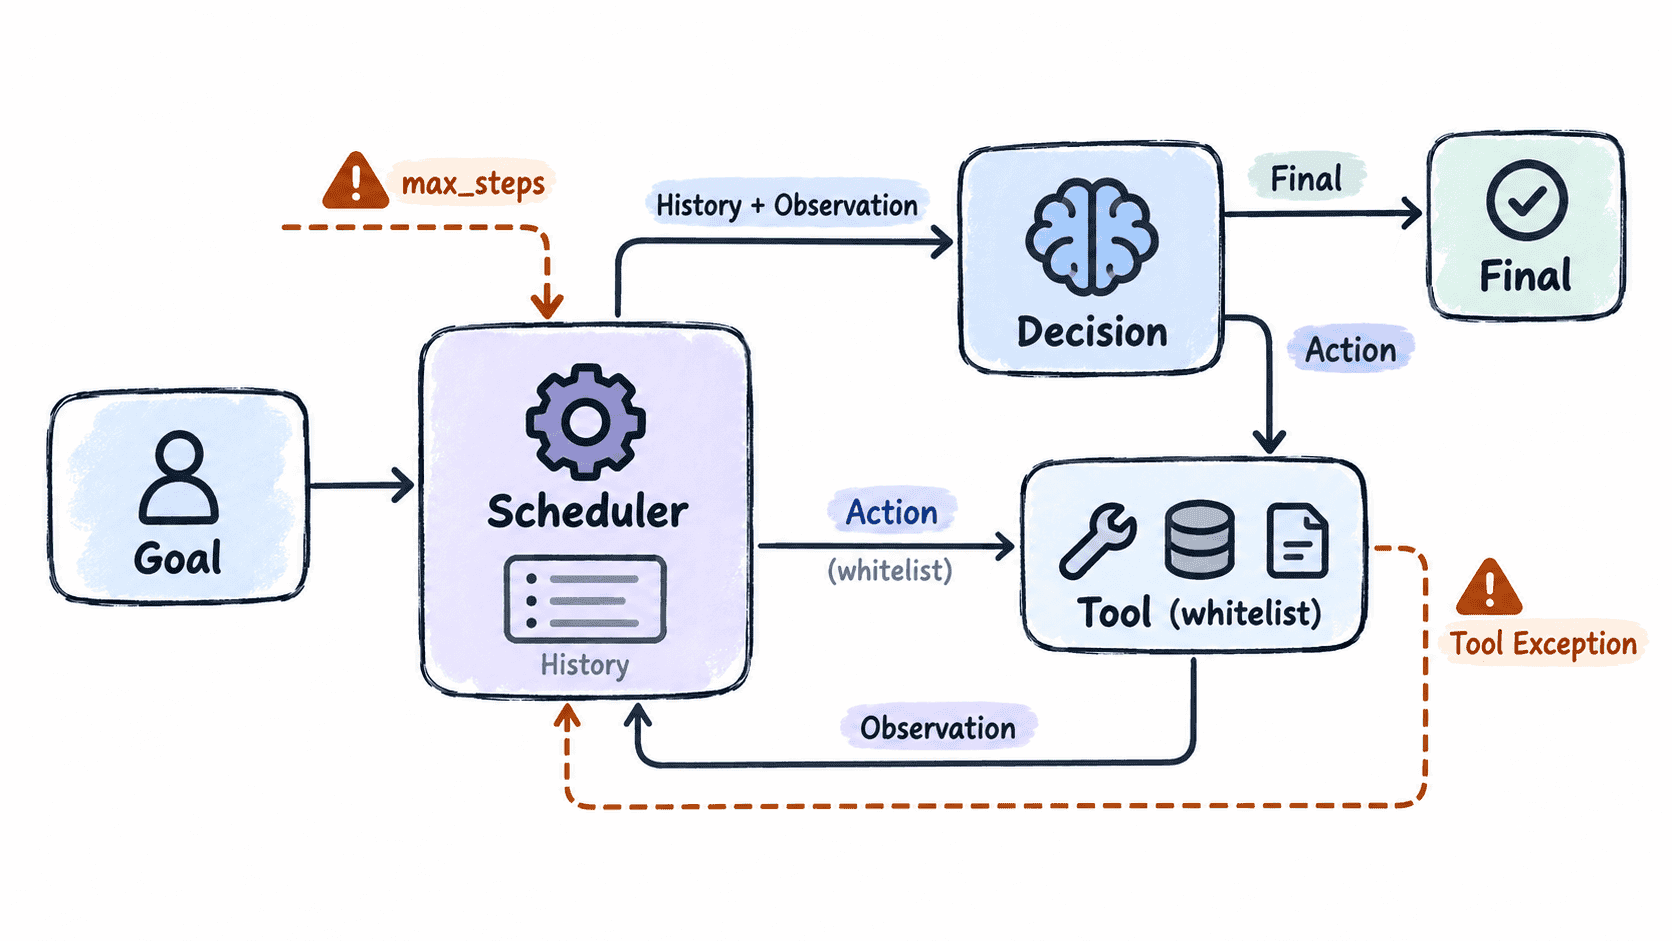
这里的“思考”应理解为模型完成下一步决策,而不是把完整内部推理过程写入日志。生产系统通常只保存可审计的动作、参数、工具结果和最终回答,避免把不可控的长推理文本当成协议字段。
实现最小可运行循环
下面的示例使用一个确定性的 model_step 模拟模型决策,因此不依赖外部 API,可以直接运行。接入模型时,用适配器返回动作和参数,或提出结束。宿主检查参数、权限和完成证据。
from dataclasses import dataclass
from typing import Any, Callable

@dataclass
class Decision:
    action: str | None = None
    args: dict[str, Any] | None = None
    final: str | None = None

def lookup_price(product: str) -> dict[str, Any]:
    prices = {'gpu-hour': 12}
    if product not in prices:
        raise ValueError(f'unknown product: {product}')
    return {'product': product, 'unit_price': prices[product]}

def multiply(a: int, b: int) -> dict[str, int]:
    return {'value': a * b}

TOOLS: dict[str, Callable[..., dict[str, Any]]] = {
    'lookup_price': lookup_price,
    'multiply': multiply,
}

def model_step(history: list[dict[str, Any]]) -> Decision:
    # 用确定性逻辑模拟“模型根据已有观察选择下一步”。
    observations = [item for item in history if item['type'] == 'observation']
    if not observations:
        return Decision(action='lookup_price', args={'product': 'gpu-hour'})

    if 'error' in observations[-1]['result']:
        return Decision(final='工具查询失败')

    if observations[-1]['tool'] == 'lookup_price':
        unit_price = observations[-1]['result']['unit_price']
        return Decision(action='multiply', args={'a': unit_price, 'b': 3})

    total = observations[-1]['result']['value']
    return Decision(final=f'3 个 GPU 小时的费用是 {total} 元')

def run_agent(max_steps: int = 5, decide=model_step) -> str:
    history: list[dict[str, Any]] = []

    for _ in range(max_steps):
        decision = decide(history)

        if decision.final is not None:
            if history and "error" in history[-1]["result"]:
                return "Agent 停止:工具查询失败"
            if not history or history[-1]["tool"] != "multiply":
                return "Agent 停止:缺少计算证据"
            return f"3 个 GPU 小时的费用是 {history[-1]['result']['value']} 元"

        if decision.action not in TOOLS or decision.args is None:
            return 'Agent 停止:模型返回了不允许的动作'

        fields = {"lookup_price": {"product"}, "multiply": {"a", "b"}}
        args = decision.args
        if not isinstance(args, dict) or set(args) != fields[decision.action]:
            return "Agent 停止:参数字段不匹配"
        if decision.action == "lookup_price" and not isinstance(args["product"], str):
            return "Agent 停止:商品编号类型错误"
        if decision.action == "multiply":
            if not history or history[-1]["tool"] != "lookup_price" or "unit_price" not in history[-1]["result"]:
                return "Agent 停止:缺少价格证据"
            if any(type(v) is not int for v in args.values()) or args != {"a": history[-1]["result"]["unit_price"], "b": 3}:
                return "Agent 停止:计算参数与证据不符"
        try:
            result = TOOLS[decision.action](**args)
        except ValueError:
            result = {"error": "lookup_failed"}

        history.append({
            'type': 'observation',
            'tool': decision.action,
            'result': result,
        })

    return 'Agent 停止:超过最大循环步数'

if __name__ == '__main__':
    print(run_agent())
预期输出
3 个 GPU 小时的费用是 36 元示例中真正形成 ReAct 的不是某个特定提示词,而是 run_agent 持续执行“决策—动作—观察”的循环。工具结果不会被直接当成最终答案,而是先进入历史,下一轮决策再根据新事实继续推进。
把循环限制在可控范围
至少要有三个停止条件。第一,模型提出 final 且宿主核对完成证据;第二,达到 max_steps 后强制停止;第三,模型给出未知工具、非法参数或违反策略的动作时拒绝执行。没有这些条件,错误决策可能演变成无限重试或重复调用。
工具调用还应使用白名单,而不是把模型返回的字符串直接拼成代码执行。对具有副作用的工具,例如发邮件、下单、删除资源,最好再增加权限检查、幂等键或人工确认,把“模型决定做什么”和“系统允许做什么”分开。
观察结果要足够而不过量
Observation 的职责是提供下一步决策需要的事实。返回值应优先结构化,例如状态码、命中数量、关键字段和错误类型。若工具结果很大,应先裁剪或摘要,再放回上下文,否则循环越长,输入上下文就越快膨胀。
调试时重点记录每轮的动作名、参数摘要、工具耗时、结果状态和停止原因。这样即使模型最终回答不理想,也可以从循环轨迹判断问题出在决策、工具、观察还是停止逻辑,而不需要依赖不可审计的内部推理文本。
当调度器掌握循环、工具受白名单约束、Observation 保持结构化,并且存在明确的停止条件时,ReAct 才从“多轮提示词”变成可运行、可观测、可治理的 Agent 执行机制。