
AI Agent / 系统课时
组织消息角色与顺序
组织消息角色与顺序
Agent 的上下文不是一段拼接文本,而是一串带角色、顺序和关联关系的消息。组织得当,模型才能区分长期规则、当前请求、历史回复与工具结果;本节给出一套可复用的组装顺序,并说明截断历史时哪些消息不能拆散。
学习目标
- 区分应用指令、用户、助手和工具消息各自承担的职责
- 按一次完整交互的真实时间顺序组织上下文
- 在裁剪历史时保留工具调用与工具结果的关联完整性
消息角色各自负责什么
这里沿用前一章的 Chat Completions 接口。应用从可信配置组装指令,用较新模型支持的 developer 角色传入。较老模型可能要求 system,使用兼容服务时要查目标端点和模型的消息协议。
| 来源或角色 | 主要职责 | 常见误用 |
|---|---|---|
developer 或 system |
应用规则与行为边界 | 把用户输入、网页或工具正文拼到可信指令中 |
user |
用户问题、补充信息和任务要求 | 由客户端冒充其他角色 |
assistant |
已产生的模型答复,或用 tool_calls 声明的工具调用 |
把提出的动作写成已执行结果 |
tool |
一次工具调用的结果 | 用数组位置匹配,或缺少对应的 tool_call_id |
角色帮助模型区分来源。身份、工具权限和资源归属仍需由应用及工具服务验证。
顺序必须符合真实交互
应用先加入指令和用户请求。模型返回带工具调用的助手消息后,应用记录调用并核验工具名称、参数和权限。执行得到结果,再按调用 ID 加入工具消息,发起下一次模型请求。
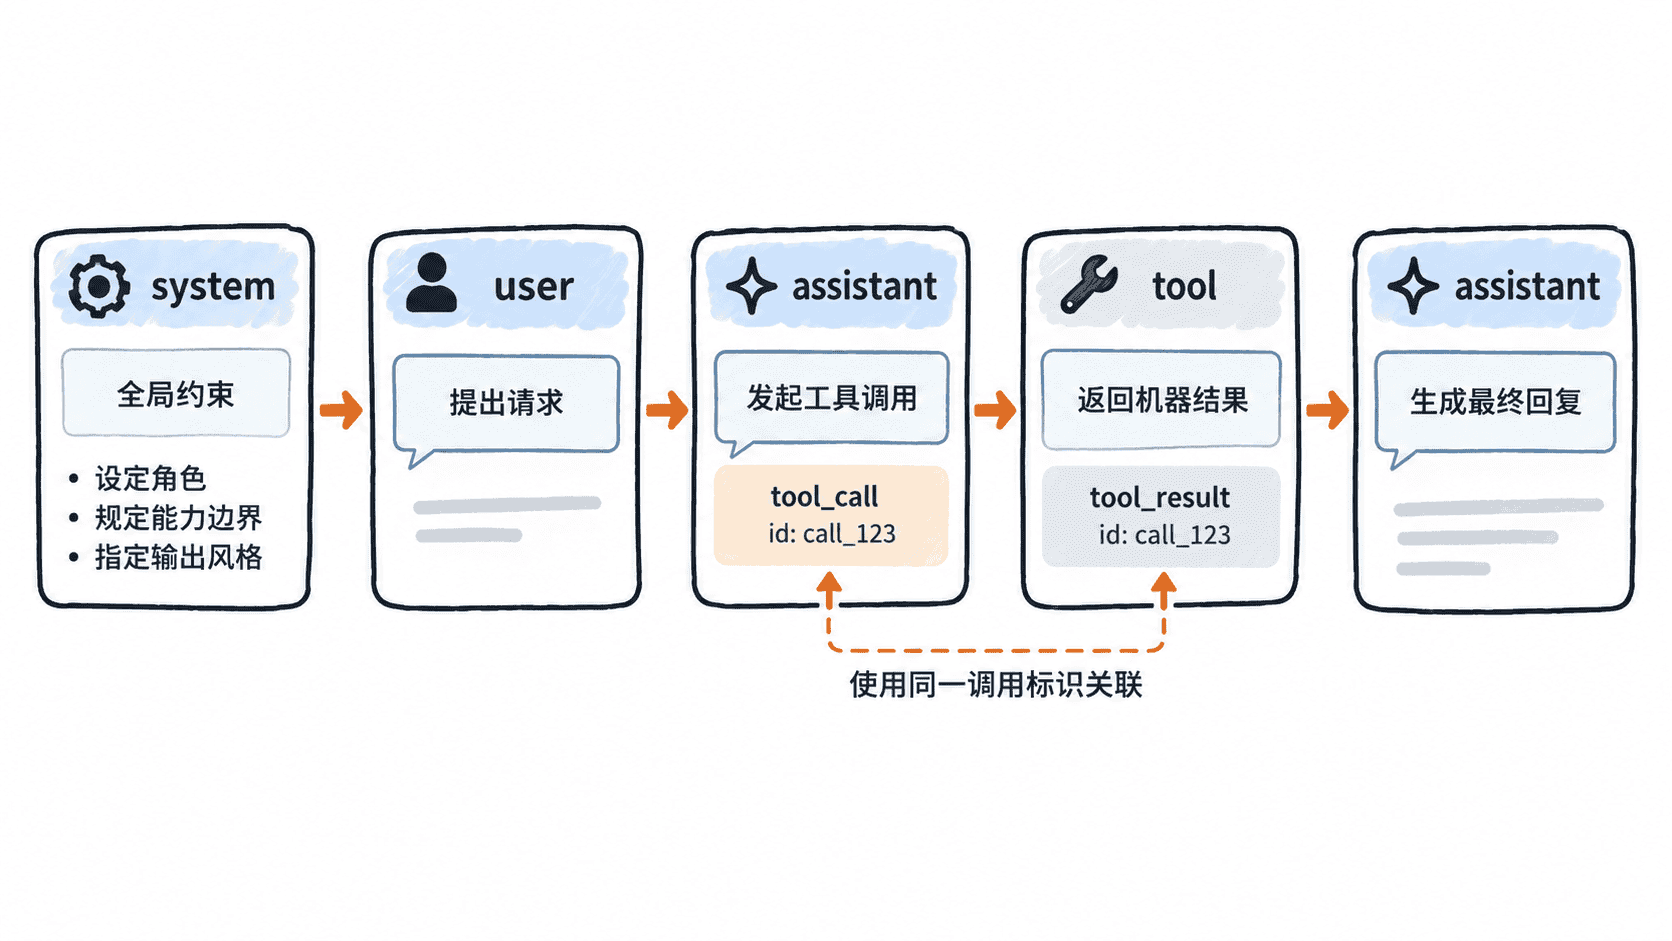
同一助手消息可以提出多个调用。工具实际返回顺序可不同,应用需按 ID 收集结果。每个调用要有一个对应结果,再继续模型交互。工具失败也可以返回一个经清理的失败结果。
组装下一次 Chat Completions 请求的消息
下面是第二次请求前的本地组装示例。助手消息和结果都来自固定测试数据。真实调用应保存第一轮返回的助手工具调用消息,并传入经过权限检查的工具结果。
python
import json


def append_tool_results(history, assistant_message, results):
    calls = assistant_message["tool_calls"]
    call_ids = [call["id"] for call in calls]
    if not call_ids or len(call_ids) != len(set(call_ids)) or set(call_ids) != set(results):
        raise ValueError("tool call IDs do not match tool results")
    return [
        *history,
        assistant_message,
        *[
            {
                "role": "tool",
                "tool_call_id": call_id,
                "content": json.dumps(results[call_id], ensure_ascii=False),
            }
            for call_id in call_ids
        ],
    ]


if __name__ == "__main__":
    history = [
        {"role": "developer", "content": "根据工具返回的证据回答订单状态。"},
        {"role": "user", "content": "订单 A1024 发货了吗?"},
    ]
    assistant_message = {
        "role": "assistant",
        "tool_calls": [
            {
                "id": "call_1", "type": "function",
                "function": {"name": "get_order", "arguments": '{"order_id":"A1024"}'},
            },
        ],
    }
    messages = append_tool_results(history, assistant_message, {
        "call_1": {"order_id": "A1024", "status": "shipped"},
    })
    print(" -> ".join(message["role"] for message in messages))
    print(messages[-1]["tool_call_id"], json.loads(messages[-1]["content"])["status"])
预期输出
text
developer -> user -> assistant -> tool
call_1 shipped
最后一条消息是工具结果。发出下一次请求之后,模型才会生成新的助手回复。
裁剪历史时不要破坏语义边界
上下文过长时,最容易出现的错误不是“少了几句闲聊”,而是把一个工具回合裁成半截。可以优先丢弃较早、已被新信息覆盖的普通对话,但应保留当前系统规则、最近用户请求,以及仍影响当前回答的调用与结果。
裁剪时以完整交互回合为单位。摘要应保留证据来源和不确定性,按数据注入上下文,并继续与应用指令隔离。涉及仍可恢复的工具操作时,在业务状态中保留操作记录,再决定哪些消息可从模型上下文移除。
按自己的节奏,确认真正理解。