
AI Agent / 系统课时
记录运行轨迹
记录运行轨迹
Agent 出现答非所问、工具超时或状态错乱时,只有最终答案通常不足以定位原因。本课建立一条可回放的运行轨迹,把提示词、模型响应、工具调用、状态变化和错误事件串成同一条时间线。
学习目标
- 设计能关联一次 Agent 运行的统一轨迹字段
- 在模型、工具、状态和异常边界采集结构化事件
- 识别日志脱敏、采样与保留周期等观测边界
先定义一条可关联的轨迹
一次用户任务可以看成一条 trace,内部由多个按时间发生的 event 组成。最重要的不是“多记日志”,而是让所有事件共享稳定的 trace_id,并记录事件类型、时间、输入输出摘要和错误信息,这样才能按一次任务完整回放。
| 事件类型 | 至少记录什么 | 主要用途 |
|---|---|---|
| 输入事件 | 提示版本、输入大小或允许的摘要 | 判断上下文是否正确 |
| 模型响应 | 模型版本、用量和结束原因 | 判断模型结果是否偏离 |
| 工具调用 | 工具名、调用 ID、结果类别与耗时 | 定位外部依赖问题 |
state_change |
旧状态、新状态、触发原因 | 还原控制流 |
| 错误 | 错误码、异常类型与发生阶段 | 快速定位失败点 |
在关键边界采集事件
轨迹应跟着执行边界产生,而不是在任务结束后再拼装。用户输入进入 Agent 时建立 trace_id;每次模型调用、工具调用、状态迁移和异常捕获都追加事件。这样即使任务中途失败,前面的证据仍然完整。
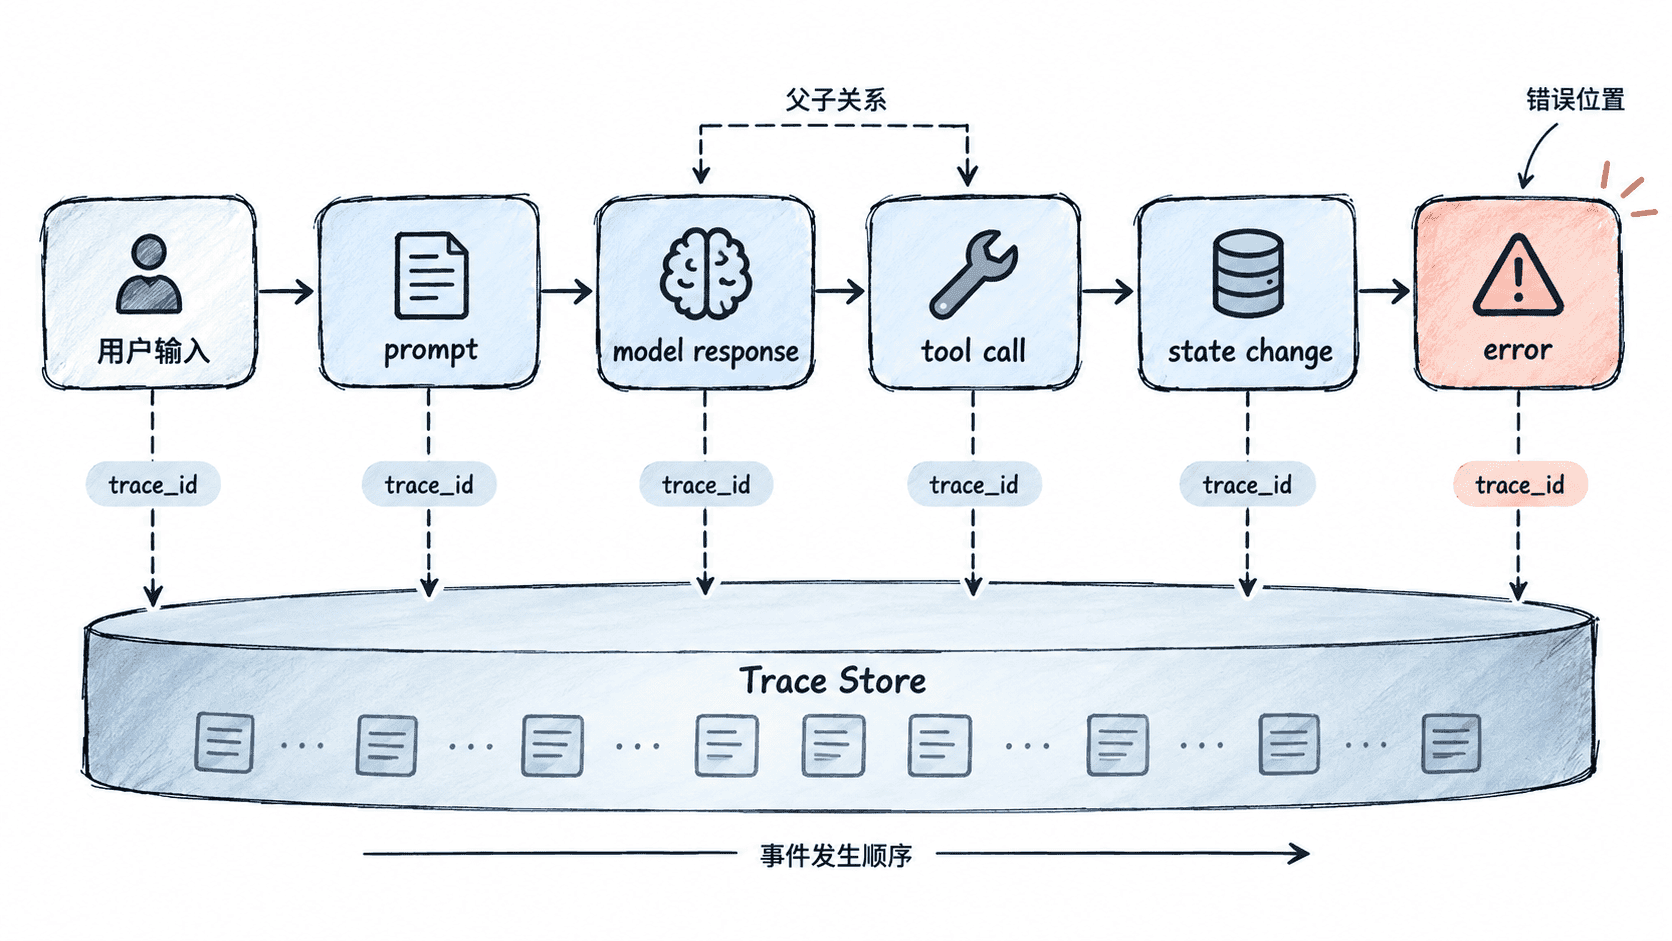
实际工程中可以通过模型客户端包装器、工具调用中间件和状态机钩子统一埋点,避免业务代码到处手写日志。若框架支持 span,还可以给一次模型调用或工具调用分配 span_id 和 parent_span_id,形成父子关系。
用结构化事件落地
下面每次运行创建独立的 trace。字段按事件类型选择,输入文本和任意外部错误消息不进入日志。
from datetime import datetime, timezone
import json
from time import perf_counter
from uuid import uuid4

FIELDS = {
    "run.start": ("workflow",),
    "tool.finish": ("tool", "call_id", "outcome", "elapsed_ms"),
    "run.finish": ("outcome",),
}

def new_trace():
    trace_id = uuid4().hex
    sequence = 0

    def emit(event_type, **fields):
        nonlocal sequence
        sequence += 1
        record = {
            "trace_id": trace_id,
            "sequence": sequence,
            "timestamp": datetime.now(timezone.utc).isoformat(),
            "event": event_type,
            "data": {key: fields[key] for key in FIELDS[event_type]},
        }
        print(json.dumps(record, ensure_ascii=False))
    return emit

def demo(outcome):
    emit = new_trace()
    emit("run.start", workflow="order-lookup")
    started = perf_counter()
    emit("tool.finish", tool="order_status", call_id=uuid4().hex,
         outcome=outcome, elapsed_ms=round((perf_counter()-started)*1000, 2),
         raw_response="synthetic-secret-do-not-log")
    emit("run.finish", outcome=outcome)

demo("ok")
demo("timeout")
脚本输出 6 行 JSON。每次运行中的 3 行共享 trace ID,并分别编号 1、2、3。两次运行的 ID 不同,测试用的原始响应值不会出现在输出中。字段值也应来自可信枚举或经过脱敏,单靠字段白名单无法过滤被错误填进允许字段的敏感值。
本例的序号只保证单次顺序调用中的事件顺序。跨进程或并行场景应传递 trace/span 上下文并记录父子关系,不宜只按接收日志的顺序判断因果。用墙钟记录事件时间,用单调时钟计算耗时。
避免轨迹本身成为风险
完整提示词和工具参数可能包含密钥、个人信息或业务敏感数据。进入观测系统前应先做字段级脱敏;能记录摘要或哈希时,不要默认保存原文。对高流量 Agent,可按需求为成功和失败请求设定不同采样策略,并把保留率与告警口径分开,并给日志设置明确的访问权限和保留周期。
轨迹的价值在于可关联、可检索和可回放。只要一次任务中的模型、工具、状态和错误都能沿同一 trace_id 还原,就建立了后续评测、性能分析和故障排查所需的基础证据。