
AI Agent / 系统课时
保存检查点并恢复
保存检查点并恢复
长时间运行的 Agent 可能因为进程退出、网络失败或人工暂停而中断。要让任务安全继续,不能只保存聊天记录,还要持久化当前步骤、已产生结果和可恢复状态。本课用 SQLite 保存检查点,并演示中断后加载状态继续执行。
学习目标
- 识别检查点中必须持久化的运行状态
- 使用版本化检查点保存并恢复 Agent 任务
- 在恢复前验证状态,区分继续执行与回滚
检查点保存的不是整段上下文
一个可恢复检查点至少要回答:正在执行哪个任务、当前到哪一步、已经产生哪些不可重复的结果、下一步应该做什么。对于会调用外部系统的 Agent,还应保存幂等键、外部资源 ID 或提交状态,避免恢复后重复付款、重复发消息或重复创建资源。
聊天历史可以作为辅助信息,但不应替代结构化状态。恢复逻辑真正依赖的是明确字段,例如 task_id、step、status、state 和 version。结构版本 schema_version 用于判断格式兼容,写入修订号 revision 用于防止多个工作者互相覆盖。
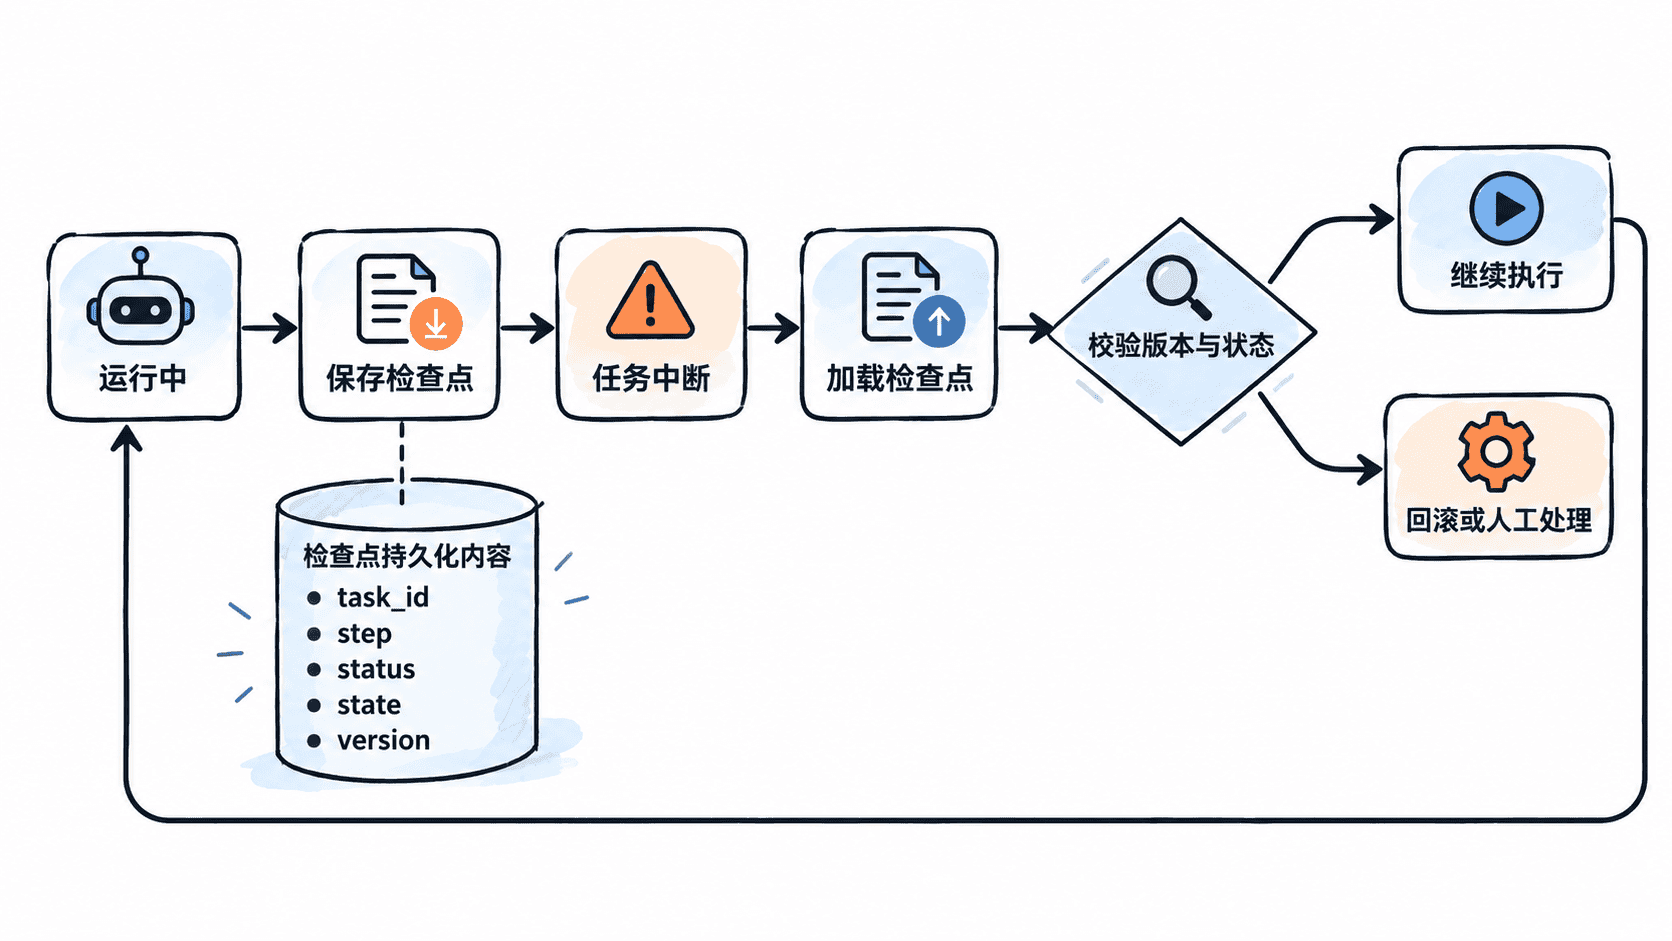
用 SQLite 持久化运行状态
下面将“请求可能已发出但没有可用回执”保存成 pending_remote。关闭连接后从同一临时数据库恢复,先核对外部状态,再用当前修订号提交结果。
import sqlite3
from contextlib import closing
from pathlib import Path
from tempfile import TemporaryDirectory

SCHEMA_VERSION = 1

def load(conn, task_id):
    row = conn.execute(
        "SELECT schema_version, revision, status, operation_key FROM checkpoints WHERE task_id=?",
        (task_id,),
    ).fetchone()
    if row is None or row[0] != SCHEMA_VERSION:
        raise ValueError("checkpoint unavailable or incompatible")
    return row[1:]

def confirm(conn, task_id, expected_revision, operation_key, lookup):
    if lookup(operation_key) != "succeeded":
        return "needs_reconciliation"
    with conn:
        updated = conn.execute("""
            UPDATE checkpoints SET revision=revision+1,status='succeeded'
            WHERE task_id=? AND revision=? AND operation_key=?
              AND schema_version=? AND status='pending_remote'
        """, (task_id,expected_revision,operation_key,SCHEMA_VERSION)).rowcount
    return "saved" if updated == 1 else "conflict"

with TemporaryDirectory() as folder:
    database = Path(folder) / "checkpoints.db"
    with closing(sqlite3.connect(database)) as conn:
        conn.execute("""CREATE TABLE checkpoints(
            task_id TEXT PRIMARY KEY, schema_version INTEGER,
            revision INTEGER, status TEXT, operation_key TEXT
        )""")
        with conn:
            conn.execute("INSERT INTO checkpoints VALUES (?,?,?,?,?)",
                         ("task-001",SCHEMA_VERSION,1,"pending_remote","op-001"))
    with closing(sqlite3.connect(database)) as conn:
        revision, status, key = load(conn, "task-001")
        print(status, key)
        print(confirm(conn, "task-001", revision, key, lambda _: "unknown"))
        replies = {"op-001": "succeeded"}
        print(confirm(conn, "task-001", revision, key, replies.get))
        print(confirm(conn, "task-001", revision, key, replies.get))
        print(load(conn, "task-001"))
输出包含 pending_remote op-001、needs_reconciliation、saved、conflict,最后读回 (2, 'succeeded', 'op-001')。测试查询器不会发送外部请求。实际执行前先持久化操作键与请求内容,恢复后以同一键查询或按服务的幂等约定重试。检查点事务无法把外部操作和本地写入变成同一个原子事务。
恢复前先判断能不能继续
加载成功只是第一关。恢复执行前还要验证检查点版本、任务状态和外部副作用。如果 status 表示某一步已经提交到外部系统,就不能简单从该步骤重新执行;应从已确认的下一步继续,或者先查询外部系统确认结果。
恢复流程可以按以下顺序执行:
- 读取最新检查点并校验
schema_version,记住当前revision。 - 检查
status是否允许自动恢复。 - 对不可重复的外部操作确认幂等键或外部资源 ID。
- 根据
step进入下一个安全步骤。 - 新步骤完成后立即写入新的检查点。
什么时候选择回滚
并不是所有中断都应该自动继续。如果检查点版本已经不兼容、关键外部资源不存在、状态字段损坏,或者无法确认上一步是否成功,应停止自动恢复并进入回滚或人工处理。回滚本身也应是显式状态,例如 rolling_back、rolled_back,而不是直接删除检查点。
可靠的恢复机制依赖两个原则:状态必须结构化且可验证,副作用必须可识别且尽量幂等。这样 Agent 即使跨进程、跨机器重新启动,也能知道“已经做了什么、接下来能安全做什么”,而不是靠重新阅读聊天记录猜测执行进度。