
AI Agent / 系统课时
编排顺序与并行节点
编排顺序与并行节点
Agent 工作流常同时包含“必须先完成”的依赖步骤和“可以一起做”的独立步骤。正确编排的目标不是盲目并行,而是在保持依赖正确的前提下缩短总耗时,并让每个节点失败时都有清晰的恢复位置。
学习目标
- 能从数据依赖判断哪些节点必须串行、哪些节点可以并行
- 能使用
asyncio实现“先准备、再并行、最后汇总”的工作流 - 能为并行节点设计失败处理,避免一个分支异常导致结果不可判断
先画出依赖再决定并行
判断节点能否并行,要同时检查数据依赖、共享资源和外部并发约束。如果 B 需要 A 产生的参数,A 与 B 就必须顺序执行;如果 C 和 D 都只依赖 A 的结果,而且彼此之间没有依赖,则 C 与 D 可以并行。
例如“生成客户周报”可以先读取客户 ID 和时间范围,再同时查询销售数据与支持工单,最后把两个分支的结果交给模型汇总。这里“读取参数”是前置节点,“销售查询”和“工单查询”是并行节点,“生成周报”是汇聚节点。
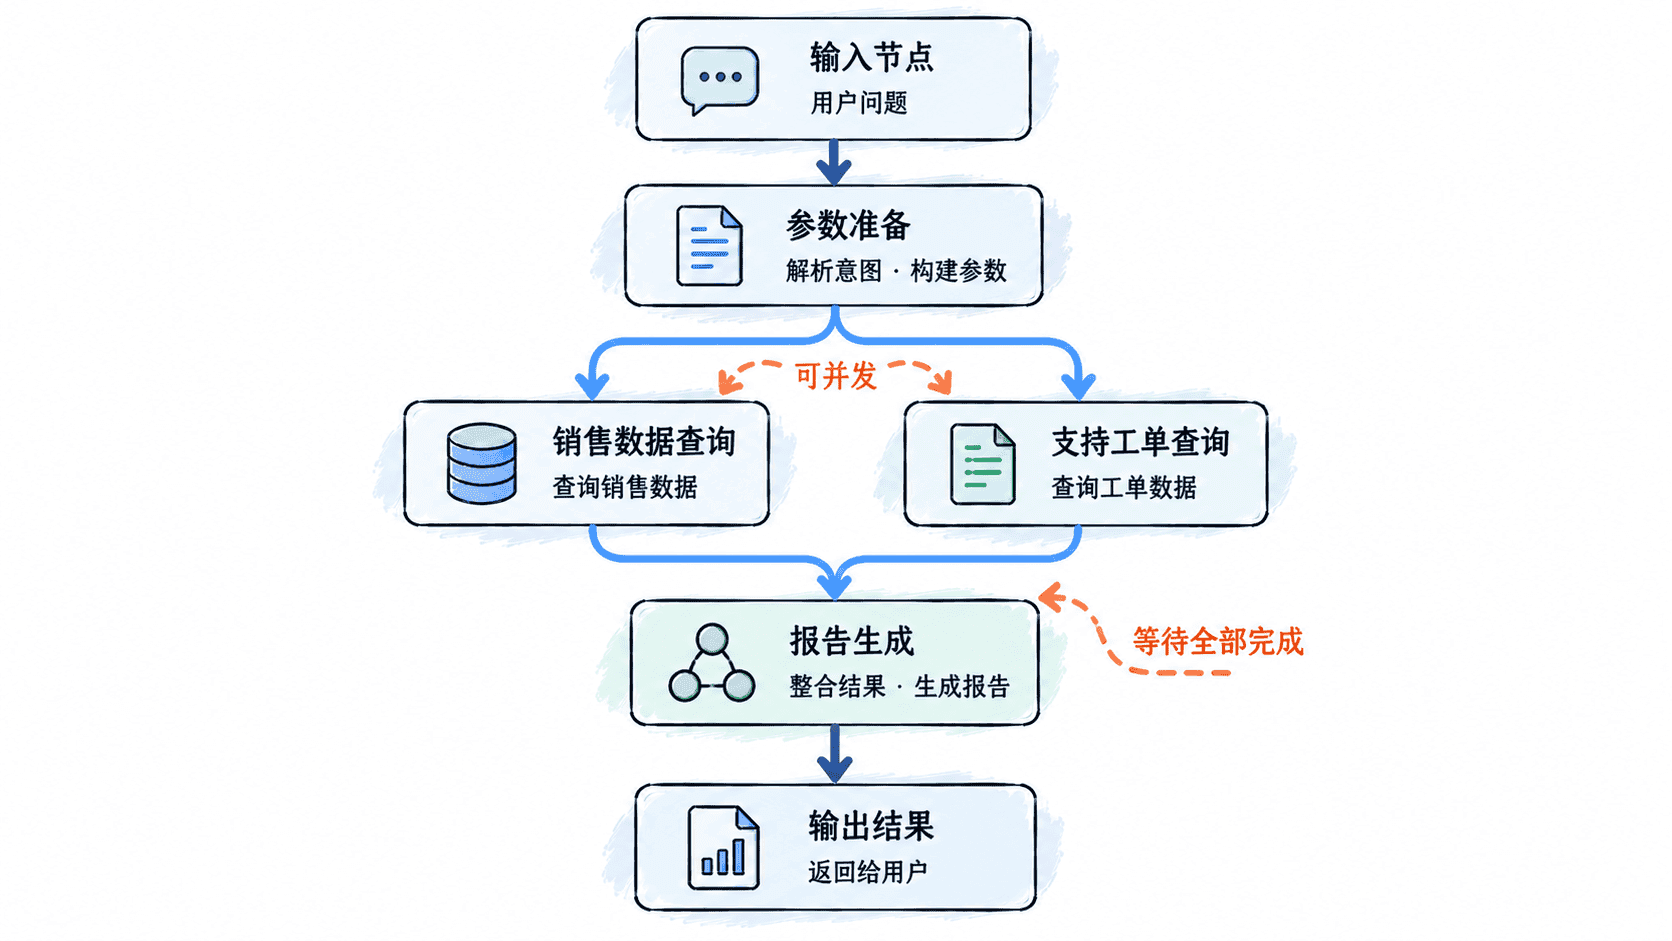
实现先顺序再并行的工作流
下面的示例使用 Python 标准库 asyncio。prepare_context 必须先执行,因为后续两个查询都需要它返回的客户 ID;fetch_sales 与 fetch_tickets 彼此独立,因此通过 asyncio.gather 并发执行。
import asyncio

async def prepare_context() -> dict:
    await asyncio.sleep(0.1)
    return {"customer_id": "C-1001", "period": "2026-W36"}

async def fetch_sales(ctx: dict) -> dict:
    await asyncio.sleep(0.3)
    return {"sales": 128000, "currency": "CNY"}

async def fetch_tickets(ctx: dict) -> dict:
    await asyncio.sleep(0.2)
    return {"open_tickets": 3}

async def build_report(sales: dict, tickets: dict) -> str:
    # 汇聚节点只接收已经完成的分支结果,不直接关心并发细节。
    return (
        f"sales={sales['sales']} {sales['currency']}, "
        f"open_tickets={tickets['open_tickets']}"
    )

async def main() -> None:
    ctx = await prepare_context()

    # 两个分支只依赖 ctx,可以并行等待。
    sales, tickets = await asyncio.gather(
        fetch_sales(ctx),
        fetch_tickets(ctx),
    )

    report = await build_report(sales, tickets)
    print(report)

if __name__ == "__main__":
    asyncio.run(main())
预期输出:
sales=128000 CNY, open_tickets=3并行并不会改变依赖顺序:prepare_context 仍然最先结束,build_report 仍然要等两个查询都完成。它只是把两个独立 I/O 等待窗口重叠起来,因此总耗时更接近较慢分支的耗时,而不是两个分支耗时之和。
处理并行节点失败
默认 asyncio.gather 会向调用方传播首个异常,其他尚在执行的任务不会因此自动取消。若一支失败就不再需要其他支,Python 3.11 的 TaskGroup 会取消同组未结束的任务,并在退出时报告异常组。生产工作流应先定义“部分成功是否可接受”。如果销售数据缺失就不能出报告,应直接失败;如果工单系统临时不可用但允许生成降级报告,则可以捕获异常并写入缺失状态。
一个常用做法是让每个节点返回统一结构,例如 status、data、error。汇聚节点只根据这些显式状态决定继续、降级或终止,而不是依靠异常字符串猜测业务含义。
下面用事件确保慢任务已经启动,再让另一支失败,验证结构化取消。
import asyncio

async def run_group():
    started = asyncio.Event()

    async def slow():
        try:
            started.set()
            await asyncio.Event().wait()
        finally:
            print("slow cleaned up")

    async def broken():
        await started.wait()
        raise RuntimeError("required branch failed")

    try:
        async with asyncio.TaskGroup() as group:
            group.create_task(slow())
            group.create_task(broken())
    except* RuntimeError:
        print("report failed")

asyncio.run(run_group())
输出先出现 slow cleaned up,随后出现 report failed。取消是协作式的,不能撤销已经提交的外部操作。允许部分成功时应显式返回各分支状态,由汇聚器决定如何降级。
用关键路径判断是否值得并行
并行优化只对独立且耗时明显的节点有价值。如果两个节点都只需几毫秒,而创建任务、网络连接或限流等待的成本更高,并行可能没有收益。真正应该关注的是工作流的关键路径:从开始到结束,依赖链上总耗时最长的那条路径决定最终延迟。
因此,编排时先保证依赖正确,再并行独立的 I/O 节点,最后为汇聚点定义清晰的成功条件。这样既能缩短端到端延迟,也能让失败位置、重试范围和降级策略保持可控。