
AI Agent / 系统课时
实现短期对话记忆
实现短期对话记忆
短期对话记忆的目标不是“把所有历史都塞回模型”,而是在有限上下文窗口内保留当前任务所需的信息。本节用一个可运行的消息筛选器,把系统指令、高优先级事实和最近对话按规则装入窗口,并给出可验证的裁剪结果。
学习目标
- 设计“系统指令优先、重要事实次之、最近消息补足”的窗口策略
- 用明确预算限制历史长度,避免上下文无限增长
- 在裁剪后仍保持消息顺序可读,并识别不该丢失的信息
先定义窗口策略
短期记忆通常只服务于当前会话,因此最重要的是可控。一个实用的优先级可以分成三层:系统指令永远保留;被标记为高优先级的用户事实优先保留;剩余预算再从最新消息向前填充。这样既不会因为聊天变长而持续膨胀,也能降低关键约束被旧消息淹没的风险。
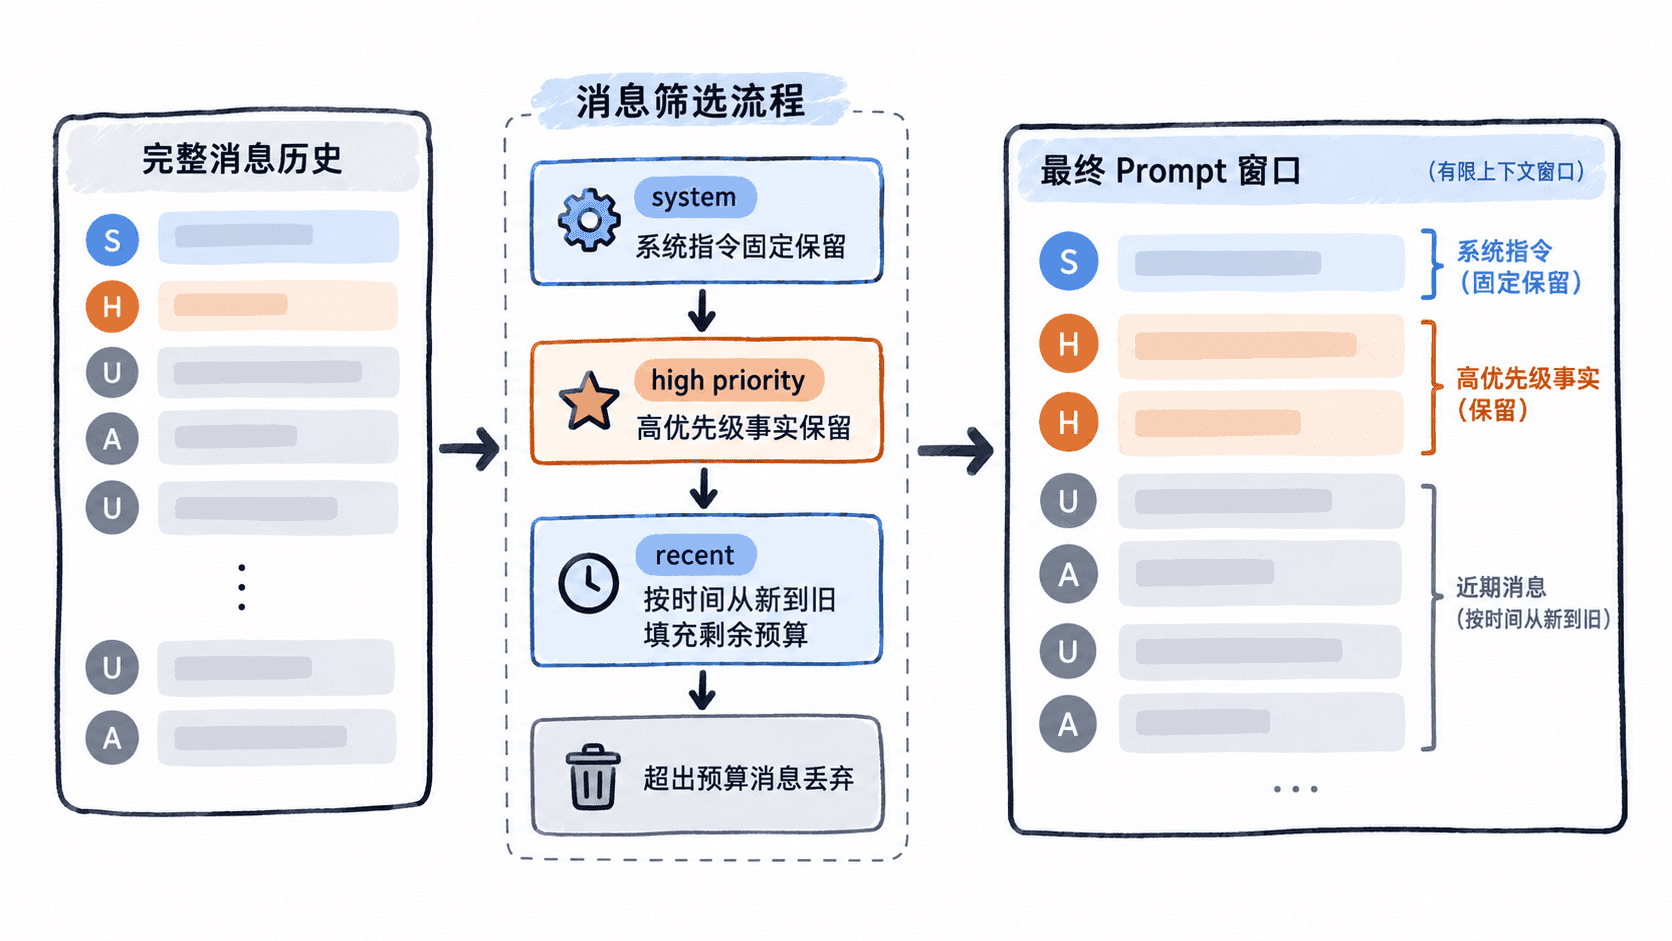
这里的“预算”可以按真实 token 数实现,也可以先用字符数做教学级近似。生产环境应使用对应模型的 tokenizer 计算 token,而不是把字符数当成精确 token 数。
实现一个可运行的筛选器
把系统规则、用户的长期约束和当前问题视为必须保留的输入。过去对话按完整轮次裁剪。一轮包含工具调用时,把助手的工具请求和对应工具结果放在同一组。
def select_history(rules, completed_turns, current, max_chars):
    if max_chars < 0:
        raise ValueError("invalid budget")
    fixed = [*rules, current]
    used = sum(len(message["content"]) for message in fixed)
    if used > max_chars:
        raise ValueError("required context exceeds budget")

    selected = []
    for turn in reversed(completed_turns):
        size = sum(len(message["content"]) for message in turn)
        if used + size > max_chars:
            break
        selected.append(turn)
        used += size
    history = [message for turn in reversed(selected) for message in turn]
    return [*rules, *history, current], used

rules = [{"role": "system", "content": "预算900元"}]
turns = [[{"role": "user", "content": "查价格"},
          {"role": "assistant", "content": "已查到酒店价格"}]]
current = {"role": "user", "content": "东京上野"}
for budget in (22, 12):
    messages, used = select_history(rules, turns, current, budget)
    print([message["role"] for message in messages], used)
22 字符时整组历史可保留。12 字符时只保留规则与当前问题。此处按字符演示。真实工具消息可能没有文本 content,还带调用 ID 和参数,计量要覆盖整条序列化消息。当前仍未回填结果的工具轮次应视为必需状态,不能从中间截断。
处理窗口变小后的边界
如果预算非常小,高优先级内容本身也可能超过窗口。此时不要简单继续堆消息,而应进入第二层策略:对较早对话做摘要,只保留任务状态、用户约束和未完成事项;对高优先级事实做去重;对已经失效的信息降低优先级或删除。
对于工具调用型 Agent,还要额外保留正在进行中的工具结果标识、未完成步骤和必要参数。否则模型虽然“记得聊天”,却可能丢失任务执行状态。
验证短期记忆是否有效
验证时不要只看能否继续聊天,而要检查三个结果:关键约束是否仍在、过期内容是否能被裁剪、窗口大小是否稳定。可以构造一段足够长的历史,再逐步缩小预算,确认系统指令、当前问题和高优先级事实要么完整保留,要么明确返回必需项超预算。
短期记忆的核心不是保存得多,而是让有限窗口始终承载“当前任务最需要的信息”。当历史开始跨会话复用,或事实需要在数天后再次检索时,就应转向长期记忆,而不是继续放大短期窗口。