
AI Agent / 系统课时
使用计划执行模式
使用计划执行模式
计划执行模式把复杂任务拆成两个层次:先得到可检查的步骤计划,再逐项执行,并在证据变化时只调整后续步骤。它比边想边做更适合多阶段任务,因为计划、执行状态和重规划条件都能被单独记录和控制。
学习目标
- 区分计划器、执行器和重规划器各自负责的决策
- 实现“生成计划—执行一步—检查结果—必要时改计划”的基本流程
- 掌握重规划时保留已完成步骤、限制改动范围和防止重复执行的方法
先把计划变成可执行状态
计划执行模式不是让模型先写一段自然语言清单就结束,而是要把计划保存成结构化状态。每个步骤至少应有动作、参数和状态;执行器只处理当前步骤,完成后写入结果,再决定是否进入下一步或触发重规划。
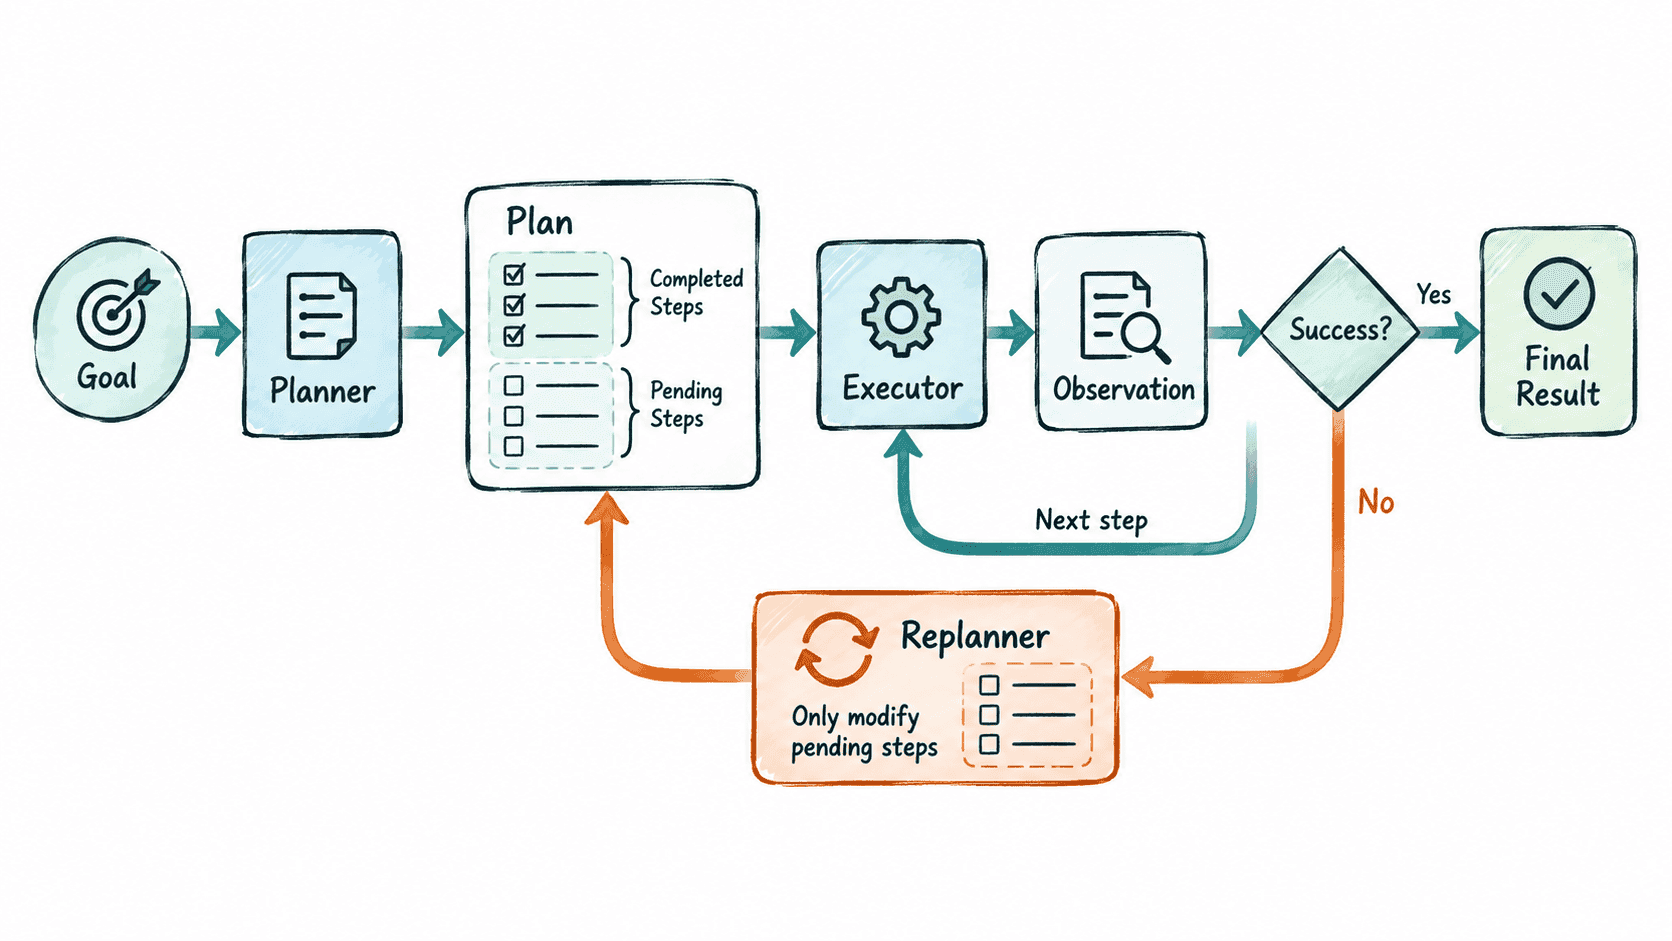
这种拆分的价值在于:计划器决定“应该有哪些步骤”,执行器只负责“执行当前一步”,重规划器只在结果改变后修正未来步骤。职责分离后,失败不会默认导致整个任务从头再跑。
实现可调整的执行器
下面的 Python 示例模拟一个资源申请任务。初始计划先申请 A100;示例预先允许 H100 作为替代项。首次检查记录两种型号的库存,A100 不足而 H100 充足时只改未执行步骤。真实替换还需核对费用、配额和明确的授权范围。
from dataclasses import dataclass, field
from typing import Any

@dataclass
class Step:
    action: str
    args: dict[str, Any]
    status: str = 'pending'
    result: dict[str, Any] | None = None

@dataclass
class PlanState:
    steps: list[Step] = field(default_factory=list)
    cursor: int = 0

INITIAL_INVENTORY = {'A100': 2, 'H100': 5}

def create_plan() -> PlanState:
    return PlanState(steps=[
        Step('check_stock', {'gpu': 'A100', 'count': 3}),
        Step('reserve', {'gpu': 'A100', 'count': 3}),
        Step('confirm', {}),
    ])

def execute(step: Step, inventory: dict[str, int]) -> dict[str, Any]:
    if step.action == 'check_stock':
        gpu = step.args['gpu']
        return {'available': inventory[gpu], 'requested': step.args['count'],
                'approved_alternative_available': inventory.get('H100', 0)}

    if step.action == 'reserve':
        gpu = step.args['gpu']
        count = step.args['count']
        if count <= 0 or inventory.get(gpu, 0) < count:
            return {'ok': False, 'reason': 'insufficient_stock'}
        inventory[gpu] -= count
        return {'ok': True, 'gpu': gpu, 'count': count}

    if step.action == 'confirm':
        return {'ok': True, 'message': 'reservation confirmed'}

    return {'ok': False, 'reason': 'unknown_action'}

def replan(state: PlanState, observation: dict[str, Any]) -> None:
    # 只改尚未执行的步骤,避免重复执行已经完成的动作。
    requested = observation['requested']
    if observation['available'] < requested <= observation['approved_alternative_available']:
        state.steps[state.cursor + 1] = Step('reserve', {'gpu': 'H100', 'count': requested})

def run(stock=None) -> PlanState:
    state = create_plan()
    inventory = dict(INITIAL_INVENTORY if stock is None else stock)

    while state.cursor < len(state.steps):
        step = state.steps[state.cursor]
        result = execute(step, inventory)
        step.result = result
        step.status = 'failed' if result.get('ok') is False else 'done'

        if step.action == 'check_stock':
            replan(state, result)

        if result.get('ok') is False:
            print(f'failed: {step.action} -> {result}')
            return state

        print(f'done: {step.action} -> {result}')
        state.cursor += 1
    return state

if __name__ == '__main__':
    run()
预期输出
done: check_stock -> {'available': 2, 'requested': 3, 'approved_alternative_available': 5}
done: reserve -> {'ok': True, 'gpu': 'H100', 'count': 3}
done: confirm -> {'ok': True, 'message': 'reservation confirmed'}这里的关键行为是:check_stock 已经执行完成,所以重规划时不重新检查,也不把 cursor 归零;系统只替换还未执行的 reserve。这比“遇错就整份计划重写并从头执行”更容易避免重复扣费、重复发信或重复创建资源。
什么时候触发重规划
不是每个结果都需要重新规划。执行成功且结果符合计划假设时,直接推进下一步;只有当前步骤失败、外部状态变化、前置假设被证伪,或用户目标发生改变时,才应进入重规划。
重规划输入最好包含原目标、已完成步骤、当前观察、剩余步骤和不可变约束。这样重规划器能明确哪些内容可以修改,哪些已经发生且不能撤销。对于有副作用的步骤,还要同时传入幂等键或资源 ID,防止模型把“调整后续计划”误写成“重复执行过去动作”。
计划粒度决定执行质量
计划太粗,例如“分析问题”“完成部署”,执行器拿不到明确动作;计划太细,例如把一次 API 调用拆成十多个微步骤,又会让重规划成本和上下文长度迅速上升。实用的粒度通常是“一步对应一次可验证的动作或一个清晰产物”。
每一步完成后都应有可判断的结果,例如 ok、状态码、文件是否生成、资源 ID 或测试是否通过。只有结果可验证,系统才能可靠地区分“继续”“重试”“换方案”和“终止”。
计划执行模式最重要的不是“先列计划”本身,而是把计划变成持久状态,并让执行和重规划围绕这份状态工作。做到已完成步骤不可随意重放、失败有明确触发条件、后续步骤可局部调整后,复杂任务才会真正具备可控的执行轨迹。