
Web 图形与 3D / 系统课时
减少数据上传和绘制调用
减少数据上传和绘制调用
同样绘制 1000 个移动方块,逐个上传数据与逐个绘制会产生大量 JavaScript 到 WebGPU 的调用。本篇制作一个可切换的演示,统计每帧上传次数、上传字节数和绘制调用数,再通过批量上传、实例化和资源复用验证优化是否生效。
学习目标
- 按帧区分上传调用次数、上传字节数与绘制调用次数。
- 使用
writeBuffer批量上传实例数据,用一次draw绘制多个实例。 - 将长期使用的 GPU 资源移出帧循环,并核对优化前后的画面与计数。
先统计什么,避免误判
假设每个方块只需要位置、尺寸和颜色参数,共 4 个 f32,每项 16 B。1000 个方块每帧需要 16000 B;如果拆成 1000 次 queue.writeBuffer,提交次数会增加,但并不会因此改变这 16000 B 的有效数据量。
| 每帧指标 | 逐对象模式 | 批量模式 |
|---|---|---|
writeBuffer 调用 |
1000 次 | 1 次 |
| 写入字节数 | 16000 B | 16000 B |
draw 调用 |
1000 次 | 1 次 |
| GPU 缓冲区与管线新建 | 0 次 | 0 次 |
按目标 60 FPS 估算,逐对象模式每秒会发起约 60000 次上传调用及 60000 次绘制调用,批量模式各为约 60 次。这些是 API 调用量,不是 GPU 执行时间;帧率是否提高仍需在同一设备、相同画面下测量。
合并上传与实例绘制
让 CPU 在一个 Float32Array 中连续写入所有实例的数据,再用一次 queue.writeBuffer(buffer, 0, data) 更新 GPU 存储缓冲区。顶点着色器使用 @builtin(instance_index) 从缓冲区读取对应记录,一次 pass.draw(6, 1000) 即可绘制 1000 个由两个三角形组成的方块。
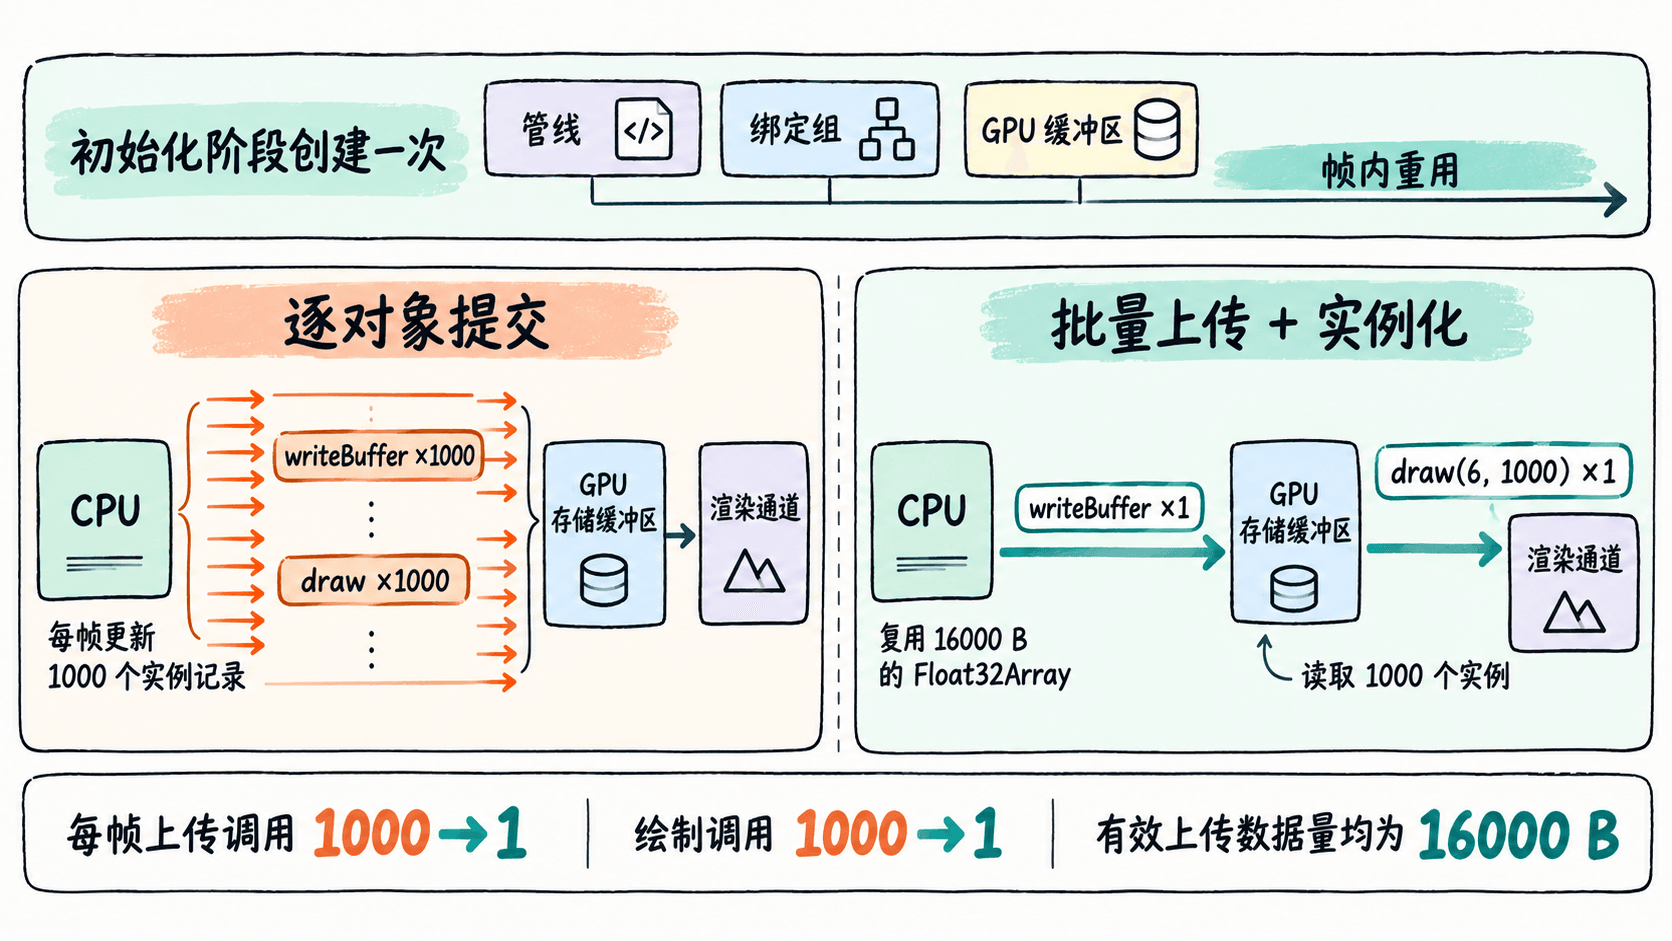
以下是完整的 index.html。按钮可切换两种提交方式,着色器、几何数量与缓冲区完全相同;变化的只有上传和绘制的调用组织方式。
<!doctype html>
<html lang='zh-CN'>
<head>
  <meta charset='utf-8'>
  <title>WebGPU 批量提交对照</title>
  <style>
    body { font: 14px sans-serif; margin: 20px; }
    canvas { display: block; max-width: 100%; margin-top: 12px; }
    #stats { margin-top: 10px; }
  </style>
</head>
<body>
  <button id='toggle'>切换为逐对象</button>
  <div id='stats'></div>
  <canvas id='screen' width='960' height='540'></canvas>
  <script type='module'>
    async function run() {
      if (!navigator.gpu) throw new Error('需要支持 WebGPU 的安全上下文');
      const adapter = await navigator.gpu.requestAdapter();
      if (!adapter) throw new Error('未找到可用 GPU 适配器');
      const device = await adapter.requestDevice();
      const canvas = document.querySelector('#screen');
      const context = canvas.getContext('webgpu');
      if (!context) throw new Error('无法获取 WebGPU 画布上下文');
      const format = navigator.gpu.getPreferredCanvasFormat();
      context.configure({ device, format, alphaMode: 'opaque' });

      const count = 1000;
      const data = new Float32Array(count * 4);
      // 只创建一次 GPU 资源,后续每帧复用。
      const buffer = device.createBuffer({
        size: data.byteLength,
        usage: GPUBufferUsage.STORAGE | GPUBufferUsage.COPY_DST
      });
      const module = device.createShaderModule({ code: `
        struct VSOut {
          @builtin(position) position: vec4f,
          @location(0) color: vec3f,
        };
        @group(0) @binding(0) var<storage, read> items: array<vec4f>;

        @vertex fn vs(
          @builtin(vertex_index) vertex: u32,
          @builtin(instance_index) instance: u32
        ) -> VSOut {
          let corners = array<vec2f, 6>(
            vec2f(-1.0, -1.0), vec2f(1.0, -1.0),
            vec2f(-1.0, 1.0), vec2f(-1.0, 1.0),
            vec2f(1.0, -1.0), vec2f(1.0, 1.0)
          );
          let item = items[instance];
          var out: VSOut;
          out.position = vec4f(item.xy + corners[vertex] * item.z, 0.0, 1.0);
          out.color = vec3f(0.1 + item.w * 0.4, 0.6, 0.85 - item.w * 0.5);
          return out;
        }
        @fragment fn fs(input: VSOut) -> @location(0) vec4f {
          return vec4f(input.color, 1.0);
        }
      ` });
      const pipeline = device.createRenderPipeline({
        layout: 'auto',
        vertex: { module, entryPoint: 'vs' },
        fragment: { module, entryPoint: 'fs', targets: [{ format }] },
        primitive: { topology: 'triangle-list' }
      });
      const bindGroup = device.createBindGroup({
        layout: pipeline.getBindGroupLayout(0),
        entries: [{ binding: 0, resource: { buffer } }]
      });

      const stats = document.querySelector('#stats');
      const button = document.querySelector('#toggle');
      let batched = true;
      button.addEventListener('click', () => {
        batched = !batched;
        button.textContent = batched ? '切换为逐对象' : '切换为批量';
      });

      function frame(ms) {
        // 同样计算 1000 个方块的位置,保证两种模式可比。
        for (let i = 0; i < count; i++) {
          const k = i * 4;
          data[k] = -0.95 + ((i % 40) + 0.5) * 1.9 / 40
                    + Math.sin(ms * 0.001 + i * 0.1) * 0.005;
          data[k + 1] = -0.88 + (Math.floor(i / 40) + 0.5) * 1.76 / 25;
          data[k + 2] = 0.016;
          data[k + 3] = (i % 7) / 7;
        }

        let uploads = 0;
        if (batched) {
          device.queue.writeBuffer(buffer, 0, data);
          uploads = 1;
        } else {
          for (let i = 0; i < count; i++) {
            // TypedArray 的 dataOffset/size 单位是元素,目标偏移是字节。
            device.queue.writeBuffer(buffer, i * 16, data, i * 4, 4);
            uploads++;
          }
        }

        const encoder = device.createCommandEncoder();
        const pass = encoder.beginRenderPass({
          colorAttachments: [{
            view: context.getCurrentTexture().createView(),
            clearValue: { r: 1, g: 1, b: 1, a: 1 },
            loadOp: 'clear', storeOp: 'store'
          }]
        });
        pass.setPipeline(pipeline);
        pass.setBindGroup(0, bindGroup);
        let draws = 0;
        if (batched) {
          pass.draw(6, count);
          draws = 1;
        } else {
          for (let i = 0; i < count; i++) {
            pass.draw(6, 1, 0, i);
            draws++;
          }
        }
        pass.end();
        device.queue.submit([encoder.finish()]);
        stats.textContent = `${batched ? '批量' : '逐对象'}:上传 ${uploads} 次 / ${data.byteLength} B;绘制 ${draws} 次 / ${count} 实例`;
        requestAnimationFrame(frame);
      }
      requestAnimationFrame(frame);
    }
    run().catch(error => {
      document.querySelector('#stats').textContent = error.message;
    });
  </script>
</body>
</html>
预期结果:画布显示 1000 个持续微动的小方块。页面统计初始显示:
批量:上传 1 次 / 16000 B;绘制 1 次 / 1000 实例点击「切换为逐对象」后显示:
逐对象:上传 1000 次 / 16000 B;绘制 1000 次 / 1000 实例运行与核对
将代码保存为 index.html,在文件所在目录执行以下命令(需要 Python 3),然后用支持 WebGPU 的浏览器打开 http://127.0.0.1:8000/。WebGPU 要求安全上下文,localhost 与回环地址通常可用于本地开发。
python3 -m http.server 8000 --bind 127.0.0.1预期输出(服务器启动后保持运行):
Serving HTTP on 127.0.0.1 port 8000 (http://127.0.0.1:8000/) ...打开浏览器开发者工具的 Performance 面板,分别在两种模式下录制相同长度的片段,比较脚本与渲染命令编码的 CPU 开销,并重复测量。示例计数直接在对应调用处累加,不代表浏览器内部合并后的命令数;上传量只统计本例的 writeBuffer 数据。
把优化用于真实项目
实际项目应将静态网格、纹理、采样器、渲染管线和绑定组的创建放在初始化或资源变化时执行,而不是每帧重建。帧循环仅更新确实变化的数据;例如 1000 个对象中只有 20 个位置变化时,可将脏记录排序并合并成连续范围,减少上传字节,必要时用数次 writeBuffer 更新这些范围,不必强行重传全部 16000 B。
同材质、同管线和同网格的对象通常适合实例化;纹理或材质不同、透明物体需要严格排序时不能盲目合批。还要分开记录 writeTexture 的纹理上传、drawIndexed 的绘制调用及每帧新建的 GPU 资源数量,避免只优化了 draw 却遗漏其他提交开销。
当上传调用数和绘制调用数降低、总数据量与画面保持一致,说明批量组织已经正确生效;若需要进一步提升帧率,再针对实测瓶颈减少更新范围、着色器成本或绘制像素数。