
Web 图形与 3D / 系统课时
按 WGSL 对齐规则布局结构体
按 WGSL 对齐规则布局结构体
向 WebGPU 缓冲区写入结构体时,字段偏移只要错几个字节,着色器就可能读到错误值。本课使用矩阵、三维向量和标量组成一个真实参数块,逐项算出对齐与大小,再用 JavaScript 写入 80 字节数据并让 GPU 读回验证。
学习目标
- 根据 WGSL 的对齐、大小和数组步长规则计算字节偏移。
- 正确安排
mat3x3f、vec3f、f32与u32字段及末尾填充。 - 使用
DataView写入二进制数据,并通过计算着色器验证读取结果。
先区分对齐、大小和步长
**对齐(AlignOf)**决定字段起点必须落在哪个字节倍数上;**大小(SizeOf)**是字段实际占用的字节范围;**步长(StrideOf)**是数组中相邻元素起点之间的距离。三者并不总相等。
| WGSL 类型 | 对齐(字节) | 大小(字节) | 关键区别 |
|---|---|---|---|
f32、u32、i32 |
4 | 4 | 单个数值 |
vec2f |
8 | 8 | 两个 32 位分量 |
vec3f |
16 | 12 | 起点按 16 对齐,数据仅 12 字节 |
vec4f |
16 | 16 | 对齐与大小均为 16 |
mat3x3f |
16 | 48 | 三列,每列占 16 字节步长 |
mat4x4f |
16 | 64 | 四列,每列 16 字节 |
计算结构体时,从偏移 0 开始,将每个字段起点向上取整到其对齐倍数,再加上字段大小。结构体整体对齐取所有成员对齐的最大值,最终大小也须向上取整到该对齐倍数。例如 array<vec3f, 4> 的元素步长是 16 字节,合计占 64 字节,而非 48 字节。完整定义可查 WGSL 内存布局规范。
算出参数结构体的字节位置
下面设计一个供 var<uniform> 使用的 Params:矩阵缩放方向,intensity 控制强度,count 保留一个整数标识。按声明顺序排布,不按 JavaScript 对象属性或数组元素数目推测字节位置。
| 字段与 WGSL 类型 | 起始偏移 | 数据大小 | 下个可用偏移 |
|---|---|---|---|
basis: mat3x3f |
0 | 48 | 48 |
direction: vec3f |
48 | 12 | 60 |
intensity: f32 |
60 | 4 | 64 |
count: u32 |
64 | 4 | 68 |
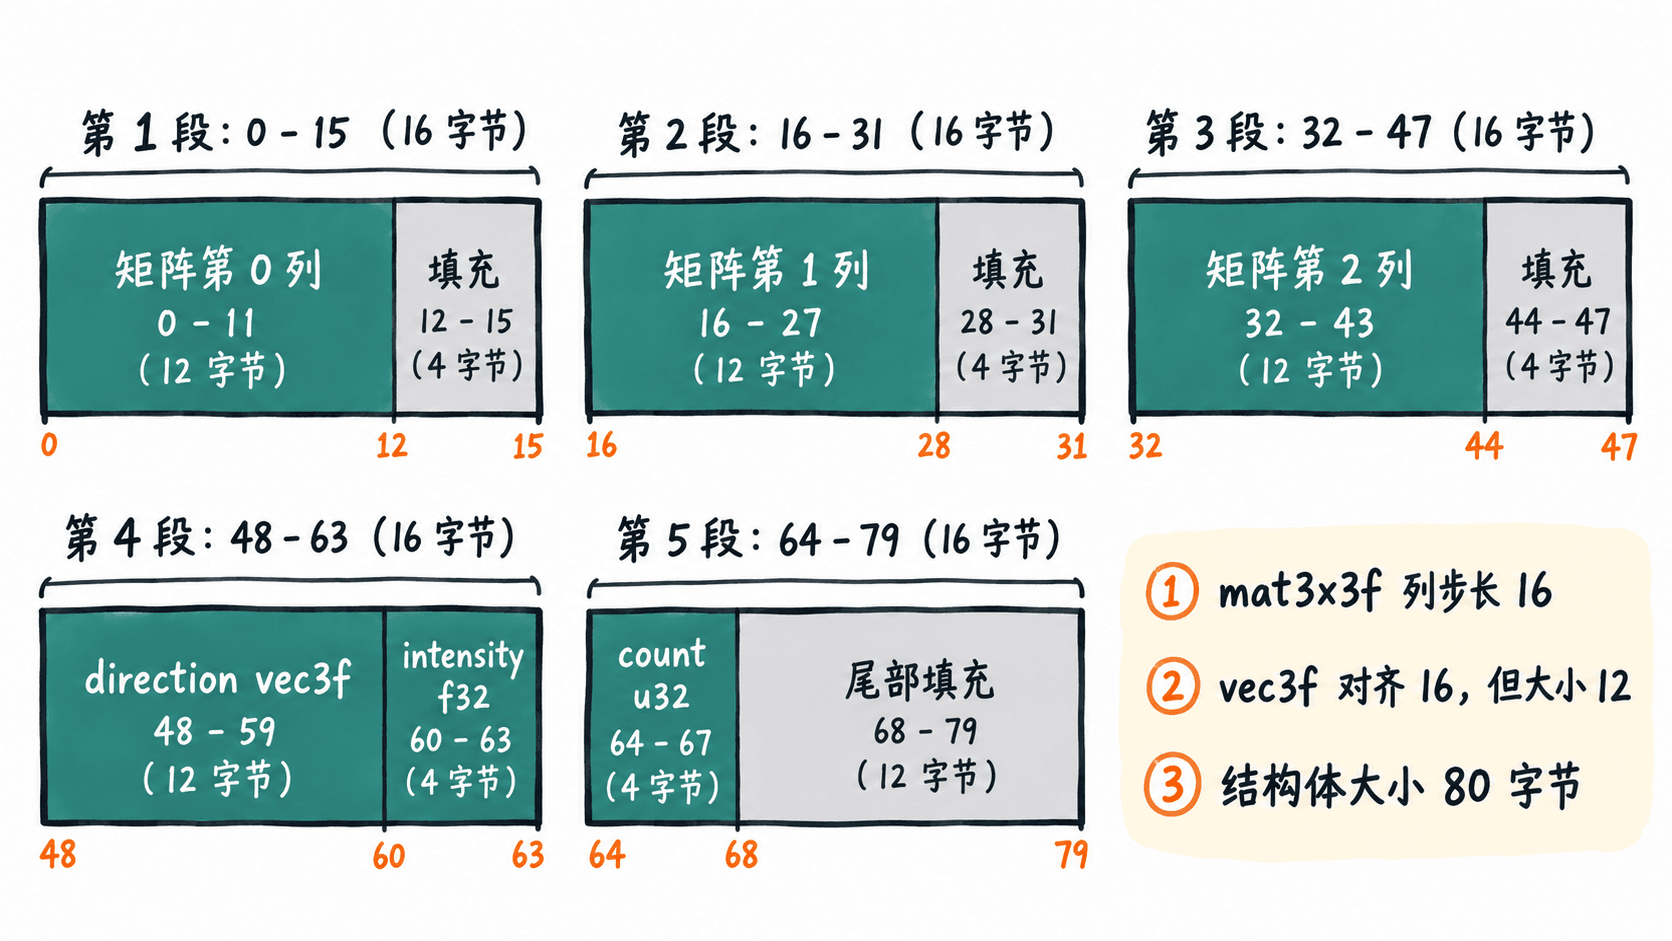
| 结构体尾部填充 | 68 | 12 | 80 |
basis 的三列分别从 0、16、32 字节开始,每列仅有 3 个有效 f32,第四个 4 字节位置是填充。vec3f 后面并不强制空出 4 字节:紧接的 f32 只要求 4 字节对齐,因此可以从偏移 60 开始。最后一个数据字节落在 67,结构体按 16 字节对齐,故总大小为 80 字节。
用 JavaScript 写入并让 GPU 检查
在支持 WebGPU 的浏览器中,打开 HTTPS 页面或 localhost,将以下完整 JavaScript 粘贴到开发者工具 Console 执行。示例定义计算着色器:将对角矩阵 (1, 2, 3) 乘方向向量 (2, 3, 4),再乘强度 0.5,并把整数 7 写入输出的第四个分量。
(async () => {
  if (!navigator.gpu) throw new Error("当前环境不支持 WebGPU");
  const adapter = await navigator.gpu.requestAdapter();
  if (!adapter) throw new Error("未找到可用 GPUAdapter");
  const device = await adapter.requestDevice();

  const shader = device.createShaderModule({ code: `
    struct Params {
      basis: mat3x3f,
      direction: vec3f,
      intensity: f32,
      count: u32,
    };
    struct Result { value: vec4f, };
    @group(0) @binding(0) var<uniform> params: Params;
    @group(0) @binding(1) var<storage, read_write> result: Result;

    @compute @workgroup_size(1)
    fn main() {
      let v = (params.basis * params.direction) * params.intensity;
      result.value = vec4f(v, f32(params.count));
    }
  ` });

  const bytes = new ArrayBuffer(80);
  const view = new DataView(bytes);
  // mat3x3f 按列存储,三列起点分别是 0、16、32 字节。
  view.setFloat32(0, 1, true);
  view.setFloat32(20, 2, true);
  view.setFloat32(40, 3, true);
  // vec3f 的 12 字节后,可以紧接一个 f32。
  [2, 3, 4, 0.5].forEach((n, i) => view.setFloat32(48 + i * 4, n, true));
  view.setUint32(64, 7, true);

  const uniforms = device.createBuffer({
    size: 80, usage: GPUBufferUsage.UNIFORM | GPUBufferUsage.COPY_DST,
  });
  const output = device.createBuffer({
    size: 16, usage: GPUBufferUsage.STORAGE | GPUBufferUsage.COPY_SRC,
  });
  const readback = device.createBuffer({
    size: 16, usage: GPUBufferUsage.COPY_DST | GPUBufferUsage.MAP_READ,
  });
  device.queue.writeBuffer(uniforms, 0, bytes);

  const pipeline = device.createComputePipeline({
    layout: "auto", compute: { module: shader, entryPoint: "main" },
  });
  const bindGroup = device.createBindGroup({
    layout: pipeline.getBindGroupLayout(0),
    entries: [
      { binding: 0, resource: { buffer: uniforms } },
      { binding: 1, resource: { buffer: output } },
    ],
  });

  const encoder = device.createCommandEncoder();
  const pass = encoder.beginComputePass();
  pass.setPipeline(pipeline);
  pass.setBindGroup(0, bindGroup);
  pass.dispatchWorkgroups(1);
  pass.end();
  encoder.copyBufferToBuffer(output, 0, readback, 0, 16);
  device.queue.submit([encoder.finish()]);

  await readback.mapAsync(GPUMapMode.READ);
  const values = Array.from(new Float32Array(readback.getMappedRange()));
  readback.unmap();
  console.log("uniform bytes:", bytes.byteLength);
  console.log("GPU result:", JSON.stringify(values));
})().catch(console.error);
预期输出(浏览器可能另外显示 Promise 对象):
uniform bytes: 80
GPU result: [1,3,6,7]
这里 DataView.setFloat32 与 setUint32 的第三个参数 true 表示按小端字节序写入。未写入的位置由 ArrayBuffer 初始化为零。若 GPU 读回 [1, 3, 6, 7],表示矩阵列步长、字段偏移、数据类型和总长度在这一用例中一致。
避免几种常见布局错误
- 把
mat3x3f当作连续 9 个浮点数。 实际每列有 4 字节填充;第二、三列起点是偏移 16 与 32,而非 12 与 24。 - 给每个
vec3f后面都补 4 字节。 单个结构体成员后是否留空取决于下一成员的对齐;本例的intensity正确偏移为 60,但array<vec3f, N>的相邻元素步长确为 16。 - 以为所有
array<f32, N>都能直接放进 uniform。 默认的 uniform 布局还要求数组元素步长是 16 的倍数;可使用带@size(16)成员的包装结构体,或改为按vec4f分组。storage 缓冲区中的array<f32, N>通常按 4 字节步长排布。 - 将
bool或 JavaScript 对象直接上传。 WGSLbool不是可供主机共享的缓冲区字段;用u32表示 0/1。queue.writeBuffer应接收按字节排好的ArrayBuffer或 TypedArray,而不是普通对象。 - 混淆字段对齐和动态绑定偏移。 若使用 uniform 的动态偏移,还要满足
device.limits.minUniformBufferOffsetAlignment(常见为 256 字节);它限制绑定起点,不要求本例每个字段都按 256 字节对齐。
遇到读回值不对,先重新计算 OffsetOfMember 和结构体总大小,再检查矩阵列顺序、u32 与 f32 的写入方法,最后检查缓冲区绑定长度。对齐问题通常可以在这一层定位,无须先修改着色器的计算公式。