
Web 图形与 3D / 系统课时
创建 BindGroup 绑定共享资源
创建 BindGroup 绑定共享资源
一次 WebGPU 计算可能要同时读取参数和写入数组。本篇将两个 GPUBuffer 组合进同一个 BindGroup,让 WGSL 按固定编号访问资源,再执行一次计算并读回结果。完成后,你能核对声明、布局、实际缓冲区和管线位置是否一致。
学习目标
- 区分 BindGroupLayout 的资源契约与 BindGroup 的实际资源绑定。
- 对齐 WGSL 的
@group、@binding与 JavaScript 中的编号和可见阶段。 - 运行包含 Uniform 和 Storage Buffer 的计算,并验证四个输出值。
对齐组号、绑定号与资源类型
@group(0) 指资源组位于管线布局的第 0 个槽位,编码时必须调用 pass.setBindGroup(0, bindGroup)。组内 @binding(0)、@binding(1) 则分别对应布局与资源表中的 binding: 0、binding: 1。组号和绑定号是两套独立编号,不能互换。
| WGSL 声明 | Layout 资源类型 | Buffer 用途 | 可见阶段 |
|---|---|---|---|
@group(0) @binding(0) var<uniform> |
uniform |
UNIFORM |
COMPUTE |
@group(0) @binding(1) var<storage, read_write> |
storage |
STORAGE |
COMPUTE |
BindGroupLayout 规定编号、资源种类、最小绑定大小和着色器阶段;BindGroup 则把具体缓冲区填进这些槽位。管线使用该布局,计算通道再绑定对应的 BindGroup,WGSL 才能访问缓冲区。这里两个资源都在计算着色器中使用,因此 visibility 设为 GPUShaderStage.COMPUTE。
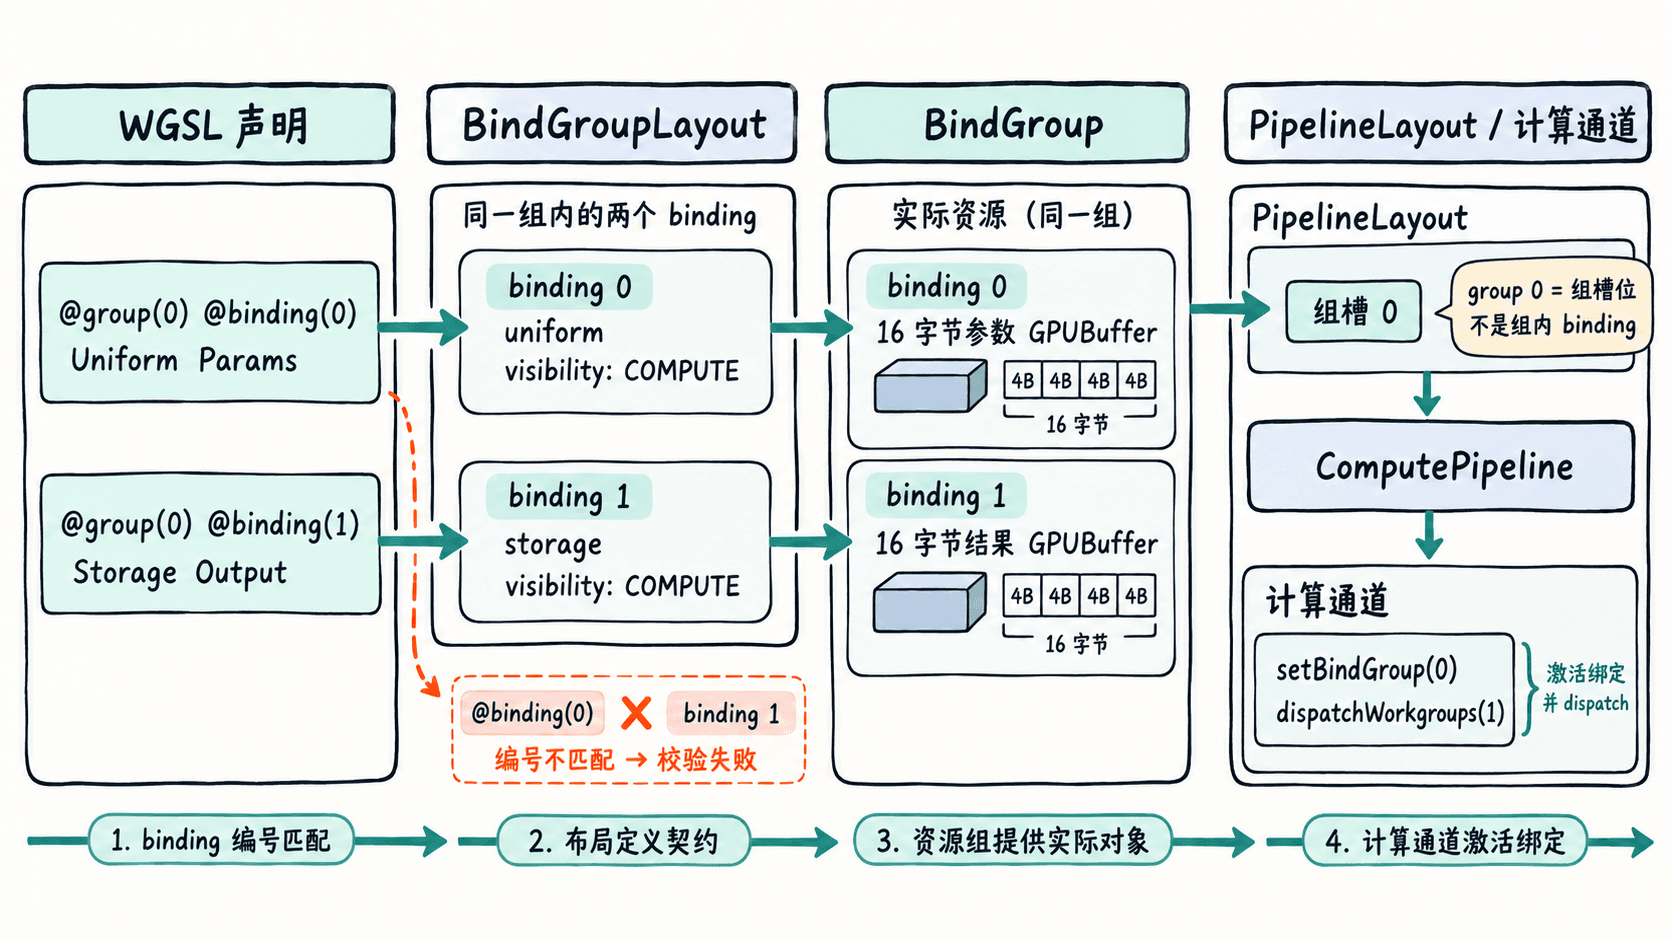
运行两个缓冲区的完整示例
在支持 WebGPU 的浏览器中打开 HTTPS 页面或本机 http://localhost 页面,将以下 JavaScript 粘贴到开发者工具控制台。示例创建 16 字节的参数缓冲区与结果缓冲区:参数 [2, 1, 0, 0] 表示用 2 × 索引 + 1 计算四个结果;结果通过只用于读回的缓冲区传回 CPU。
async function runBindGroupDemo() {
  if (!navigator.gpu) throw new Error("当前环境不支持 WebGPU");
  const adapter = await navigator.gpu.requestAdapter();
  if (!adapter) throw new Error("未获得 GPUAdapter");
  const device = await adapter.requestDevice();

  const shader = device.createShaderModule({
    code: `
      struct Params { scaleAndOffset: vec4<f32>, };
      @group(0) @binding(0) var<uniform> params: Params;
      @group(0) @binding(1) var<storage, read_write> output: array<f32>;

      @compute @workgroup_size(4)
      fn main(@builtin(global_invocation_id) id: vec3<u32>) {
        if (id.x < 4u) {
          output[id.x] = f32(id.x) * params.scaleAndOffset.x
                       + params.scaleAndOffset.y;
        }
      }
    `,
  });

  // 布局只声明资源契约,不包含实际缓冲区。
  const layout = device.createBindGroupLayout({
    entries: [
      { binding: 0, visibility: GPUShaderStage.COMPUTE,
        buffer: { type: "uniform", minBindingSize: 16 } },
      { binding: 1, visibility: GPUShaderStage.COMPUTE,
        buffer: { type: "storage", minBindingSize: 16 } },
    ],
  });
  const pipeline = device.createComputePipeline({
    layout: device.createPipelineLayout({ bindGroupLayouts: [layout] }),
    compute: { module: shader, entryPoint: "main" },
  });

  const paramsBuffer = device.createBuffer({
    size: 16, usage: GPUBufferUsage.UNIFORM | GPUBufferUsage.COPY_DST,
  });
  const outputBuffer = device.createBuffer({
    size: 16, usage: GPUBufferUsage.STORAGE | GPUBufferUsage.COPY_SRC,
  });
  const readback = device.createBuffer({
    size: 16, usage: GPUBufferUsage.COPY_DST | GPUBufferUsage.MAP_READ,
  });
  device.queue.writeBuffer(paramsBuffer, 0, new Float32Array([2, 1, 0, 0]));

  // BindGroup 将布局槽位与实际 GPUBuffer 对应起来。
  const bindGroup = device.createBindGroup({
    layout,
    entries: [
      { binding: 0, resource: { buffer: paramsBuffer } },
      { binding: 1, resource: { buffer: outputBuffer } },
    ],
  });
  const encoder = device.createCommandEncoder();
  const pass = encoder.beginComputePass();
  pass.setPipeline(pipeline);
  pass.setBindGroup(0, bindGroup); // 与 WGSL 的 @group(0) 对应
  pass.dispatchWorkgroups(1);
  pass.end();

  // Storage Buffer 不直接映射读取,先复制到 MAP_READ 缓冲区。
  encoder.copyBufferToBuffer(outputBuffer, 0, readback, 0, 16);
  device.queue.submit([encoder.finish()]);
  await readback.mapAsync(GPUMapMode.READ);
  console.log(Array.from(new Float32Array(readback.getMappedRange())));
  readback.unmap();
  paramsBuffer.destroy();
  outputBuffer.destroy();
  readback.destroy();
}
runBindGroupDemo().catch(console.error);
预期输出(浏览器控制台显示为数组,呈现形式可能略有差异):
[1, 3, 5, 7]@workgroup_size(4) 配合 dispatchWorkgroups(1) 启动四个调用,索引依次为 0~3。两个绑定的有效范围都是 16 字节;Uniform 用一个 vec4<f32> 避免了结构体对齐歧义,Storage 保存四个 f32。数据先由 CPU 写入参数缓冲区,计算着色器写入结果缓冲区,最后经过复制和映射读回。
排查布局不匹配
如果结果未出现,先检查浏览器是否支持 WebGPU、页面是否处于安全上下文,再查看开发者工具中的 GPUValidationError。WebGPU 校验失败可能发生在创建管线、创建资源组或提交绘制与计算命令时,不能只看 JavaScript 是否抛出异常。
- 绑定号不一致:WGSL 使用
@binding(1),但布局或 BindGroup 填了binding: 2。修正三处编号,并确保布局中的每个条目都有对应资源。 - 访问类型不一致:
var<storage, read_write>需要布局的buffer.type: "storage"和缓冲区的GPUBufferUsage.STORAGE;只读 Storage 对应read-only-storage。 - 阶段或组槽错误:当前着色器在
COMPUTE阶段访问资源,布局不能仅暴露给FRAGMENT;@group(0)也不能用setBindGroup(1, ...)代替。 - 绑定大小或偏移错误:本例两个绑定均从偏移 0 开始、大小为 16 字节。非零 Uniform 或 Storage 绑定偏移须分别满足
device.limits.minUniformBufferOffsetAlignment、minStorageBufferOffsetAlignment;不要假设任何字节偏移都合法。
复用资源组的边界
同一批 GPUBuffer 可以在多次 dispatchWorkgroups 中通过原 BindGroup 重复绑定,不需要每帧重新创建布局。只更新参数时,可以在后续提交前调用 device.queue.writeBuffer(paramsBuffer, 0, ...);但示例末尾已销毁缓冲区,继续复用前必须保留它们并延后清理。
如果两个渲染阶段都要读取同一 Uniform,可把对应条目的 visibility 写成 GPUShaderStage.VERTEX | GPUShaderStage.FRAGMENT,前提是管线着色器的声明与布局匹配。改变资源种类、绑定数量或布局结构时,应重新检查管线布局和资源组的兼容性。BindGroup 复用的是绑定关系,不会复制缓冲区内容。