
Web 图形与 3D / 系统课时
用原子操作避免并发写入冲突
用原子操作避免并发写入冲突
当上千个计算调用同时给同一个计数器加一时,普通读改写可能丢失更新。本课用 WebGPU 的 atomicAdd 实现跨工作组计数,并从 GPU 异步读回结果,确认最终数值与有效调用数一致。
学习目标
- 识别并发读改写造成的丢失更新,说明原子操作解决的范围。
- 在 WGSL 存储缓冲区中使用
atomic<u32>和atomicAdd。 - 运行完整的 WebGPU 计数示例,检查读回数值及越界保护。
普通加一为什么会丢更新
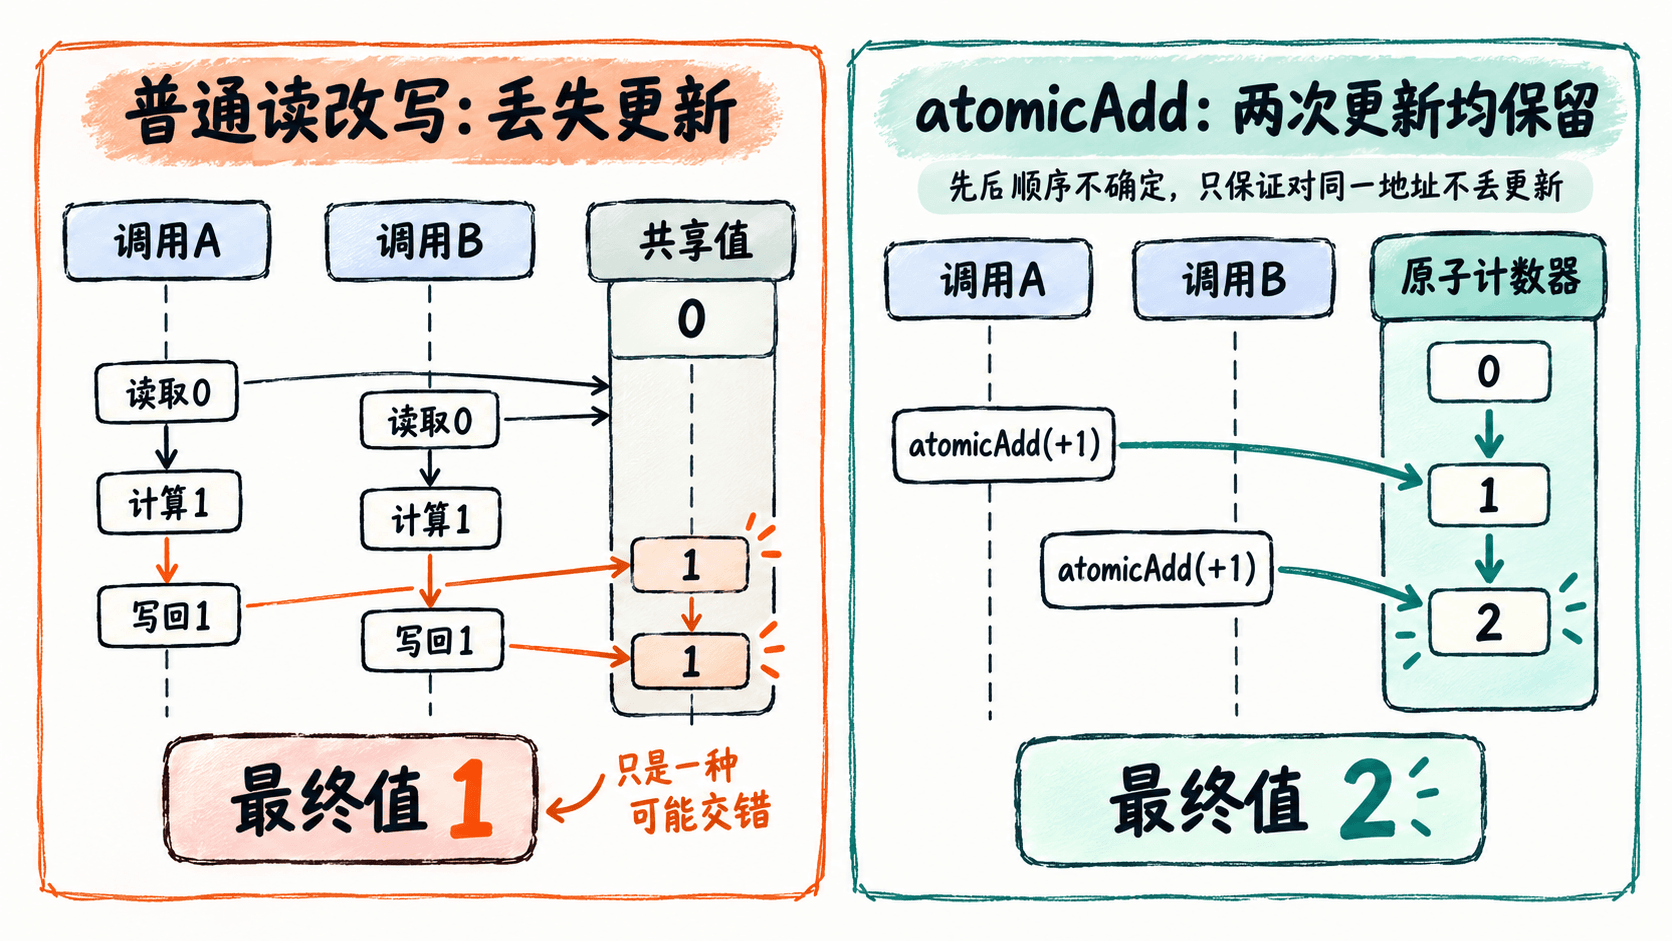
假设共享计数器初值为 0,调用 A、B 都执行“读取、加一、写回”。一种可能的交错是:A 读到 0,B 也读到 0;两者各自算出 1,最后先后写回 1。明明执行了两次加一,结果却只有 1。
这就是丢失更新。对普通 u32 变量执行 counter.value = counter.value + 1u 并不是原子操作。在 WGSL 中,让多个并发调用直接读写同一普通存储变量会形成数据竞争,实际结果不具备可靠保证;即使某次恰好得到正确数值,也不能据此认定写法安全。
原子变量和操作的边界
WGSL 用 atomic<u32> 或 atomic<i32> 声明原子整数;它们可位于 var<workgroup>,或 var<storage, read_write> 的存储缓冲区中。跨工作组共享计数应选择存储缓冲区,不能指望各工作组各自的 workgroup 变量合并成一个值。
atomicAdd(&counter.value, 1u) 将“读取旧值、加一、写回”合成一次原子读改写,并返回更新前的值。例如初值为 5 时返回 5,内存中的值变为 6。atomicLoad 负责原子读取,atomicStore 负责原子写入;原子类型不能用普通赋值或 += 更新。
在浏览器中运行原子计数
在支持 WebGPU 的桌面浏览器中打开 HTTPS 页面或 localhost 页面,再打开开发者工具的 Console,粘贴并运行下列完整 JavaScript。示例启动 16 个工作组、每组 64 个调用,共 1024 个调用;只有前 1000 个调用会执行加一。
(async () => {
  if (!navigator.gpu) throw new Error("此浏览器或页面不支持 WebGPU");
  const adapter = await navigator.gpu.requestAdapter();
  if (!adapter) throw new Error("未找到可用的 GPU 适配器");
  const device = await adapter.requestDevice();
  const count = 1000;
  const groupSize = 64;

  const shader = `
struct Counter {
  value: atomic<u32>,
};
@group(0) @binding(0) var<storage, read_write> counter: Counter;

@compute @workgroup_size(64)
fn main(@builtin(global_invocation_id) id: vec3<u32>) {
  if (id.x >= ${count}u) { return; } // 过滤最后一个工作组的多余调用
  atomicAdd(&counter.value, 1u);    // 每个有效调用只加一次
}`;

  const module = device.createShaderModule({ code: shader });
  const pipeline = device.createComputePipeline({
    layout: "auto",
    compute: { module, entryPoint: "main" },
  });
  const storage = device.createBuffer({
    size: 4,
    usage: GPUBufferUsage.STORAGE |
      GPUBufferUsage.COPY_SRC | GPUBufferUsage.COPY_DST,
  });
  const readback = device.createBuffer({
    size: 4,
    usage: GPUBufferUsage.COPY_DST | GPUBufferUsage.MAP_READ,
  });
  // 派发之前将原子计数器的底层 4 字节清零
  device.queue.writeBuffer(storage, 0, new Uint32Array([0]));

  const bindGroup = device.createBindGroup({
    layout: pipeline.getBindGroupLayout(0),
    entries: [{ binding: 0, resource: { buffer: storage } }],
  });
  const encoder = device.createCommandEncoder();
  const pass = encoder.beginComputePass();
  pass.setPipeline(pipeline);
  pass.setBindGroup(0, bindGroup);
  pass.dispatchWorkgroups(Math.ceil(count / groupSize));
  pass.end();
  // 存储缓冲区不能直接 MAP_READ,先复制到暂存缓冲区
  encoder.copyBufferToBuffer(storage, 0, readback, 0, 4);
  device.queue.submit([encoder.finish()]);

  await readback.mapAsync(GPUMapMode.READ);
  const result = new Uint32Array(readback.getMappedRange())[0];
  readback.unmap();
  console.log(`原子计数:${result}`);
  storage.destroy();
  readback.destroy();
})().catch(console.error);
预期输出:
原子计数:1000Math.ceil(1000 / 64) = 16,共启动 1024 个调用,其中 24 个因索引检查返回。storage 使用 STORAGE | COPY_SRC | COPY_DST,以便计算、复制和初始化;readback 只使用 COPY_DST | MAP_READ。提交的计算和复制按编码顺序执行,mapAsync 完成后再读取,不需要用固定延时等待 GPU。
验证结果与处理热点竞争
重复执行三次,应每次都得到 1000。把 count 改为 4097 后,由于 WGSL 的上界由 JavaScript 模板同步生成,预期结果应变为 4097;工作组数增加到 65,总调用数为 4160,其余 63 个不更新计数器。
如果结果变成累加值,检查是否在每轮派发之前通过 queue.writeBuffer 或独立清零通道把计数器重置为 0。如果报资源使用错误,检查读回缓冲区是否错误地同时设置了 MAP_READ 和 STORAGE。
单个全局原子地址在大量调用同时更新时容易形成性能热点。真实粒子模拟常先在每个工作组内汇总局部数量,再由每个工作组执行一次全局 atomicAdd:例如 1024 个工作组、每组 64 个粒子,最多可把全局原子加法从 65536 次减少到 1024 次,但组内归约仍需要正确的同步。