
Web 图形与 3D / 系统课时
配置共享内存与工作组屏障
配置共享内存与工作组屏障
当同一工作组内的多个 GPU 调用需要交换中间结果时,可以把数据放入 workgroup 共享内存,并用屏障保证读写顺序。这里用 16 个整数分成两组求和,得到两个可验证的局部结果,同时看清哪些同步无法跨越工作组边界。
学习目标
- 使用
var<workgroup>分配组内共享数组,并估算占用空间。 - 在并行归约中正确放置
workgroupBarrier(),避免数据竞争。 - 判断何时需要额外一次计算派发来汇总不同工作组的结果。
共享内存的作用范围
WGSL 的 var<workgroup> 声明在模块作用域,同一工作组的全部调用访问同一份数据;不同工作组各有独立副本。本例每组 8 个 u32,共占 8 × 4 = 32 字节,@workgroup_size(8) 配合两组派发处理 16 个输入。
@builtin(local_invocation_index) 在每组内取值 0~7,适合索引共享数组;@builtin(workgroup_id) 则标识第 0 组或第 1 组。工作组共享存储的大小不能超过 device.limits.maxComputeWorkgroupStorageSize(默认限额为 16384 字节),线程数也不能超过 device.limits.maxComputeInvocationsPerWorkgroup(默认 256)。
屏障如何保证归约顺序
8 个调用首先分别写入共享数组。若调用 0 立即读取调用 4 应写入的位置,可能读到尚未写好的数据,因此写入完成后必须让整组经过 workgroupBarrier()。然后按跨度 4、2、1 依次合并,每轮更新后再同步,最终由调用 0 写出组内总和。
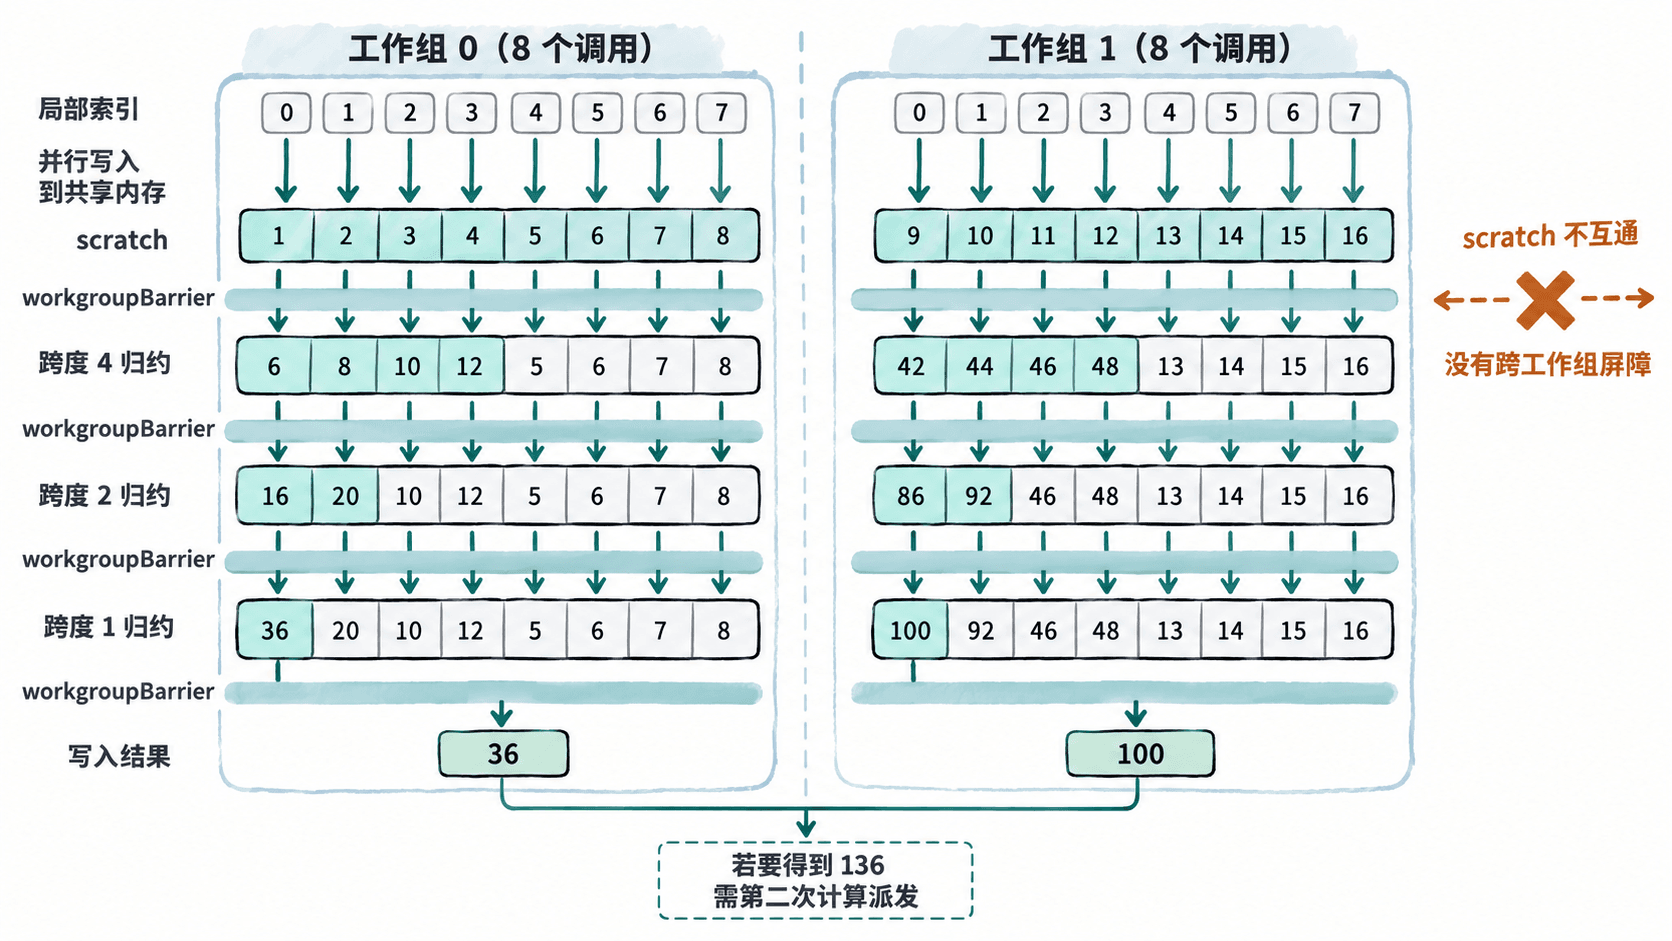
workgroupBarrier() 必须位于组内一致的控制流中。可以只让 lid < stride 的线程进行加法,但屏障必须放在条件语句之外,确保这一组的所有调用都执行它。
运行两个工作组的并行求和
在支持 WebGPU 的浏览器中打开 HTTPS 或 localhost 页面,再到开发者工具控制台运行以下完整 JavaScript。代码用两个工作组对 1~16 求局部和,将结果写入存储缓冲区,再回读到 CPU。
async function main() {
  const adapter = await navigator.gpu?.requestAdapter();
  if (!adapter) throw new Error("需要支持 WebGPU 的安全上下文");
  const device = await adapter.requestDevice();

  const module = device.createShaderModule({ code: `
@group(0) @binding(0) var<storage, read> values: array<u32>;
@group(0) @binding(1) var<storage, read_write> sums: array<u32>;
var<workgroup> scratch: array<u32, 8>;

@compute @workgroup_size(8)
fn main(
  @builtin(local_invocation_index) lid: u32,
  @builtin(workgroup_id) gid: vec3<u32>
) {
  let index = gid.x * 8u + lid;
  scratch[lid] = values[index];
  workgroupBarrier(); // 全组写入后才允许读取其他线程的数据

  for (var stride = 4u; stride > 0u; stride = stride / 2u) {
    if (lid < stride) {
      scratch[lid] = scratch[lid] + scratch[lid + stride];
    }
    workgroupBarrier(); // 每轮所有调用都必须经过屏障
  }
  if (lid == 0u) {
    sums[gid.x] = scratch[0];
  }
}
` });
  const pipeline = device.createComputePipeline({
    layout: "auto",
    compute: { module, entryPoint: "main" }
  });

  const input = device.createBuffer({
    size: 64,
    usage: GPUBufferUsage.STORAGE | GPUBufferUsage.COPY_DST
  });
  const output = device.createBuffer({
    size: 8,
    usage: GPUBufferUsage.STORAGE | GPUBufferUsage.COPY_SRC
  });
  const readback = device.createBuffer({
    size: 8,
    usage: GPUBufferUsage.COPY_DST | GPUBufferUsage.MAP_READ
  });
  // 输入16个u32,每组读取连续8个
  device.queue.writeBuffer(input, 0, new Uint32Array(
    Array.from({ length: 16 }, (_, i) => i + 1)
  ));
  const bindGroup = device.createBindGroup({
    layout: pipeline.getBindGroupLayout(0),
    entries: [
      { binding: 0, resource: { buffer: input } },
      { binding: 1, resource: { buffer: output } }
    ]
  });

  const encoder = device.createCommandEncoder();
  const pass = encoder.beginComputePass();
  pass.setPipeline(pipeline);
  pass.setBindGroup(0, bindGroup);
  pass.dispatchWorkgroups(2);
  pass.end();
  encoder.copyBufferToBuffer(output, 0, readback, 0, 8);
  device.queue.submit([encoder.finish()]);

  await readback.mapAsync(GPUMapMode.READ);
  console.log(Array.from(new Uint32Array(readback.getMappedRange())).join(", "));
  readback.unmap();
}
main().catch(console.error);
预期输出:
36, 100第一组计算 1~8 的和 36,第二组计算 9~16 的和 100。输入缓冲区为 64 字节,输出与回读缓冲区各 8 字节;回读必须在 GPU 复制完成且 mapAsync(GPUMapMode.READ) 成功后进行。
检查同步错误与跨组边界
把第一次 workgroupBarrier() 删除,后续调用可能在其他调用写完之前读取 scratch;即使某次得到正确结果,也不能证明代码安全。若把屏障放进 if (lid < stride),则只有部分调用会执行屏障,违反 WGSL 的一致控制流要求,通常会被着色器验证拒绝。
workgroupBarrier() 只协调同组调用对 workgroup 内存的访问;storageBarrier() 也只能在同一工作组内同步受其作用的存储内存访问。两者都不能等待其他工作组完成,也不能假定第 0 组总在第 1 组之前运行。
如果需要 16 个数的总和 136,可让第一次派发生成 [36, 100],再让第二次派发读取这两个值并相加;在同一 GPU 命令队列按顺序提交依赖的计算工作。单次派发中的跨组累加还可用原子操作处理特定场景,但原子操作本身不提供全局屏障。