
Web 图形与 3D / 系统课时
使用存储纹理批量处理像素
使用存储纹理批量处理像素
本课把逐像素颜色计算放到 GPU:创建一张 500×300 的存储纹理,让二维计算调用分别写入对应像素,再用全屏三角形将计算结果显示到 Canvas。完成后可以直接看到红色随横坐标、绿色随纵坐标变化的渐变图,并学会避免越界写入和通道间读写冲突。
学习目标
- 正确创建同时支持计算写入和渲染采样的
rgba8unorm纹理。 - 把
global_invocation_id.xy映射到二维像素坐标,并处理不足整组的边缘。 - 串联 Compute Pass 与 Render Pass,在浏览器中验证像素输出。
存储纹理的格式与用途
普通采样纹理主要由着色器读取;存储纹理允许计算着色器用 textureStore 按整数坐标写入纹素。这里选择 rgba8unorm,每个通道 8 位,写入的浮点 RGBA 值通常取 0~1,并量化到 8 位精度。写入侧在 WGSL 中声明 texture_storage_2d<rgba8unorm, write>。
创建纹理时同时指定 GPUTextureUsage.STORAGE_BINDING | GPUTextureUsage.TEXTURE_BINDING:前者允许计算管线写入,后者允许显示管线将它当 texture_2d<f32> 采样。不能因为画布通常使用 bgra8unorm,就直接把画布交换链纹理当存储纹理写入;该格式的存储绑定需要可选设备特性,而且画布纹理还涉及自身配置的用途。独立建立一张 rgba8unorm 中间纹理更直接。相关用途与格式限制可查阅 MDN 纹理创建文档。
二维线程怎样连接到显示通道
设纹理宽 500、高 300,每组安排 @workgroup_size(8, 8),就要派发 ceil(500/8)=63 列、ceil(300/8)=38 行工作组,总共 153216 次调用。其中只有 150000 个像素有效,余下 3216 次调用通过边界检查退出。
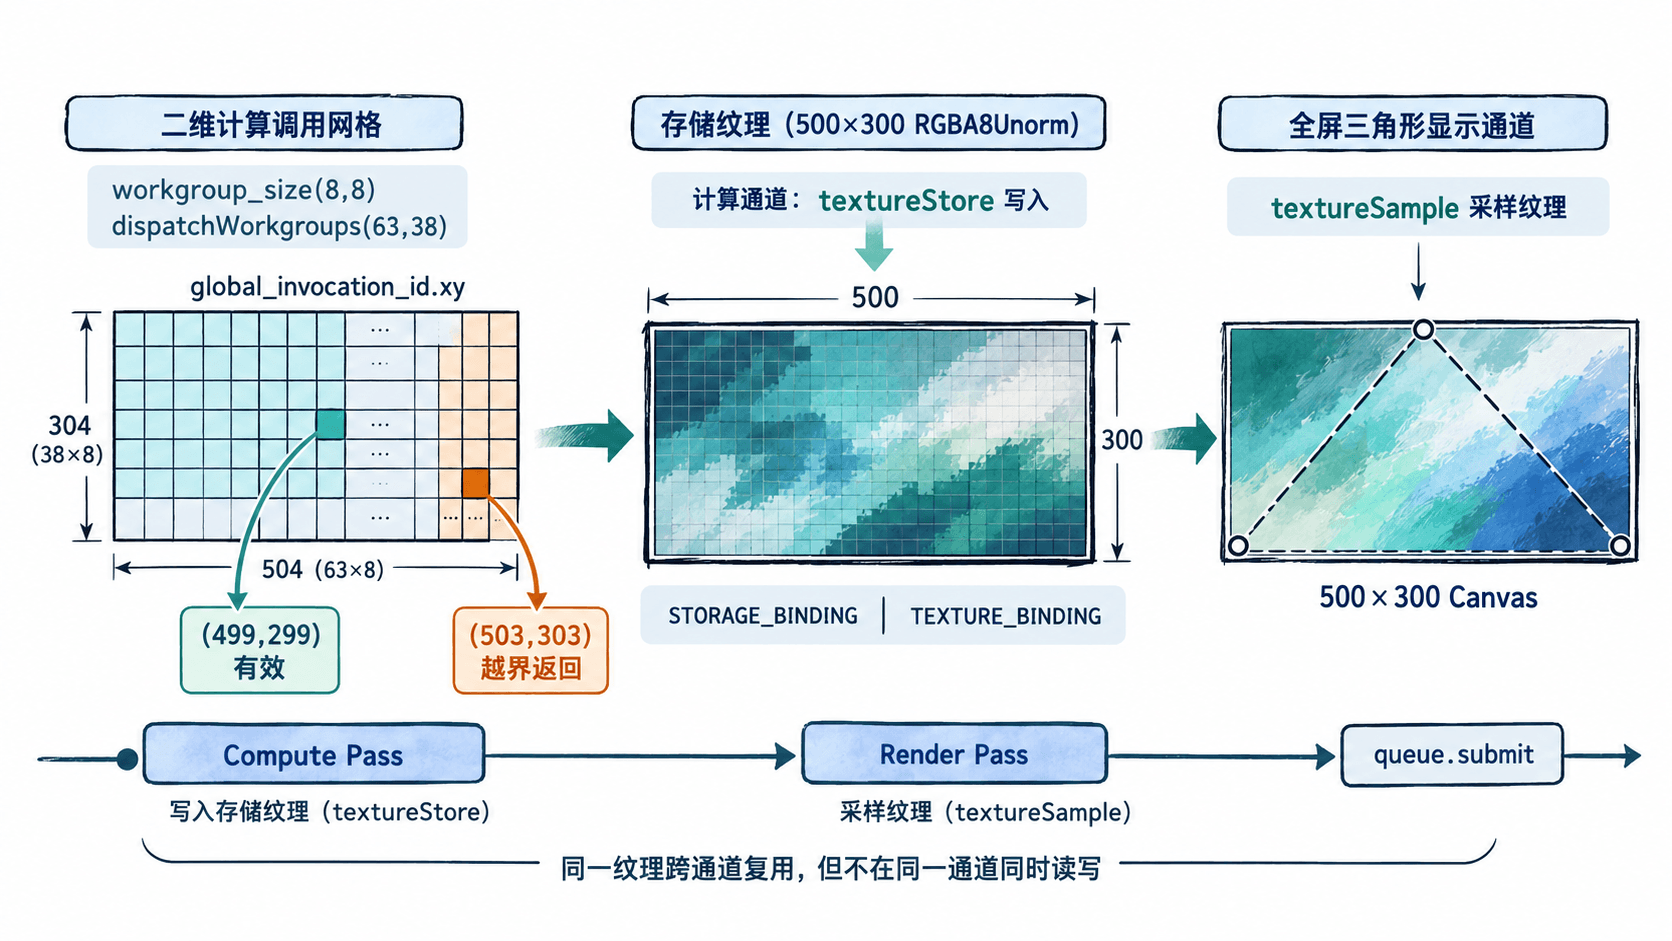
计算通道中,global_invocation_id.xy 是全局像素坐标;只有 x < 500 且 y < 300 才调用 textureStore。显示通道改用采样纹理声明与 textureSample,通过全屏三角形的 UV 坐标取色。两次 Pass 按顺序编码进同一个命令缓冲区,WebGPU 负责跨通道的资源同步,无须把像素读回 CPU。
在浏览器中运行完整示例
在支持 WebGPU 的浏览器中打开 HTTPS 页面或 http://localhost 页面,按 F12 打开开发者工具的 Console,将下列完整 JavaScript 粘贴执行。脚本会创建自己的画布,不需要着色器文件或图片素材。
async function runStorageTextureDemo() {
  if (!navigator.gpu) throw new Error("当前浏览器或上下文不支持 WebGPU");
  const adapter = await navigator.gpu.requestAdapter();
  if (!adapter) throw new Error("未找到可用的 GPU 适配器");
  const device = await adapter.requestDevice();

  const canvas = document.createElement("canvas");
  canvas.width = 500;
  canvas.height = 300;
  document.body.appendChild(canvas);
  const context = canvas.getContext("webgpu");
  const canvasFormat = navigator.gpu.getPreferredCanvasFormat();
  context.configure({ device, format: canvasFormat, alphaMode: "opaque" });

  // 计算通道写入,渲染通道采样;不直接写交换链纹理。
  const texture = device.createTexture({
    size: [canvas.width, canvas.height],
    format: "rgba8unorm",
    usage: GPUTextureUsage.STORAGE_BINDING | GPUTextureUsage.TEXTURE_BINDING,
  });
  const view = texture.createView();

  const computeCode = `
    @group(0) @binding(0) var dst: texture_storage_2d<rgba8unorm, write>;

    @compute @workgroup_size(8, 8)
    fn cs(@builtin(global_invocation_id) gid: vec3u) {
      let dim = textureDimensions(dst);
      // 工作组向上取整,多出的调用不可写到纹理外。
      if (gid.x >= dim.x || gid.y >= dim.y) { return; }
      let r = f32(gid.x) / f32(dim.x - 1u);
      let g = f32(gid.y) / f32(dim.y - 1u);
      textureStore(dst, vec2i(gid.xy), vec4f(r, g, 0.25, 1.0));
    }
  `;
  const renderCode = `
    struct VertexOut {
      @builtin(position) position: vec4f,
      @location(0) uv: vec2f,
    };

    @vertex fn vs(@builtin(vertex_index) i: u32) -> VertexOut {
      let corners = array<vec2f, 3>(
        vec2f(-1.0, -1.0), vec2f(3.0, -1.0), vec2f(-1.0, 3.0)
      );
      let p = corners[i];
      var out: VertexOut;
      out.position = vec4f(p, 0.0, 1.0);
      out.uv = vec2f((p.x + 1.0) * 0.5, (1.0 - p.y) * 0.5);
      return out;
    }

    @group(0) @binding(0) var src: texture_2d<f32>;
    @group(0) @binding(1) var srcSampler: sampler;

    @fragment fn fs(input: VertexOut) -> @location(0) vec4f {
      return textureSample(src, srcSampler, input.uv);
    }
  `;

  const computePipeline = device.createComputePipeline({
    layout: "auto",
    compute: {
      module: device.createShaderModule({ code: computeCode }),
      entryPoint: "cs",
    },
  });
  const renderModule = device.createShaderModule({ code: renderCode });
  const renderPipeline = device.createRenderPipeline({
    layout: "auto",
    vertex: { module: renderModule, entryPoint: "vs" },
    fragment: {
      module: renderModule,
      entryPoint: "fs",
      targets: [{ format: canvasFormat }],
    },
    primitive: { topology: "triangle-list" },
  });

  // 同一视图分别绑定到两个管线的不同资源接口。
  const computeGroup = device.createBindGroup({
    layout: computePipeline.getBindGroupLayout(0),
    entries: [{ binding: 0, resource: view }],
  });
  const renderGroup = device.createBindGroup({
    layout: renderPipeline.getBindGroupLayout(0),
    entries: [
      { binding: 0, resource: view },
      { binding: 1, resource: device.createSampler({
        magFilter: "nearest", minFilter: "nearest",
      }) },
    ],
  });

  const encoder = device.createCommandEncoder();
  const computePass = encoder.beginComputePass();
  computePass.setPipeline(computePipeline);
  computePass.setBindGroup(0, computeGroup);
  // ceil 确保右侧和底部不遗漏像素。
  const groupsX = Math.ceil(canvas.width / 8);
  const groupsY = Math.ceil(canvas.height / 8);
  computePass.dispatchWorkgroups(groupsX, groupsY);
  computePass.end();

  const renderPass = encoder.beginRenderPass({
    colorAttachments: [{
      view: context.getCurrentTexture().createView(),
      loadOp: "clear",
      clearValue: { r: 0, g: 0, b: 0, a: 1 },
      storeOp: "store",
    }],
  });
  renderPass.setPipeline(renderPipeline);
  renderPass.setBindGroup(0, renderGroup);
  renderPass.draw(3);
  renderPass.end();

  device.queue.submit([encoder.finish()]);
  await device.queue.onSubmittedWorkDone();
  console.log(`完成:${canvas.width}×${canvas.height};工作组 ${groupsX}×${groupsY}`);
}
runStorageTextureDemo().catch(console.error);
预期输出:
完成:500×300;工作组 63×38画布应显示连续渐变:左上角偏暗蓝,右上角偏红,左下角偏绿,右下角偏黄绿。纹理在 GPU 内完成写入和采样;onSubmittedWorkDone() 只等待提交完成,不会将纹理内容复制到 JavaScript 内存。
验证边界与排查错误
可以把画布尺寸改为 505×305 后重新执行,日志应自动变成 完成:505×305;工作组 64×39。因为 64×8=512、39×8=312,边界外的调用仍会被跳过,图像右侧和底部不应出现黑边。若出现异常,先检查 groupsX、groupsY 与 textureDimensions 的值是否对应。
- 纹理格式不匹配:
texture_storage_2d<rgba8unorm, write>必须对应实际rgba8unorm纹理,不能把着色器声明改成bgra8unorm却不调整设备特性和创建参数。 - 纹理用途不足:缺少
STORAGE_BINDING会导致计算绑定失败;缺少TEXTURE_BINDING会导致渲染采样绑定失败。 - 结果空白或边缘异常:检查工作组数量是否向上取整、是否先结束 Compute Pass 再开始 Render Pass,以及输出像素坐标是否受
textureDimensions限制。 - 无法请求设备:确认页面是安全上下文、浏览器和图形后端支持 WebGPU,并查看 Console 中的验证错误。
实际做模糊、阈值分割或颜色反转时,可以再增加一张只读输入纹理:计算着色器用 textureLoad 读取输入、处理后写入本课的输出存储纹理,显示通道仍直接采样输出纹理。