
Web 图形与 3D / 系统课时
复用管线布局管理多个绑定组
复用管线布局管理多个绑定组
当同一份参数和数据需要被多条 WebGPU 管线使用时,分别创建自动布局可能导致绑定组无法复用。本篇将 Uniform 参数与可写 Storage 数据分成两个绑定组,通过显式 PipelineLayout 组织它们,并验证两条计算管线能安全共享资源。
学习目标
- 理解 BindGroupLayout、PipelineLayout 与 WGSL 绑定声明之间的对应关系。
- 显式创建可复用的管线布局,让两条计算管线共享绑定组。
- 通过实际计算结果和验证规则排查布局不匹配。
理解绑定组与管线布局的关系
WebGPU 使用三个层次管理着色器资源:
- BindGroupLayout:声明一个绑定组内有哪些资源,以及每个资源的绑定编号、类型和可见阶段。
- BindGroup:按照某个 BindGroupLayout 提供实际 GPUBuffer、纹理或采样器。
- PipelineLayout:将多个 BindGroupLayout 按组号排列,确定整条图形或计算管线需要的资源接口。
createPipelineLayout() 的 bindGroupLayouts 数组是有顺序的。第 0 项对应 WGSL 的 @group(0),第 1 项对应 @group(1),依此类推;每组内部再通过 @binding(n) 找到资源。
例如,一个计算任务可以将资源组织为:
| WGSL 声明 | 资源 | 布局类型 | 用途 |
|---|---|---|---|
@group(0) @binding(0) |
16 字节 Uniform Buffer | uniform |
保存计算步长 2 |
@group(1) @binding(0) |
16 字节 Storage Buffer | storage |
保存 4 个可写 u32 |
两个资源都使用 binding(0) 不会冲突,因为它们属于不同的绑定组。Uniform 在着色器中只读,Storage 则声明为 read_write,因此布局必须允许对应的访问方式。
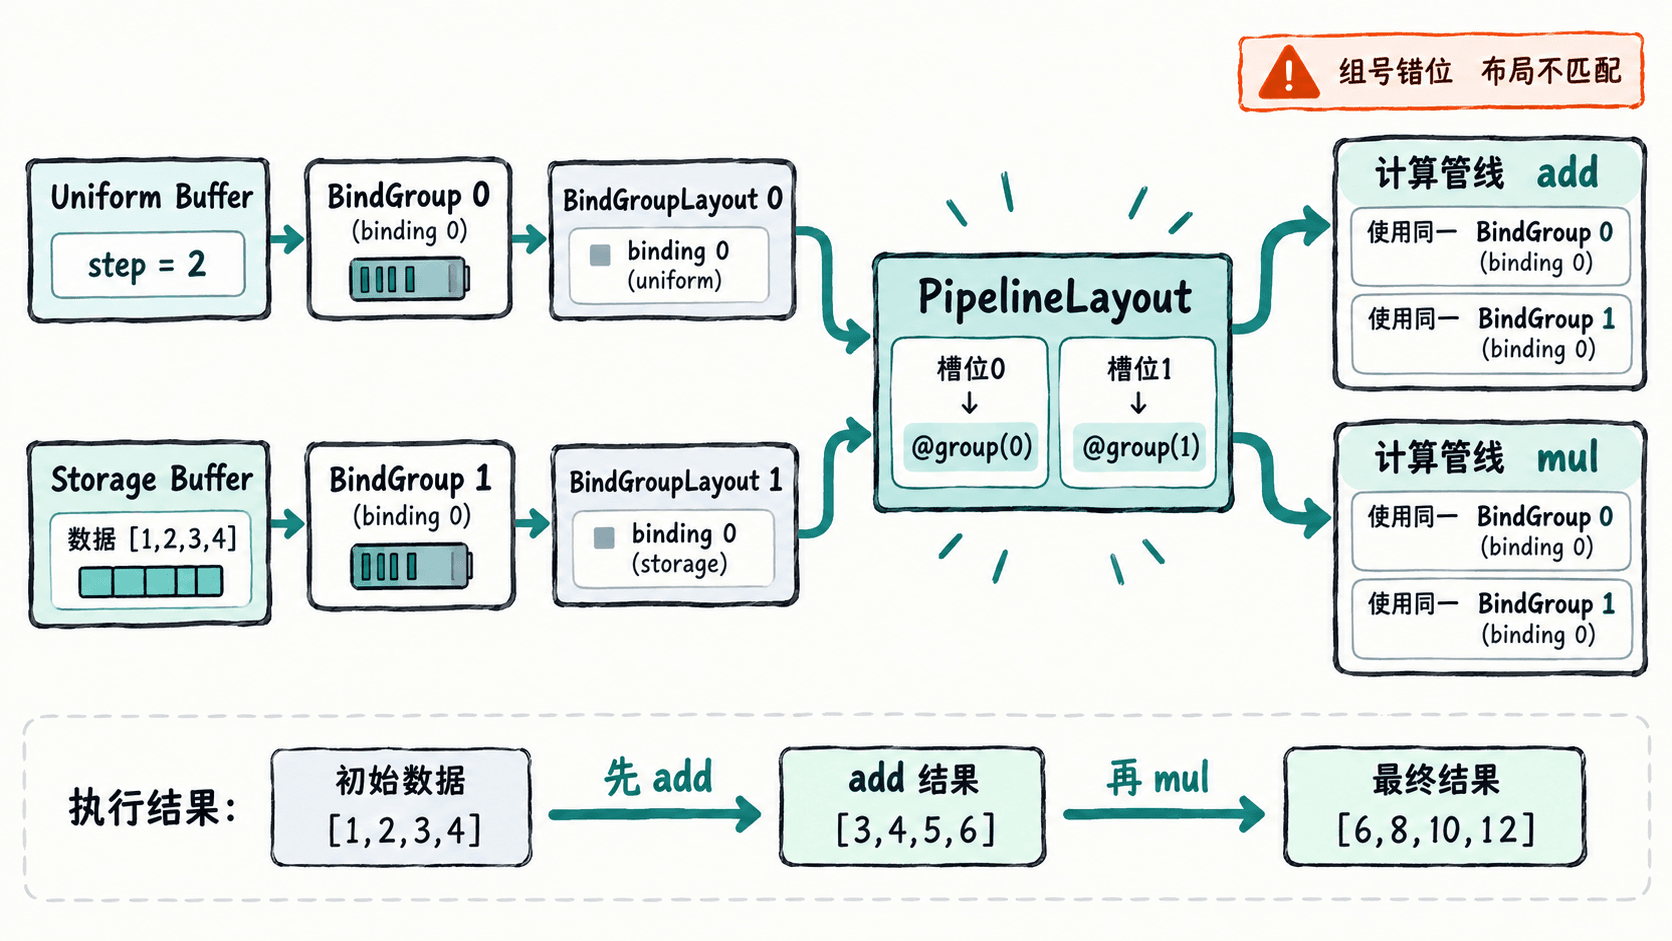
显式创建布局并运行两条管线
下面通过一个完整的 WebGPU 计算示例验证共享布局。输入数组为 [1, 2, 3, 4],Uniform 参数 step 为 2。第一条计算管线把每个数字加 2,第二条管线再把结果乘 2。
运行环境需要支持 WebGPU,并处于 HTTPS 或 localhost 等安全上下文。打开浏览器开发者工具的 Console,执行以下完整 JavaScript。代码不依赖第三方库,也不需要 Canvas。
async function main() {
  if (!navigator.gpu) throw new Error("当前环境不支持 WebGPU");
  const adapter = await navigator.gpu.requestAdapter();
  if (!adapter) throw new Error("未找到可用 GPU 适配器");
  const device = await adapter.requestDevice();

  const shader = device.createShaderModule({
    code: `
      struct Params { step: u32, };
      @group(0) @binding(0) var<uniform> params: Params;
      @group(1) @binding(0) var<storage, read_write> values: array<u32>;

      @compute @workgroup_size(4)
      fn add(@builtin(global_invocation_id) id: vec3<u32>) {
        if (id.x >= arrayLength(&values)) { return; }
        values[id.x] += params.step;
      }

      @compute @workgroup_size(4)
      fn mul(@builtin(global_invocation_id) id: vec3<u32>) {
        if (id.x >= arrayLength(&values)) { return; }
        values[id.x] *= params.step;
      }
    `
  });

  // 每个布局描述一个组,数组顺序必须对应 WGSL 的组号。
  const paramsLayout = device.createBindGroupLayout({
    entries: [{
      binding: 0,
      visibility: GPUShaderStage.COMPUTE,
      buffer: { type: "uniform" }
    }]
  });
  const dataLayout = device.createBindGroupLayout({
    entries: [{
      binding: 0,
      visibility: GPUShaderStage.COMPUTE,
      buffer: { type: "storage" }
    }]
  });
  const layout = device.createPipelineLayout({
    bindGroupLayouts: [paramsLayout, dataLayout]
  });

  // 两条管线复用完全相同的显式 PipelineLayout。
  const addPipeline = device.createComputePipeline({
    layout,
    compute: { module: shader, entryPoint: "add" }
  });
  const mulPipeline = device.createComputePipeline({
    layout,
    compute: { module: shader, entryPoint: "mul" }
  });

  const paramsBuffer = device.createBuffer({
    size: 16,
    usage: GPUBufferUsage.UNIFORM | GPUBufferUsage.COPY_DST
  });
  device.queue.writeBuffer(
    paramsBuffer, 0, new Uint32Array([2, 0, 0, 0])
  );

  const input = new Uint32Array([1, 2, 3, 4]);
  const dataBuffer = device.createBuffer({
    size: input.byteLength,
    usage: GPUBufferUsage.STORAGE |
           GPUBufferUsage.COPY_DST |
           GPUBufferUsage.COPY_SRC
  });
  device.queue.writeBuffer(dataBuffer, 0, input);

  const readback = device.createBuffer({
    size: input.byteLength,
    usage: GPUBufferUsage.COPY_DST | GPUBufferUsage.MAP_READ
  });

  const paramsGroup = device.createBindGroup({
    layout: paramsLayout,
    entries: [{ binding: 0, resource: { buffer: paramsBuffer } }]
  });
  const dataGroup = device.createBindGroup({
    layout: dataLayout,
    entries: [{ binding: 0, resource: { buffer: dataBuffer } }]
  });

  const encoder = device.createCommandEncoder();

  // 连续计算使用两个通道,使第二次计算读取第一次的结果。
  for (const pipeline of [addPipeline, mulPipeline]) {
    const pass = encoder.beginComputePass();
    pass.setPipeline(pipeline);
    pass.setBindGroup(0, paramsGroup);
    pass.setBindGroup(1, dataGroup);
    pass.dispatchWorkgroups(1);
    pass.end();
  }

  encoder.copyBufferToBuffer(
    dataBuffer, 0, readback, 0, input.byteLength
  );
  device.queue.submit([encoder.finish()]);

  await readback.mapAsync(GPUMapMode.READ);
  const result = Array.from(
    new Uint32Array(readback.getMappedRange())
  );
  console.log("结果:", result.join(", "));
  readback.unmap();

  paramsBuffer.destroy();
  dataBuffer.destroy();
  readback.destroy();
}

main().catch(console.error);
预期输出:
结果: 6, 8, 10, 12第一条管线将 [1,2,3,4] 变为 [3,4,5,6],第二条管线再乘以 2,得到最终结果。@workgroup_size(4) 配合 dispatchWorkgroups(1) 启动 4 个着色器调用,每个调用处理一个数组元素。
这里有三个关键细节:
- 两条管线共享
layout:通过同一个GPUPipelineLayout对象保证组 0 和组 1 的资源接口一致。 - 绑定组只创建一次:
paramsGroup和dataGroup在两个计算通道内重复使用,不需要为每条管线重新创建。 - 数据在 GPU 内连续处理:两次 Dispatch 分别放在顺序执行的 Compute Pass 中,最后才复制到回读缓冲区,避免每一步都等待 CPU 回读。
判断绑定组是否兼容
显式布局能够复用,并不意味着任意两个绑定组都能互换。WebGPU 在管线创建与命令编码阶段检查资源布局和着色器声明。判断兼容性时,需要同时关注组号、绑定编号、资源类型、可见阶段、缓冲区的最小绑定大小及动态偏移等布局属性。
下面是三个容易出现的错误:
| 错误做法 | 可能结果 | 正确处理 |
|---|---|---|
将布局数组写成 [dataLayout, paramsLayout] |
组 0 期望 Uniform,却被声明为 Storage | 按 WGSL 的 @group 编号排列 |
将可写 Storage 的类型设为 read-only-storage |
与 WGSL 的 read_write 声明不兼容 |
使用 buffer.type: "storage" |
两条管线分别使用 layout: "auto",并共享第一条管线的绑定组 |
自动布局生成的绑定组不能跨管线复用 | 手动创建布局并用于两条管线 |
尤其需要注意 layout: "auto" 的行为:它会根据着色器自动生成布局,适合快速验证单条管线,但由自动布局产生的 BindGroupLayout 与其所属管线关联。即使另一条管线恰好具有相同的 @group 和 @binding 声明,也不能直接共享这种自动布局下创建的绑定组。
如果工程中的资源接口由多个着色器共同使用,应将布局声明集中管理,而不是从各条自动布局管线调用 getBindGroupLayout() 后混用。显式创建的布局也允许由不同对象提供等价定义,但直接复用同一组布局对象更容易审核和维护。
验证资源与管线匹配
如果运行时出现 GPUValidationError,建议按资源声明到命令提交的顺序检查,而不是只修改最终的 setBindGroup() 调用。
- 检查组号:确认
bindGroupLayouts[0]对应@group(0),bindGroupLayouts[1]对应@group(1),并分别调用setBindGroup(0, paramsGroup)与setBindGroup(1, dataGroup)。 - 检查访问类型:本例的 Uniform 对应
buffer.type: "uniform",可写 Storage 对应buffer.type: "storage",可见阶段均包括GPUShaderStage.COMPUTE。 - 检查缓冲区用途与大小:Uniform 创建时必须具有
GPUBufferUsage.UNIFORM,Storage 必须具有GPUBufferUsage.STORAGE。本例各分配 16 字节;四个u32恰好占用 16 字节。 - 检查读取路径:Storage 缓冲区带有
COPY_SRC,回读缓冲区带有COPY_DST | MAP_READ,提交命令后通过mapAsync(GPUMapMode.READ)读取最终数据。 - 检查计算结果:连续计算的预期是
6, 8, 10, 12;如果只有3, 4, 5, 6,应确认第二条管线确实调用了dispatchWorkgroups(1),且使用的是同一个数据绑定组。
在实际粒子模拟项目中,可以把组 0 设计为全局仿真参数,如时间步长、重力和粒子数量,把组 1 设计为粒子位置与速度缓冲区。初始化、更新和其他需要相同资源接口的计算管线便可共享显式布局及绑定组,避免重复创建资源接口并减少切换管线时的绑定错误。