
Web 图形与 3D / 系统课时
使用时间戳查询分析 GPU 耗时
使用时间戳查询分析 GPU 耗时
当 WebGPU 粒子模拟出现掉帧时,单看 JavaScript 的执行时间往往无法判断 GPU 是否繁忙。本篇用可选的 timestamp-query 记录计算 Pass 的起止时间,将 GPU 毫秒数与 CPU 编码、提交和等待时间分开,得到可以复测的性能数据。
学习目标
- 检测并启用
timestamp-query,在不支持时正常回退。 - 为计算 Pass 写入两个时间戳,解析查询结果为毫秒。
- 对照 GPU 与 CPU 指标,找出需要优先优化的阶段。
确认设备支持时间戳查询
在 HTTPS 或 http://localhost 页面打开浏览器开发者工具的 Console。先检查 navigator.gpu 和 navigator.gpu.requestAdapter(),再读取 adapter.features.has("timestamp-query")。这是可选特性:只有适配器支持时,才能在 requestDevice({ requiredFeatures: ["timestamp-query"] }) 中启用;否则应继续执行普通 GPU 计算,只记录 CPU 侧指标。
performance.now() 测量的是浏览器线程经过的时间。queue.submit() 通常只提交命令,不等待 GPU 执行结束,因此仅围绕 submit() 计时不能当作着色器运行时间。以下示例使用 queue.onSubmittedWorkDone() 作为另一个 CPU 侧观察点,但它也包含队列与异步调度的影响。
认识查询、解析与读回链路
每个被测 Pass 需要两个查询索引:0 写入开始时间,1 写入结束时间。查询结果解析为两个 64 位无符号纳秒时间戳,合计 16 字节。结束 Pass 后必须先用 resolveQuerySet() 写入具有 QUERY_RESOLVE | COPY_SRC 用途的缓冲,再复制到 COPY_DST | MAP_READ 缓冲,最后才能 mapAsync(GPUMapMode.READ)。
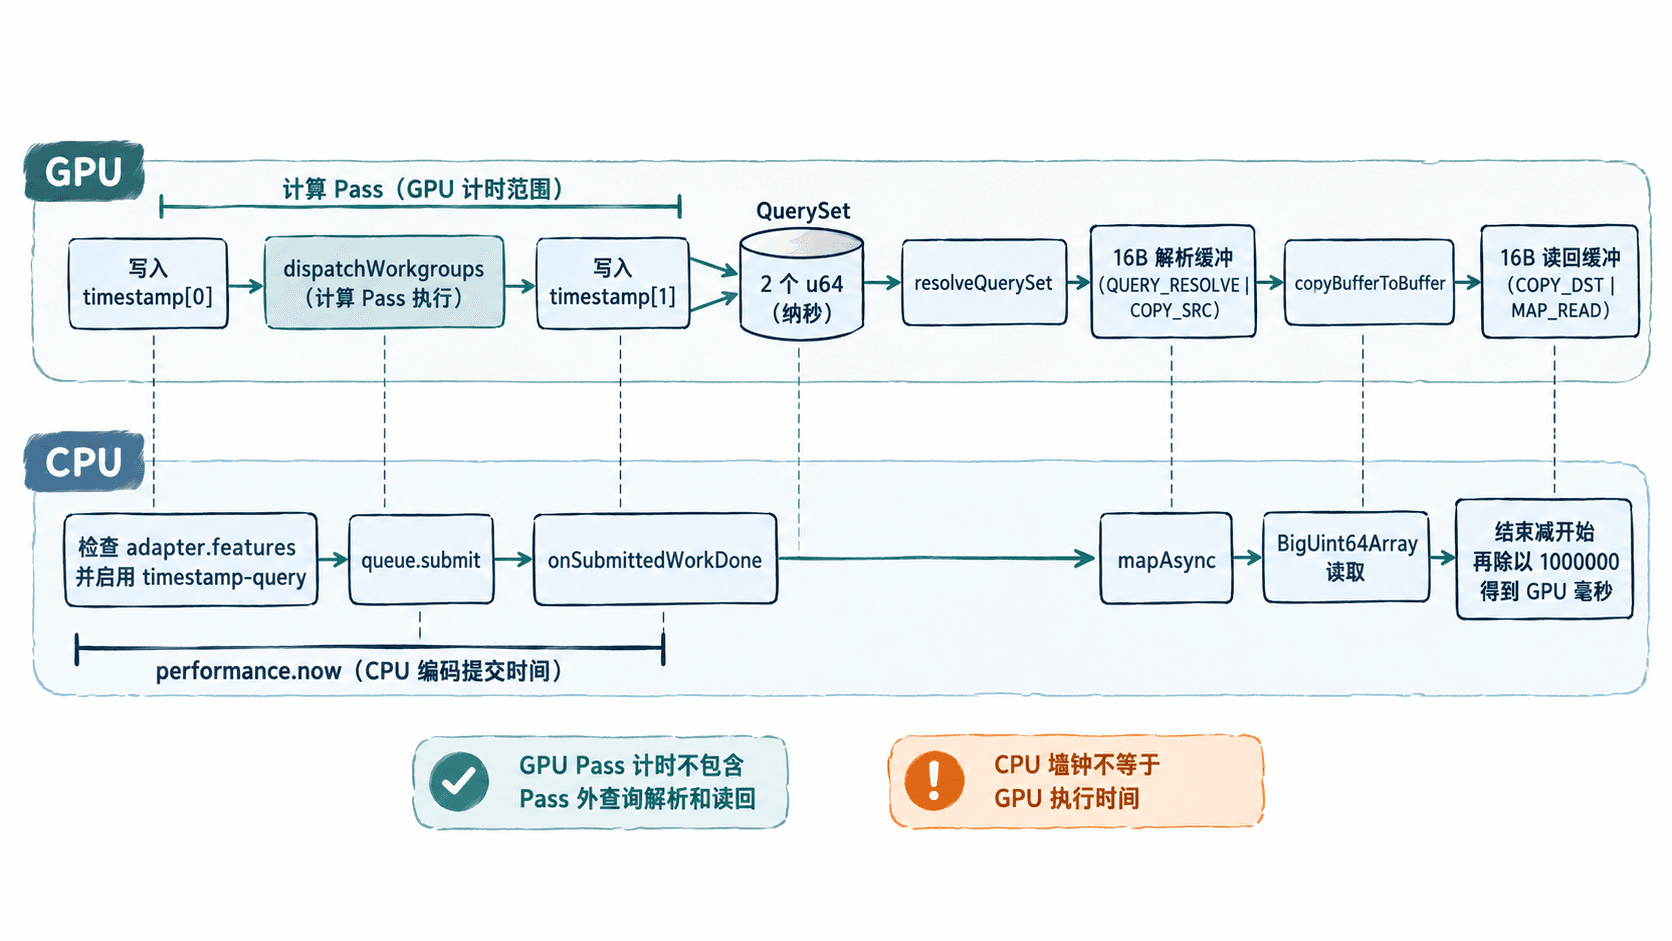
resolveQuerySet() 的目标偏移必须是 256 字节的整数倍,本例采用偏移 0;两个查询各占 8 字节,因此解析、复制和读回长度都是 16。读出后先对 BigInt 时间戳做差,再用 Number(end - start) / 1e6 换算毫秒,避免先把大整数时间戳转换为浮点数而丢失精度。
运行一次完整的计算 Pass 测量
在支持 WebGPU 的安全上下文页面 Console 中运行以下 JavaScript。示例创建 65,536 个元素,启动 1,024 个、每组 64 个调用的计算工作组。timestampWrites 只围住计算 Pass;查询解析、缓冲复制都放在 Pass 之后。代码还读回一个计算值,验证 GPU 确实写入了数据。
(async () => {
  if (!navigator.gpu) {
    console.warn("当前页面不支持 WebGPU");
    return;
  }
  const adapter = await navigator.gpu.requestAdapter();
  if (!adapter) {
    console.warn("没有可用的 GPU 适配器");
    return;
  }

  const hasTimestamp = adapter.features.has("timestamp-query");
  const device = await adapter.requestDevice({
    requiredFeatures: hasTimestamp ? ["timestamp-query"] : [],
  });

  const count = 65536;
  const module = device.createShaderModule({
    code: `
      @group(0) @binding(0) var<storage, read_write> values: array<f32>;

      @compute @workgroup_size(64)
      fn main(@builtin(global_invocation_id) id: vec3<u32>) {
        if (id.x >= 65536u) { return; }
        var x = f32(id.x) / 65536.0;
        for (var i = 0u; i < 256u; i = i + 1u) {
          x = x * 1.00001 + 0.0001;
        }
        values[id.x] = x;
      }
    `,
  });
  const pipeline = device.createComputePipeline({
    layout: "auto",
    compute: { module, entryPoint: "main" },
  });
  const data = device.createBuffer({
    size: count * 4,
    usage: GPUBufferUsage.STORAGE | GPUBufferUsage.COPY_SRC,
  });
  const sampleRead = device.createBuffer({
    size: 4,
    usage: GPUBufferUsage.COPY_DST | GPUBufferUsage.MAP_READ,
  });
  const bindGroup = device.createBindGroup({
    layout: pipeline.getBindGroupLayout(0),
    entries: [{ binding: 0, resource: { buffer: data } }],
  });

  // 时间戳是可选路径;不支持时仍派发相同的计算任务。
  const querySet = hasTimestamp
    ? device.createQuerySet({ type: "timestamp", count: 2 })
    : null;
  const resolveBuffer = hasTimestamp
    ? device.createBuffer({
        size: 16,
        usage: GPUBufferUsage.QUERY_RESOLVE | GPUBufferUsage.COPY_SRC,
      })
    : null;
  const timestampRead = hasTimestamp
    ? device.createBuffer({
        size: 16,
        usage: GPUBufferUsage.COPY_DST | GPUBufferUsage.MAP_READ,
      })
    : null;

  const cpuStart = performance.now();
  const encoder = device.createCommandEncoder();
  // Pass 边界的两个 GPU 时间戳,不计入后续的读回复制。
  const pass = encoder.beginComputePass(
    hasTimestamp
      ? { timestampWrites: {
          querySet,
          beginningOfPassWriteIndex: 0,
          endOfPassWriteIndex: 1,
        } }
      : {}
  );
  pass.setPipeline(pipeline);
  pass.setBindGroup(0, bindGroup);
  pass.dispatchWorkgroups(count / 64);
  pass.end();

  if (hasTimestamp) {
    encoder.resolveQuerySet(querySet, 0, 2, resolveBuffer, 0);
    encoder.copyBufferToBuffer(resolveBuffer, 0, timestampRead, 0, 16);
  }
  encoder.copyBufferToBuffer(data, 0, sampleRead, 0, 4);
  device.queue.submit([encoder.finish()]);
  const cpuSubmitted = performance.now();
  await device.queue.onSubmittedWorkDone();
  const cpuDone = performance.now();

  console.log("timestamp-query:", hasTimestamp ? "支持" : "不支持(仅 CPU)");
  console.log(`CPU 编码与提交: ${(cpuSubmitted - cpuStart).toFixed(3)} ms`);
  console.log(`CPU 提交至队列完成: ${(cpuDone - cpuSubmitted).toFixed(3)} ms`);

  if (hasTimestamp) {
    await timestampRead.mapAsync(GPUMapMode.READ);
    const stamps = new BigUint64Array(timestampRead.getMappedRange());
    // 先用 BigInt 做差,再换算为浮点毫秒数。
    const elapsedNs = stamps[1] - stamps[0];
    console.log(elapsedNs > 0n
      ? `GPU 计算 Pass: ${(Number(elapsedNs) / 1e6).toFixed(3)} ms`
      : "GPU 时间戳差值为 0,请重测");
    timestampRead.unmap();
  }

  await sampleRead.mapAsync(GPUMapMode.READ);
  const sample = new Float32Array(sampleRead.getMappedRange())[0];
  console.log("计算结果校验:",
    Number.isFinite(sample) && sample > 0 ? "通过" : "失败");
  sampleRead.unmap();

  querySet?.destroy();
  resolveBuffer?.destroy();
  timestampRead?.destroy();
  sampleRead.destroy();
  data.destroy();
  device.destroy();
})().catch(console.error);预期输出(时间是动态值,<TIME> 会随设备、浏览器和负载改变):
timestamp-query: 支持
CPU 编码与提交: <TIME> ms
CPU 提交至队列完成: <TIME> ms
GPU 计算 Pass: <TIME> ms
计算结果校验: 通过
未获得 timestamp-query 特性时,首行显示 不支持(仅 CPU),并且不会输出 GPU 计算 Pass。若 GPU 时间戳差值为 0,程序改为提示重测,不把 0 ms 当作真实执行成本。
对照指标判断瓶颈
| 指标 | 包含的工作 | 不应如何解读 |
|---|---|---|
| CPU 编码与提交 | JavaScript 编码命令并调用 submit() |
不是 GPU 着色器耗时 |
| CPU 提交至队列完成 | 提交后等待队列已提交工作完成,包含本例的复制命令与异步调度 | 不是纯 GPU 计算耗时 |
| GPU 计算 Pass | timestampWrites 两个边界之间的 GPU 时间 |
不包含 Pass 外查询解析、复制或 CPU 读回 |
例如,一次测得 CPU 编码提交 0.8 ms、CPU 提交至完成 10.2 ms、GPU 计算 Pass 7.5 ms,说明这次采样的计算 Pass 值得优先分析。若 GPU Pass 只有 0.5 ms,而 CPU 编码耗时 8 ms,应先检查 CPU 循环、频繁创建管线和命令组织。三种指标存在重叠或额外开销,不能简单相加当作整帧时间。
复测与排除误判
先用相同分辨率、派发数量和工作负载预热约 20 次,再采集 50 次,查看中位数及高位耗时;比较优化前后时保持浏览器、显卡、电源模式一致。对于 60 Hz 画面,整帧目标约 16.67 ms,但单个计算 Pass 的 GPU 时间不能代表整帧 CPU、渲染和呈现成本。
若出现校验错误,按顺序检查:设备是否请求了 timestamp-query;querySet 类型是否为 timestamp 且索引 0、1 有效;解析缓冲是否具备 QUERY_RESOLVE、起始偏移是否按 256 字节对齐;读回缓冲是否具备 MAP_READ | COPY_DST;mapAsync() 是否在提交后执行。生产环境可延迟数帧回收读回缓冲,避免每帧同步等待查询结果;仅在需要性能采样时启用 GPU 查询。