
Web 图形与 3D / 系统课时
让计算着色器更新粒子速度
让计算着色器更新粒子速度
把每个粒子的二维位置和速度写入 GPU 存储缓冲区,由 WGSL 计算着色器按固定时间步更新状态。本课会运行 60 个计算步、读回并核对数值,同时保留把同一缓冲区交给渲染通道读取的接口。
学习目标
- 使用加速度先更新速度,再用新速度更新位置。
- 按 WGSL 对齐规则组织粒子数据,避免计算调用越界。
- 运行固定时间步模拟,验证结果并衔接后续实时渲染。
用固定时间步更新速度和位置
以二维粒子为例,每个粒子保存位置 、速度 ,加速度设为 ,单位分别为米、米/秒和米/秒平方。采用半隐式欧拉法,每步按下面的顺序计算:
,随后 。
取 秒。假设初始位置为 、速度为 ,第一步得到竖直速度约 米/秒,竖直位置约 米。先更新位置再更新速度会得到不同轨迹,不能随意交换两行代码。
这里固定的是模拟时间步,不是显示器帧率。即使画面某帧间隔变长,也应通过多个固定子步追赶,而不是把突然增大的帧间隔直接塞进积分公式。
把粒子状态放进一块缓冲区
WGSL 中的 Particle 由两个 vec2f 组成,各占 8 字节,单粒子步长为 16 字节。JavaScript 端按 position.x, position.y, velocity.x, velocity.y 连续写入;两个粒子共用 32 字节。
| 字节偏移 | 字段 | 类型 |
|---|---|---|
| 0 | position |
vec2f |
| 8 | velocity |
vec2f |
| 16 | 下一个粒子的 position |
vec2f |
缓冲区同时声明 STORAGE、VERTEX、COPY_DST、COPY_SRC:计算着色器原地改写状态,后续渲染通道可把它当顶点缓冲区读取,初始化和调试读回则走复制路径。不要直接映射这块存储缓冲区;读回时应复制到具有 MAP_READ 用途的暂存缓冲区。
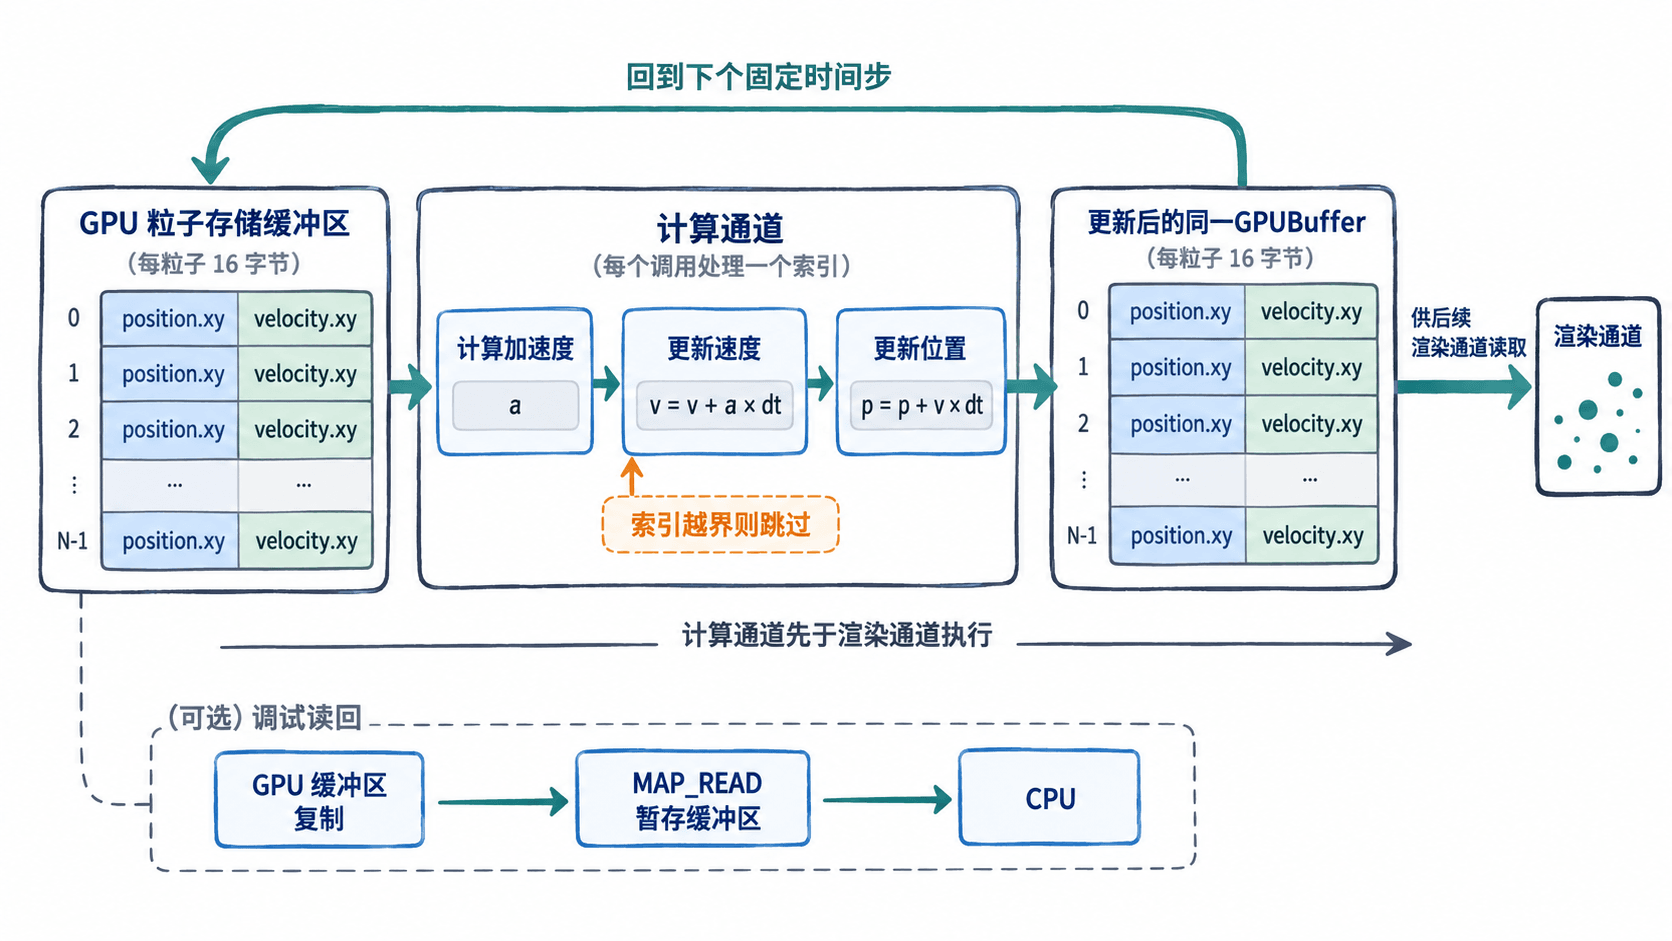
运行可验证的 WGSL 计算示例
在支持 WebGPU 的浏览器中,打开 HTTPS 或 localhost 页面,把下面完整 JavaScript 粘贴到开发者工具控制台执行。示例无需第三方库,先创建两个粒子,再在同一命令编码器里顺序执行 60 次计算通道,最后统一读回。
(async () => {
  if (!navigator.gpu) throw new Error("当前页面不支持 WebGPU");
  const adapter = await navigator.gpu.requestAdapter();
  if (!adapter) throw new Error("未获得 GPU 适配器");
  const device = await adapter.requestDevice();

  // 每个粒子依次存放位置 xy、速度 xy,步长 16 字节
  const initial = new Float32Array([
    0, 1, 1, 0,
    -0.5, 2, 0, 0,
  ]);
  const count = initial.length / 4;
  const buffer = device.createBuffer({
    size: initial.byteLength,
    usage: GPUBufferUsage.STORAGE | GPUBufferUsage.VERTEX |
           GPUBufferUsage.COPY_SRC | GPUBufferUsage.COPY_DST,
  });
  device.queue.writeBuffer(buffer, 0, initial);

  const shader = device.createShaderModule({
    code: `
struct Particle {
  position: vec2f,
  velocity: vec2f,
};
@group(0) @binding(0) var<storage, read_write> particles: array<Particle>;

@compute @workgroup_size(64)
fn update(@builtin(global_invocation_id) gid: vec3u) {
  let i = gid.x;
  if (i >= arrayLength(&particles)) { return; }

  var particle = particles[i];
  let dt = 1.0 / 60.0;
  let acceleration = vec2f(0.0, -9.8);
  particle.velocity += acceleration * dt;
  particle.position += particle.velocity * dt;
  particles[i] = particle;
}
`,
  });
  const pipeline = device.createComputePipeline({
    layout: "auto",
    compute: { module: shader, entryPoint: "update" },
  });
  const bindGroup = device.createBindGroup({
    layout: pipeline.getBindGroupLayout(0),
    entries: [{ binding: 0, resource: { buffer } }],
  });

  const readback = device.createBuffer({
    size: initial.byteLength,
    usage: GPUBufferUsage.COPY_DST | GPUBufferUsage.MAP_READ,
  });
  const encoder = device.createCommandEncoder();

  // 每个计算通道都基于上一步写回的粒子状态继续积分
  for (let step = 0; step < 60; step++) {
    const pass = encoder.beginComputePass();
    pass.setPipeline(pipeline);
    pass.setBindGroup(0, bindGroup);
    pass.dispatchWorkgroups(Math.ceil(count / 64));
    pass.end();
  }
  encoder.copyBufferToBuffer(buffer, 0, readback, 0, initial.byteLength);
  device.queue.submit([encoder.finish()]);

  await readback.mapAsync(GPUMapMode.READ);
  const result = new Float32Array(readback.getMappedRange().slice(0));
  readback.unmap();
  for (let i = 0; i < count; i++) {
    const p = result.subarray(i * 4, i * 4 + 4);
    console.log(
      `粒子 ${i}: 位置=(${p[0].toFixed(3)}, ${p[1].toFixed(3)}), ` +
      `速度=(${p[2].toFixed(3)}, ${p[3].toFixed(3)})`
    );
  }
  readback.destroy();
  buffer.destroy();
})();
预期输出(保留三位小数):
粒子 0: 位置=(1.000, -3.982), 速度=(1.000, -9.800)
粒子 1: 位置=(-0.500, -2.982), 速度=(0.000, -9.800)
@workgroup_size(64) 让一次工作组容纳 64 个调用,本例只处理 2 个粒子,其余调用通过 arrayLength(&particles) 判断后返回,避免越界。每个有效调用只写自己的数组元素,因此不需要工作组屏障。
用数值和步长检查积分
粒子 0 经过 60 步,模拟时长恰好是 1 秒。其水平速度始终为 1,故水平位置约为 1;竖直速度每步减去 ,最终约为 。半隐式欧拉法的竖直位置为 ,与读回的 -3.982 一致。
还可以把 WGSL 的 dt 改为 1.0 / 120.0,同时把 JavaScript 中循环次数改成 120,保持模拟总时长为 1 秒。粒子 0 的竖直位置应约为 -3.941,更接近匀加速运动的解析结果 -3.900。这说明缩小时间步可以降低本例的离散化误差,但固定步长并不保证所有复杂物理系统都稳定。
如果输出全为初始值,先检查 dispatchWorkgroups 是否执行、存储绑定是否为 read_write;如果出现 GPU 校验错误,再核对缓冲区用法、绑定索引以及 16 字节的数据步长。
接入逐帧渲染而不破坏时间步
真正的动画循环应把 requestAnimationFrame 提供的毫秒时间戳转换为秒,并把每帧经过的时间累计到 accumulator。例如固定步长 1/60 秒:60 FPS 附近通常每帧计算 1 步,30 FPS 附近通常计算 2 步。为避免切换标签页后一次追赶太多,可把单帧增量限制到 0.05 秒,并为每帧设置最多 4 个计算子步;若持续积压,应限制或丢弃多余累计时间,接受模拟时间暂时落后。
每帧先编码所有计算通道,再编码渲染通道;同一个 GPUBuffer 可在前者作为存储缓冲区写入,在后者作为顶点缓冲区读取。顶点布局设置 arrayStride: 16,位置属性采用 shaderLocation: 0、offset: 0、format: "float32x2",并在顶点着色器中把模拟坐标变换到裁剪空间。调试读回只用于核对,不应每帧都用 mapAsync 阻塞动画流程。