
计算机网络 / 系统课时
10.11 可观测性:监控、日志与链路追踪
可观测性:监控、日志与链路追踪
🎯 学习目标:理解可观测三支柱,掌握用 TraceId 在全链路定位问题。
为什么需要可观测
前面十课搭起了一条长链路:DNS→CDN→WAF→LB→网关→应用→缓存/MQ/DB。链路这么长,出了问题怎么知道卡在哪一跳? 这就是可观测性要解决的——让系统内部状态"可被观测"。它有三大支柱。
三支柱
| 支柱 | 回答的问题 | 工具 |
|---|---|---|
| 监控(Metrics) | 系统现在健康吗? | Prometheus + Grafana |
| 日志(Logging) | 具体发生了什么? | ELK / Loki |
| 链路追踪(Tracing) | 请求经过了哪些服务、各耗时多少? | SkyWalking / Jaeger |
监控:先知道"有没有问题"
采集各层的关键指标(QPS、响应时间、错误率、CPU/内存、连接数、缓存命中率……),配大盘和告警。核心作用是主动发现——在用户投诉前,监控告警先告诉你"错误率飙升了""数据库连接池满了"。呼应第七章:5xx 突增、502/504 告警,第一时间感知。
日志:定位"具体发生了什么"
监控告诉你"有问题",日志告诉你"问题细节"。分布式系统的日志要集中收集(各机器的日志汇总到 ELK),否则几十台机器一台台翻日志不现实。关键是日志要能按请求串起来——这就要靠 TraceId。
链路追踪:全链路定位的杀手锏
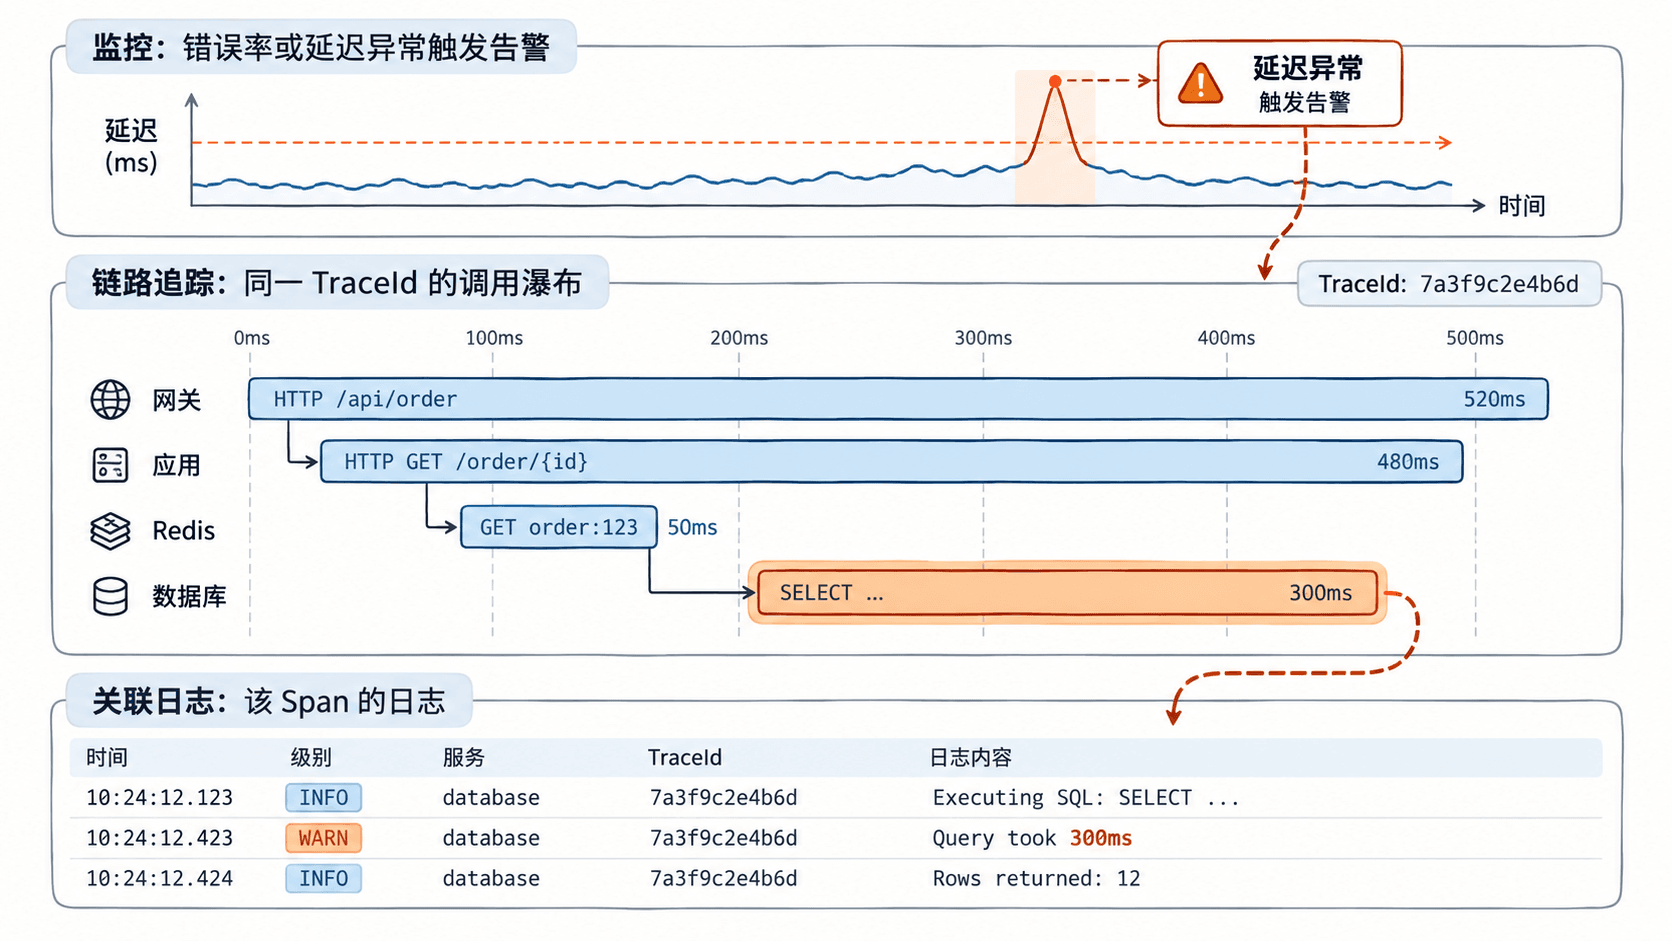
一个请求跨越网关、多个微服务、缓存、数据库,怎么知道慢在哪个环节?链路追踪给每个请求分配一个全局唯一的 TraceId,贯穿它经过的所有服务:
text
请求进入网关 → 生成 TraceId=abc123
  ↓ 传给订单服务(带上 abc123)
  ↓ 订单服务调用用户服务(带上 abc123)
  ↓ 查数据库(带上 abc123)
每一跳都记录 TraceId + 耗时 → 拼成一条完整调用链
于是你能看到:这个请求总耗时 800ms,其中网关 5ms、订单服务 20ms、调用用户服务 700ms(慢在这!)、数据库 75ms。一眼定位瓶颈。
TraceId 通常在入口(网关/Nginx)生成,通过 HTTP Header 在服务间传递(呼应第七章 Header、第九章 RPC)。查日志时用 TraceId 一搜,就能捞出这个请求在所有服务的全部日志。
按自己的节奏,确认真正理解。