
计算机网络 / 系统课时
4.10 粘包与拆包:面向字节流的必修课
粘包与拆包:面向字节流的必修课
🎯 学习目标:理解粘包/拆包的成因,掌握三种解决方案,这是网络编程最常踩的坑。
问题的根源:TCP 没有消息边界
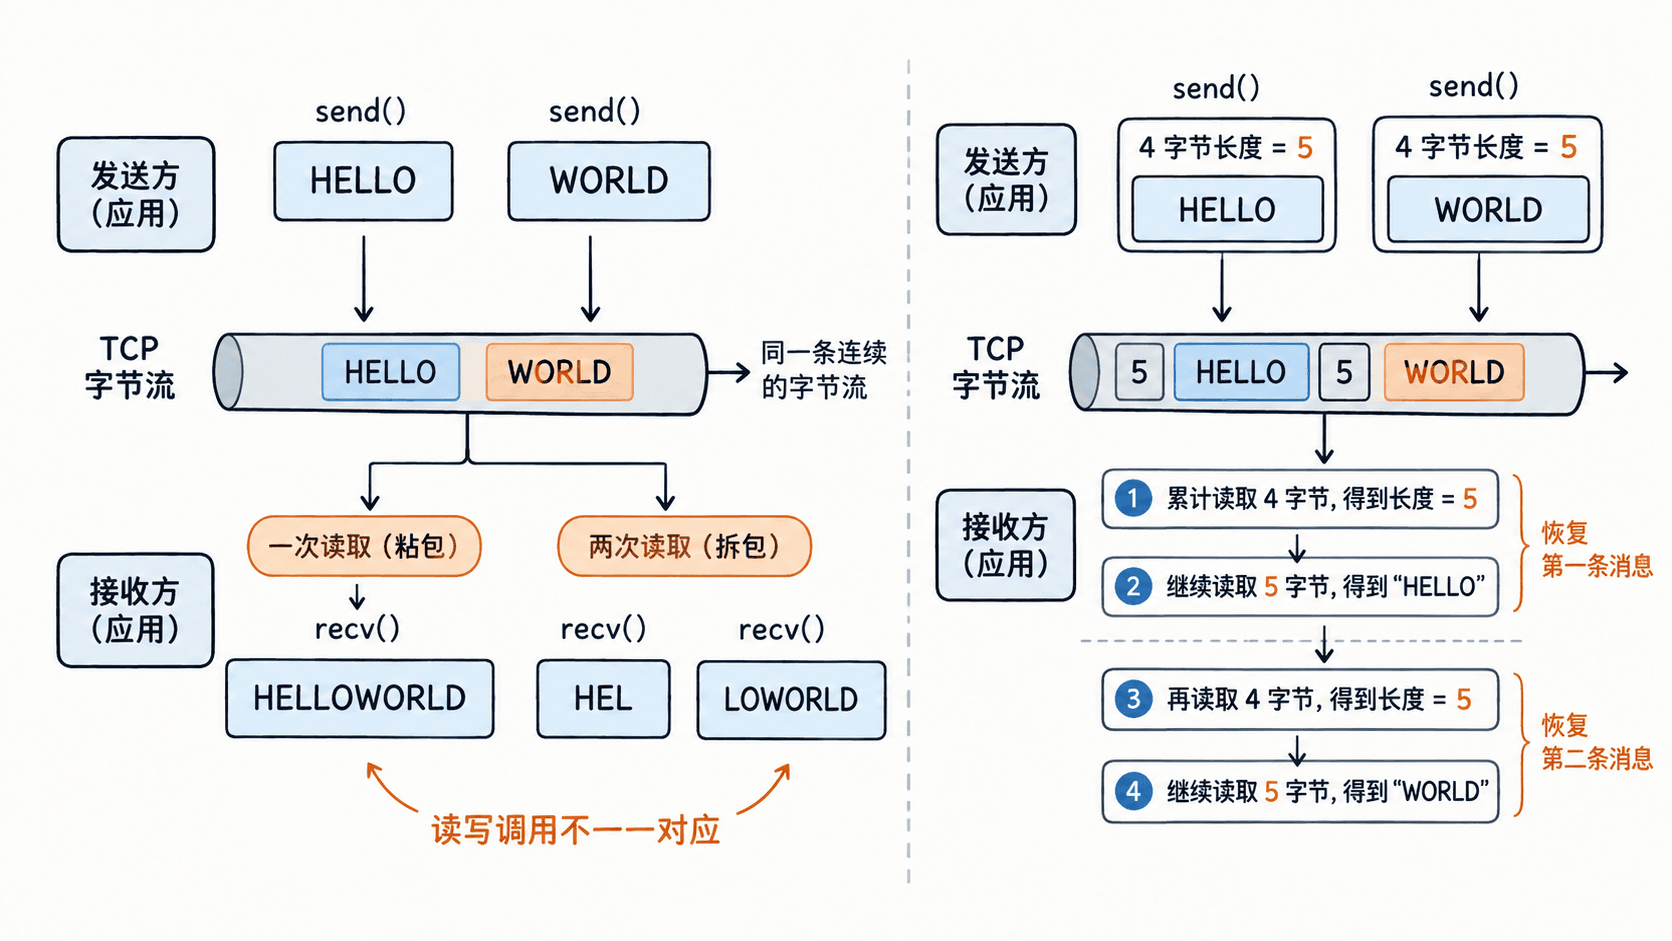
回顾 4.1 的关键点:TCP 是面向字节流的,它只保证字节顺序,不保证"你发几次它就收几次"。你连续发两条业务消息 "HELLO" 和 "WORLD":
- 对方可能一次
read到"HELLOWORLD"—— 粘包(两条粘一起了); - 也可能读到
"HEL"和"LOWORLD"—— 拆包(一条被拆开了)。
成因是多方面的:发送方的 Nagle 算法会合并小包、接收方缓冲区一次取走多段、MSS 限制把大消息切片……所以在字节流上,业务消息的边界必须由应用层自己划定。
三种解决方案
方案一:固定长度。 每条消息定长(如 128 字节),不足补空。简单但浪费,只适合报文规整的场景。
方案二:分隔符。 用特殊字符标记消息结尾,如 HTTP 用 \r\n\r\n 分隔头部。问题是消息体里不能出现分隔符(否则要转义)。
方案三:长度前缀(最常用)。 每条消息前面加一个固定长度的"长度字段",说明后面消息体多长:
text
[4 字节长度=5][HELLO][4 字节长度=5][WORLD]
接收方:先读 4 字节知道长度 5 → 再精确读 5 字节 → 得到完整一条消息
这就是绝大多数 RPC 框架、自定义协议采用的LTV / 长度+内容方案,既高效又无歧义。
Netty 怎么帮你处理
Java 网络编程里,Netty 内置了现成的解码器,不用手写拆包逻辑:
FixedLengthFrameDecoder:固定长度;DelimiterBasedFrameDecoder:分隔符;LengthFieldBasedFrameDecoder:长度前缀(最常用,配置长度字段的偏移和长度即可)。
第九章会用 Netty 实战,届时你会看到"加一个解码器就解决粘包"的写法。
按自己的节奏,确认真正理解。