
计算机网络 / 系统课时
10.9 缓存与消息队列:性能与削峰
缓存与消息队列:性能与削峰
🎯 学习目标:理解 Redis 缓存和消息队列在架构中如何提升性能、削峰解耦。
应用背后的两个关键中间件
请求到了应用服务,业务逻辑往往离不开两个中间件:**Redis(缓存)**扛读、**消息队列(MQ)**削峰解耦。它们和数据库之间也要走网络(TCP 连接,呼应第四、九章的连接池)。
Redis:挡在数据库前面的缓存
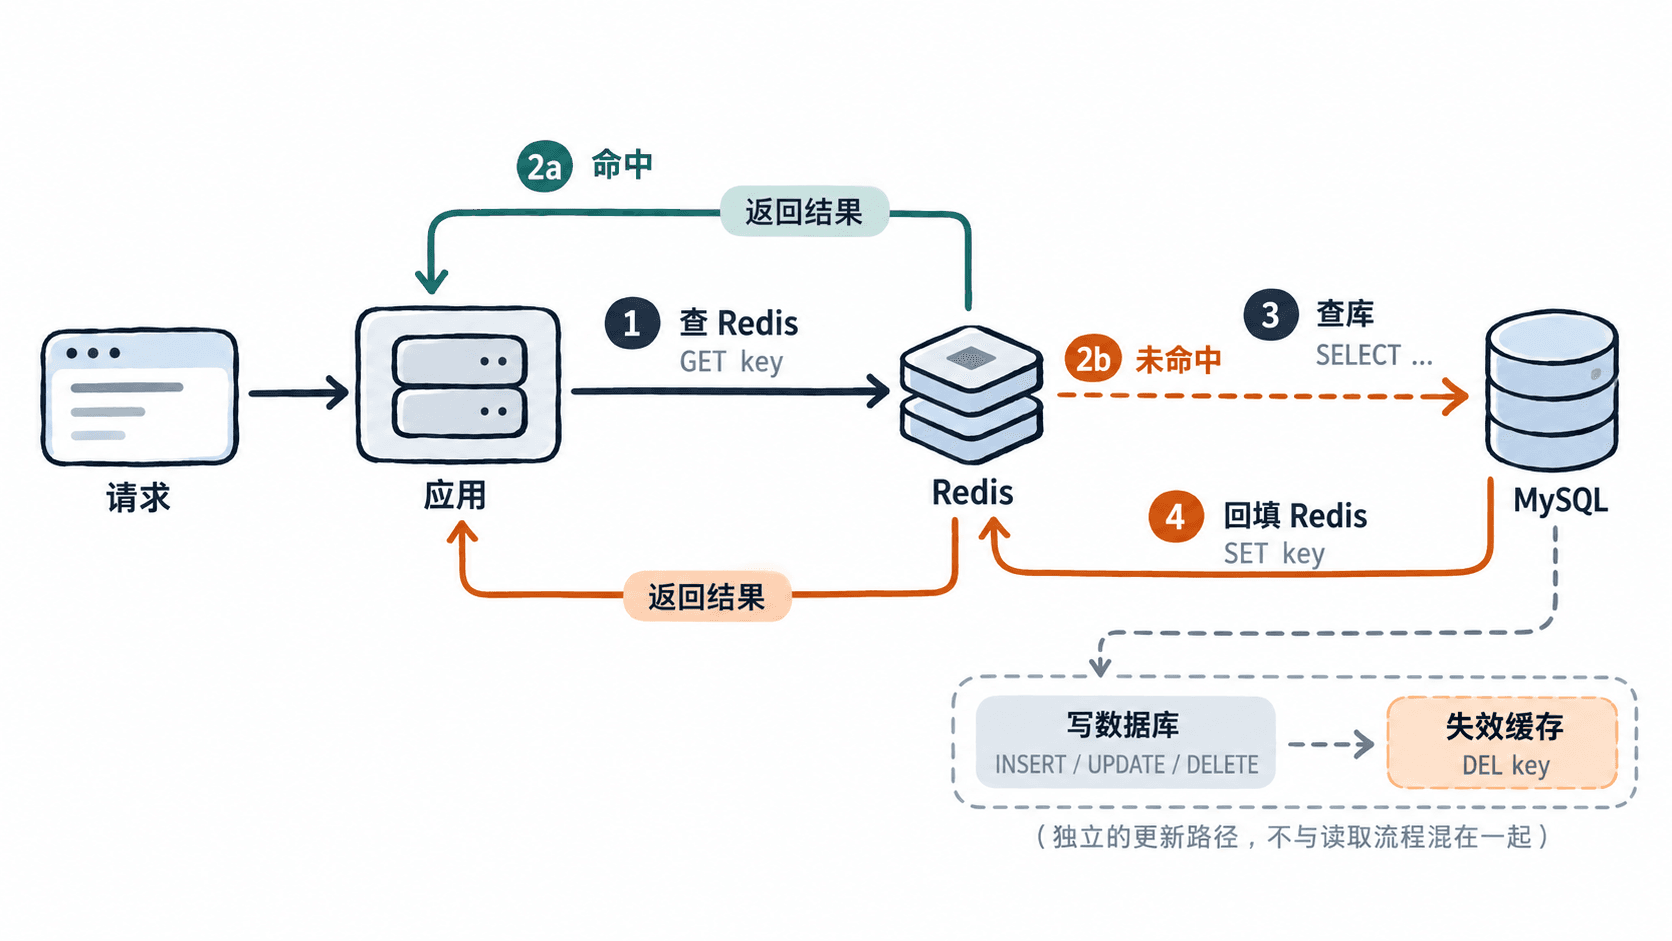
数据库(尤其磁盘 IO)是系统最脆弱的一环,扛不住高并发读。缓存把热点数据放在内存里,绝大多数读请求由 Redis 挡掉,不到数据库:
text
读请求 → 查 Redis
         命中 → 直接返回(快,微秒级)
         未命中 → 查数据库 → 回填 Redis → 返回
一个读多写少的系统,缓存能挡掉 90%+ 的读,数据库压力骤降。Redis 还兼做分布式锁、计数器、排行榜、Session 存储(第七章)等。
缓存的经典问题
用缓存要防三个经典问题(后端面试高频):
| 问题 | 成因 | 应对 |
|---|---|---|
| 缓存穿透 | 查不存在的数据,每次都打到 DB | 空值缓存、布隆过滤器 |
| 缓存击穿 | 热点 key 过期瞬间大量请求压 DB | 互斥锁重建、逻辑过期 |
| 缓存雪崩 | 大量 key 同时过期 | TTL 加随机、多级缓存、限流 |
(本项目已有一篇《Redis 缓存三大问题》文章详解,可对照阅读。)
消息队列:削峰、解耦、异步
**消息队列(RabbitMQ/Kafka/RocketMQ)**解决三类问题:
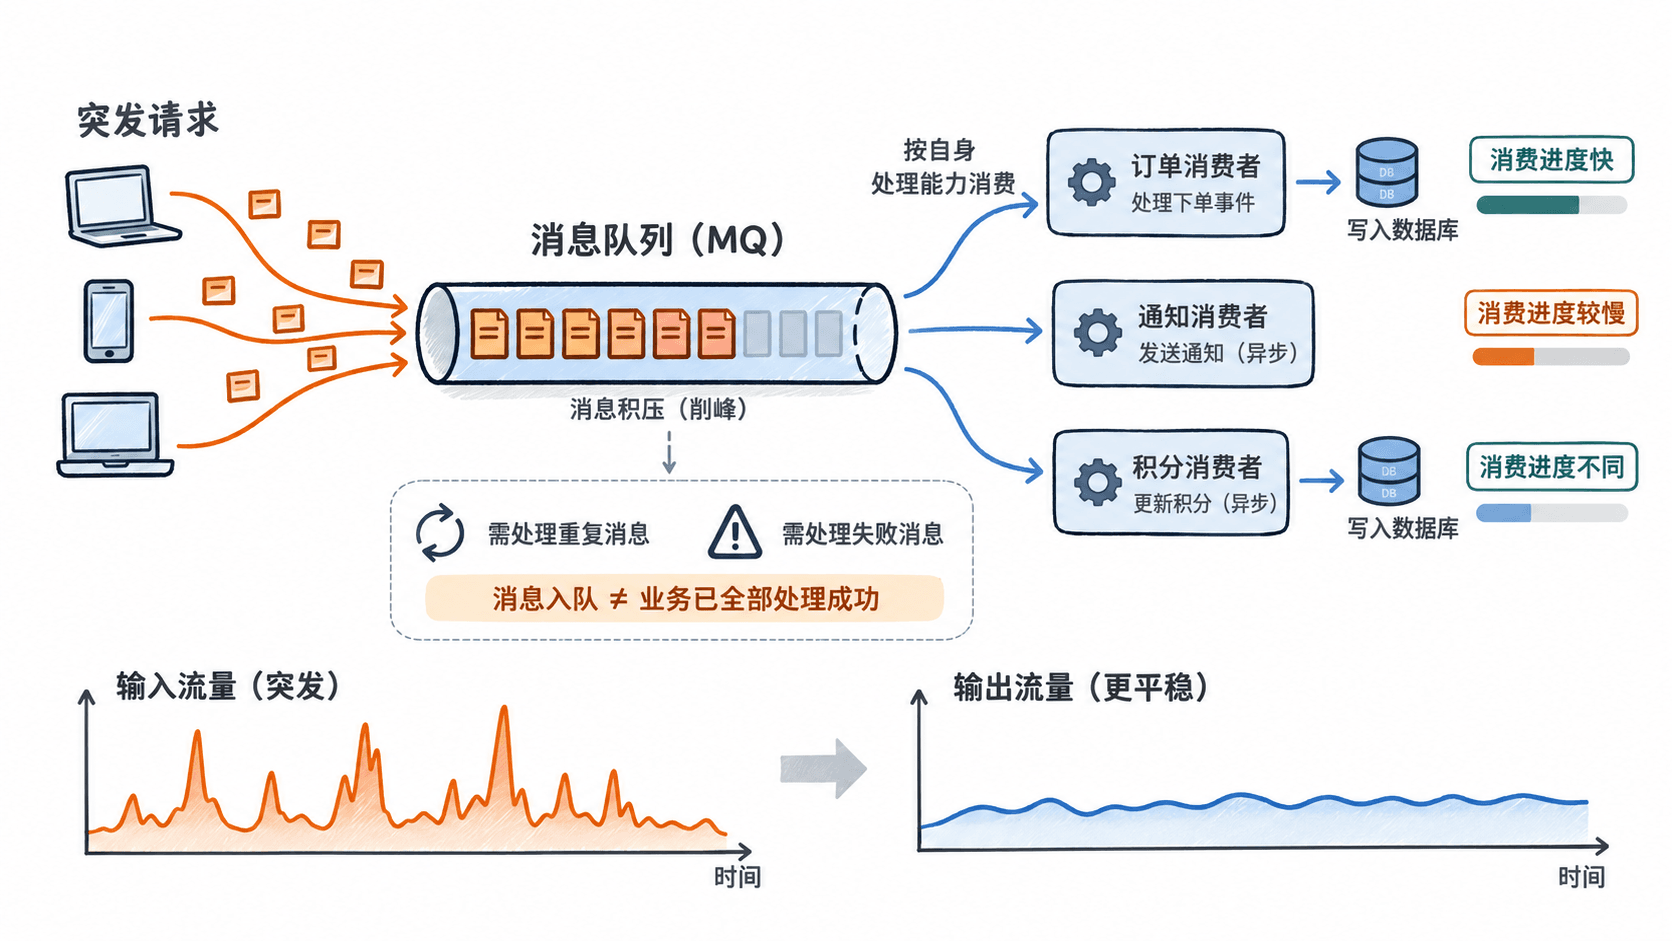
1. 削峰填谷。 秒杀瞬间十万请求,数据库每秒只能处理几千。MQ 把请求先"堆"起来,后端按自己的节奏消费——把尖峰流量削平:
text
海量请求 → MQ 缓冲(堆积)→ 消费者匀速处理 → 数据库平稳2. 系统解耦。 下单后要发短信、加积分、更新推荐……如果同步调用,任一环节慢/挂都拖累下单。改成"下单后发个消息到 MQ",各下游自己订阅消费——下单只管发消息,不关心谁消费、消费多久。
3. 异步提速。 非核心流程(发通知、记日志)异步化,主流程更快返回。
代价与权衡
MQ 引入了新的复杂度:消息可能重复(要幂等消费)、可能丢失(要可靠投递)、顺序问题、消息堆积监控……用 MQ 是拿"最终一致性"换"削峰解耦",要能接受短暂的不一致。
按自己的节奏,确认真正理解。