
计算机网络 / 系统课时
3.7 traceroute:看见数据包走过的每一跳
traceroute:看见数据包走过的每一跳
当访问目标站点超时或延迟异常时,traceroute 可以显示探测报文经过的路由跳点及往返时延。本课通过逐跳探测的原理和一条实际命令,学习如何读取路由路径、识别异常,并避免把不响应的路由器误判为网络中断。
学习目标
- 理解 traceroute 如何利用 TTL 和 ICMP 逐跳发现路由器。
- 能运行 traceroute 或 tracert,读懂跳数、往返时延和
*。 - 能结合后续跳点和业务连通性,判断哪些异常值得继续排查。
巧妙的原理:故意让 TTL 归零
IPv4 报文中的 TTL(Time To Live)每经过一台路由器就减 1。当路由器把 TTL 减到 0 时,通常会丢弃报文,并向源主机返回 ICMP Time Exceeded(超时)报文。traceroute 正是利用这一机制发现路径上的路由器。
它首先发送 TTL=1 的探测报文,使报文在第一台路由器处过期;随后发送 TTL=2、TTL=3 的报文,使探测逐步深入。工具根据 ICMP 回复的源 IP 识别跳点,并计算每次探测从发出到收到回复的往返时间(RTT)。
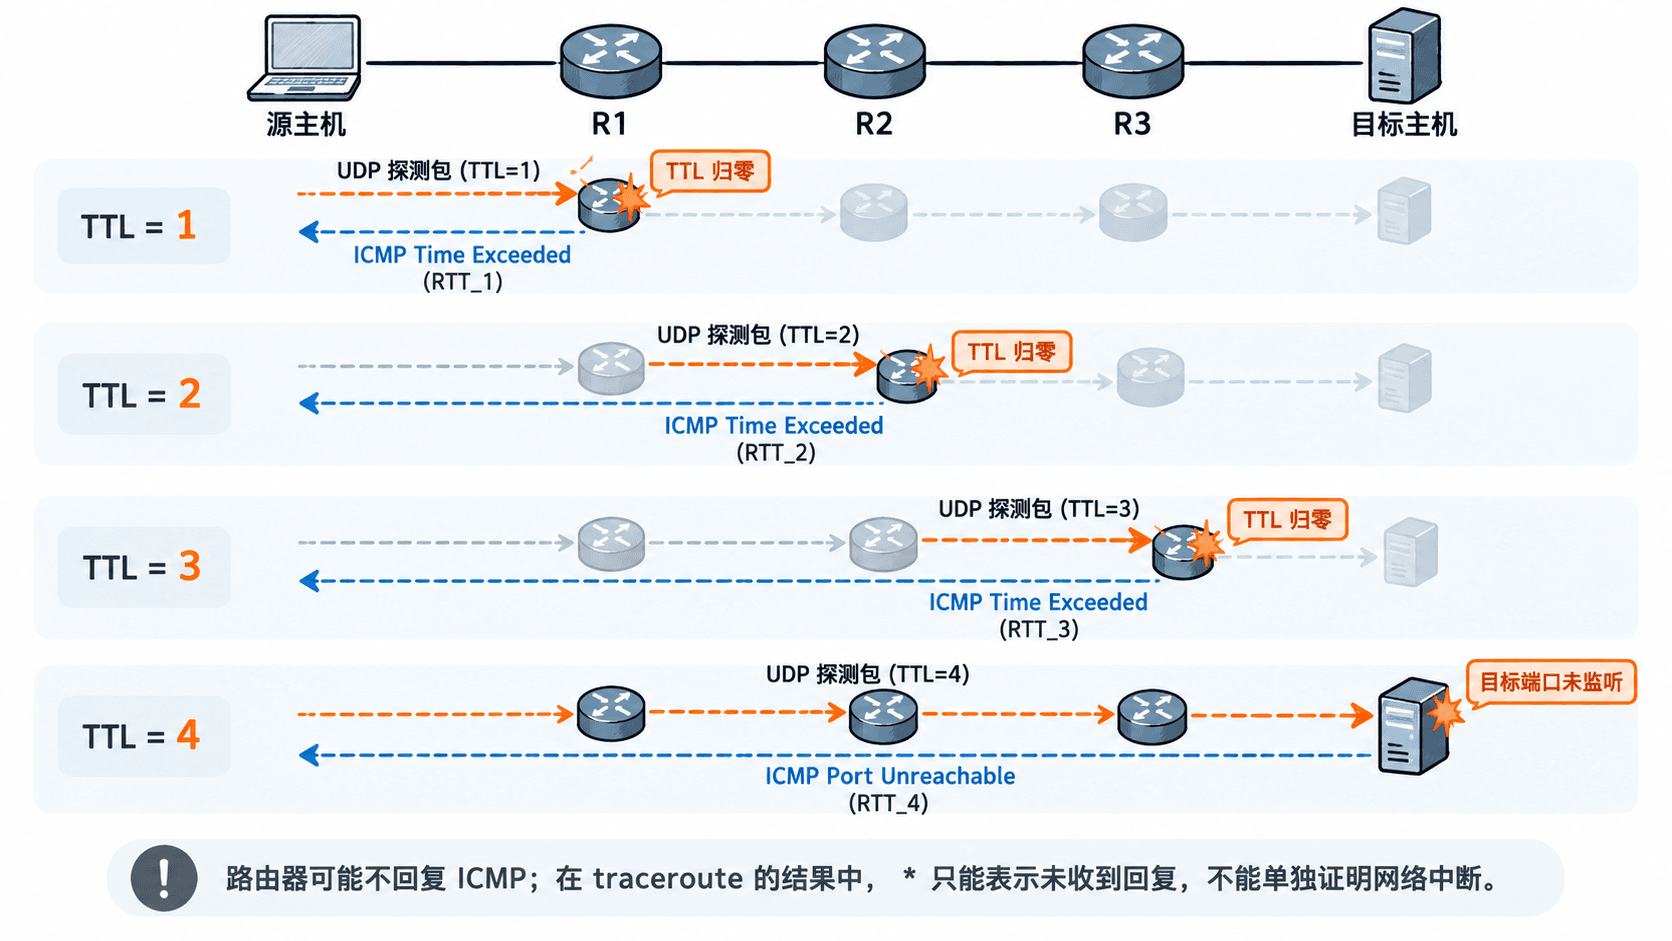
探测到达目标后,结束信号取决于探测协议:传统 Linux UDP traceroute 通常使用较高的目标端口,目标端口未监听时会返回 ICMP Port Unreachable;Windows 的 tracert 默认发送 ICMP Echo Request,目标通常以 Echo Reply 应答。
常见实现默认每跳发送三个探测报文,因此每一行通常显示三个 RTT 测量结果。不过,这些报文可能经过不同的负载均衡路径,显示的路由器地址也不一定完全一致。
运行 traceroute 并读懂输出
在已安装 traceroute 的 Linux 或 macOS 终端中执行以下命令,探测到公共 IP 1.1.1.1 的路径:
# -n 不进行反向 DNS 查询;-q 3 表示每跳发送三个探测包
traceroute -n -q 3 1.1.1.1
预期输出(以下为示意,实际跳数、地址和时延因网络而异):
traceroute to 1.1.1.1 (1.1.1.1), 30 hops max
 1  192.168.1.1    1.2 ms   1.1 ms   1.0 ms
 2  100.64.0.1     5.8 ms   5.9 ms   6.1 ms
 3  * * *
 4  10.20.4.1     12.3 ms  11.8 ms  12.0 ms
 5  1.1.1.1       16.4 ms  16.5 ms  16.3 ms
输出中的第一个数字表示跳数,后面的 IP 是该次探测收到回复时对应的地址,单位为 ms 的数值是 RTT。例如第一跳可能是本地网关,第二跳可能属于运营商接入网络,而最后一行表示探测已到达目标。
第三跳的 * * * 表示三次探测都没有在等待时间内收到可用响应。由于第四跳和第五跳仍然出现了结果,因此不能认为第三跳发生了数据转发中断。常见原因是路由器限制或过滤了 ICMP 回复。
Windows 可以使用 tracert -d 1.1.1.1 执行类似探测,其中 -d 用于跳过地址的反向 DNS 解析。Windows 的探测方式、选项和输出格式与 Linux traceroute 不完全相同。
根据逐跳结果判断异常
traceroute 展示的是探测报文的响应情况,并非每条链路的直接性能测量。排查时应同时观察异常跳点、后续跳点和目标是否可达。
- 某一跳出现
* * *,但后续跳正常:通常是该设备不回复探测报文或对回复限速,不能直接认定为故障。 - 某一跳 RTT 很高,后续又恢复正常:可能只是该路由器处理 ICMP 报文较慢,不代表经过它的数据转发也很慢。
- 某一跳开始,后续多跳和终点 RTT 都明显升高:可能存在拥塞、路径绕行或链路问题,需要结合多次测量确认。
- 从某一跳开始全部为
*,且始终无法到达终点:可能是路径中断,也可能是后续设备或目标过滤探测报文,不能仅凭第一行*定位故障设备。
例如,某次探测中第 4 跳达到 180 ms,但第 5 跳和目标仅为 20 ms,就不应将第 4 跳判定为拥塞点。反过来,如果第 4 跳以后连续多跳都保持约 180 ms,且业务请求也明显变慢,才更值得检查该段路径。
在实际故障中使用 traceroute
当网站访问超时时,可以按下面的顺序排查:
- 检查第一跳是否出现正常响应,并确认本机的 IP 地址、默认网关和本地网络是否正常。
- 观察运营商网络内的跳点是否持续异常,留意是否从某一段开始出现明显的 RTT 增长。
- 检查目标是否响应探测,并使用浏览器或业务端口连接测试确认实际服务是否可达。
- 在不同时间重复测量,保留目标地址、测试时间、完整路径和业务故障现象,作为提交运营商或云厂商工单的依据。
传统 traceroute 的 UDP 或 ICMP 探测可能受到防火墙过滤。对于 HTTPS 服务,可以在支持该选项的 Linux traceroute 实现中尝试 traceroute -T -p 443 目标地址,改用 TCP 探测目标端口 443;部分环境需要管理员权限。TCP 探测可能更接近业务流量,但也不能保证与实际连接经过完全相同的路径。
traceroute 最适合帮助缩小排查范围:它能指出哪些跳点开始出现异常现象,却不能单独证明某台路由器或某段链路已经故障。最终定位仍应以目标连通性、业务表现和多次测量结果相互印证。