
MySQL / 系统课时
理解覆盖索引与索引条件下推
理解覆盖索引与索引条件下推
覆盖索引和 Index Condition Pushdown 都能减少查询成本,但它们解决的不是同一个问题:前者让查询只读索引就能返回结果,后者让存储引擎先在索引层过滤,再决定是否回表。本节通过同一张表把两条执行路径拆开观察。
学习目标
- 区分覆盖索引与 ICP 的作用位置和收益来源
- 从
EXPLAIN的Extra判断Using index与Using index condition - 理解什么时候应该调整索引,而不是依赖 ICP 弥补扫描范围
两种优化发生在不同位置
InnoDB 的二级索引叶子节点保存索引列,并带有主键值。若查询需要返回和判断的列都能从该索引获得,就可以直接从索引完成查询,这就是覆盖索引;最主要的收益是避免根据主键再次访问聚簇索引。
ICP 则发生在另一条路径上:当查询最终仍需回表,但某些过滤条件引用了当前二级索引中的列时,存储引擎可以先检查这些条件,只对通过的索引记录执行回表。它减少的是无效回表次数,而不是保证完全不回表。
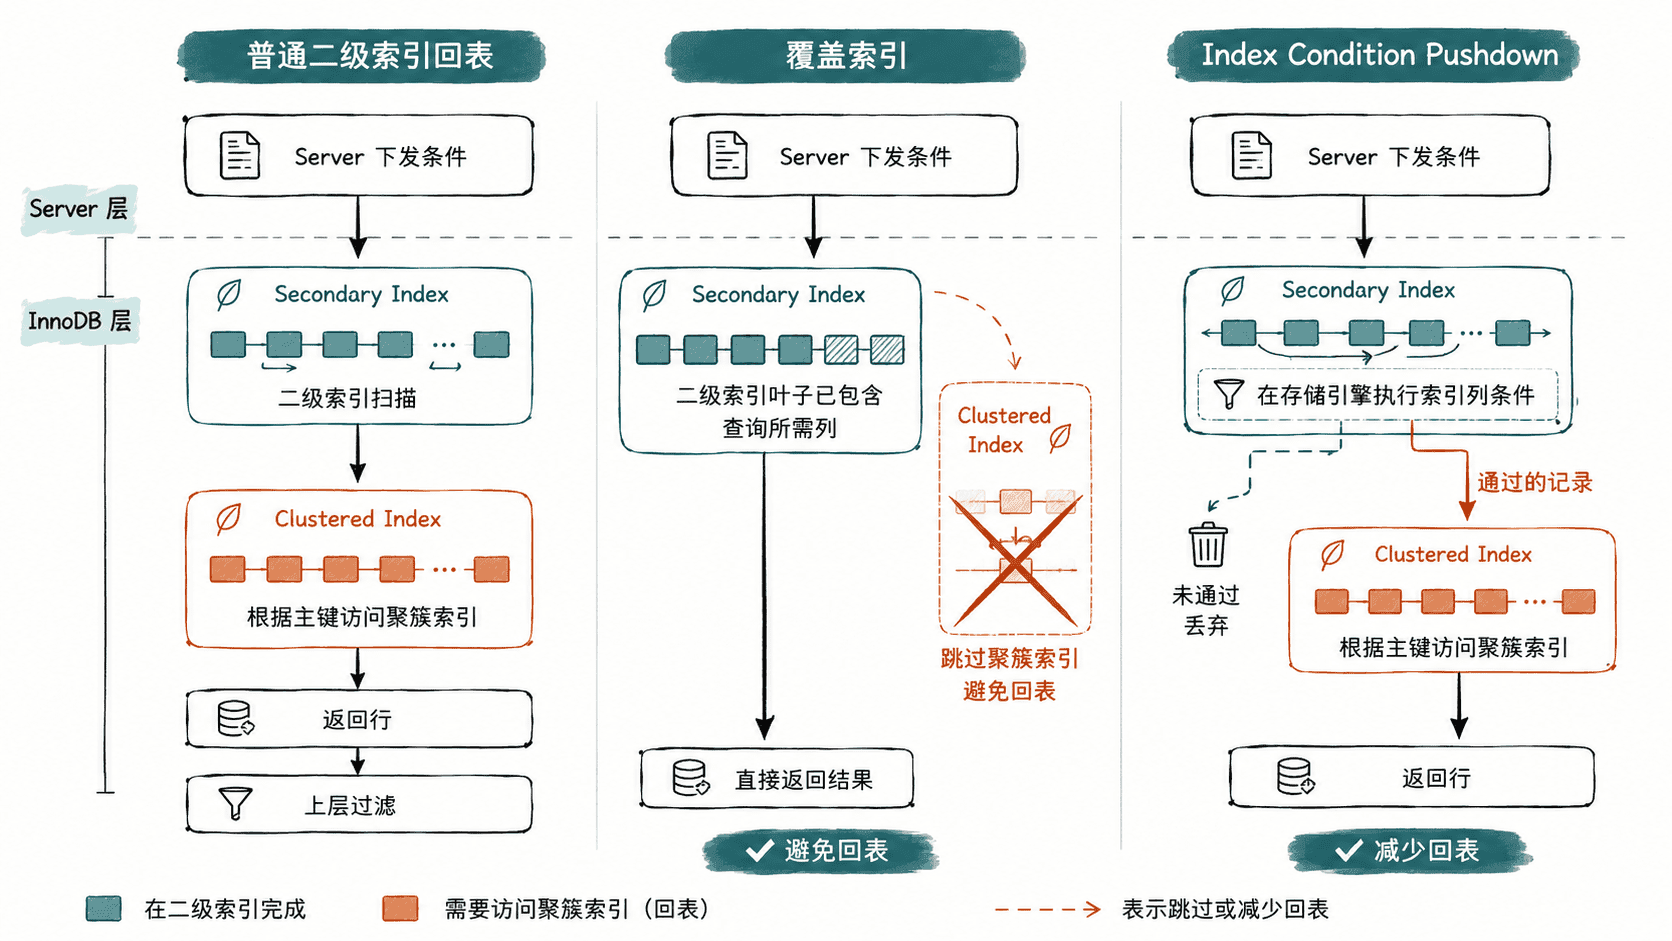
用 EXPLAIN 观察两种 Extra
下面建立索引 (tenant_id, status, amount)。第一条查询只返回索引中的列,可以形成覆盖;第二条查询需要 note,因此必须回表,同时 amount 位于范围列 status 之后,适合观察 ICP 对后续索引条件的提前过滤。
DROP TABLE IF EXISTS orders_icp_demo;

CREATE TABLE orders_icp_demo (
  id BIGINT PRIMARY KEY,
  tenant_id BIGINT NOT NULL,
  status VARCHAR(16) NOT NULL,
  amount DECIMAL(10,2) NOT NULL,
  note VARCHAR(100) NOT NULL,
  KEY idx_tenant_status_amount (tenant_id, status, amount)
) ENGINE=InnoDB;

INSERT INTO orders_icp_demo VALUES
  (1, 1, 'NEW',    80.00, 'first'),
  (2, 1, 'PAID',  120.00, 'second'),
  (3, 1, 'PAID',  180.00, 'third'),
  (4, 1, 'REFUND', 60.00, 'fourth'),
  (5, 2, 'PAID',  220.00, 'fifth');

SET optimizer_switch = 'index_condition_pushdown=on';

EXPLAIN
SELECT status, amount
FROM orders_icp_demo FORCE INDEX (idx_tenant_status_amount)
WHERE tenant_id = 1
  AND status = 'PAID';

EXPLAIN
SELECT note
FROM orders_icp_demo FORCE INDEX (idx_tenant_status_amount)
WHERE tenant_id = 1
  AND status > 'M'
  AND amount >= 150.00;
预期结果:不同 MySQL 8.x 小版本的成本估算、rows 和 key_len 可能不同,但应重点观察 Extra 中的以下标记。
第一条查询:Extra 包含 Using index
第二条查询:Extra 包含 Using index condition
FORCE INDEX 只用于让这个小数据集更稳定地演示指定索引,不是生产环境的默认优化手段。真实业务仍应先让优化器基于统计信息选择访问路径。
覆盖索引为什么能避免回表
第一条查询的过滤列 tenant_id、status 和返回列 status、amount 都能从 idx_tenant_status_amount 取得,因此存储引擎不需要再根据主键访问聚簇索引。EXPLAIN 常用 Using index 表示这一覆盖访问。
InnoDB 二级索引叶子还隐含保存主键值,所以只额外返回主键列时,查询也可能继续保持覆盖。判断时不要只看索引定义里显式写了哪些列,而要结合 InnoDB 的二级索引结构。
覆盖不是“索引越宽越好”。把大字符串或大量低价值列塞进索引,会增加索引空间、写入放大、页分裂和缓存压力。只有高频查询确实能显著减少回表时,才值得为覆盖增加列。
ICP 为什么只是提前过滤
第二条查询先利用 tenant_id = 1,再在 status > 'M' 上形成范围。由于 amount 位于这个范围列之后,它通常不能继续缩小扫描边界,但它仍存在于二级索引条目中。
开启 ICP 后,InnoDB 在读取每个候选索引条目时就能先判断 amount >= 150.00。不满足的条目不会再按主键读取整行;满足的条目才回表取得 note。因此 Using index condition 表示“索引层先过滤”,而不是“没有回表”。
设计时怎么选
可以用“是否还需要访问聚簇索引”作为第一判断线:如果查询所需数据全部在索引中,优先考虑覆盖;如果仍要回表,再看是否有索引列上的残余条件可以通过 ICP 提前淘汰候选记录。
| 维度 | 覆盖索引 | Index Condition Pushdown |
|---|---|---|
| 主要目标 | 避免回表 | 减少无效回表 |
| 是否要求查询列都在索引中 | 是 | 否 |
常见 Extra |
Using index |
Using index condition |
| 是否能修复错误的索引前缀 | 不能 | 不能 |
| 典型代价 | 索引可能变宽 | 仍需扫描候选索引条目并对部分记录回表 |
看到 Using index 时,先确认查询是否真正被覆盖;看到 Using index condition 时,则继续关注候选扫描量和实际回表量。两者都只是执行路径信号,最终仍要结合访问范围、返回行数和索引维护成本判断是否值得。