
MySQL / 系统课时
定位索引未命中与扫描放大
定位索引未命中与扫描放大
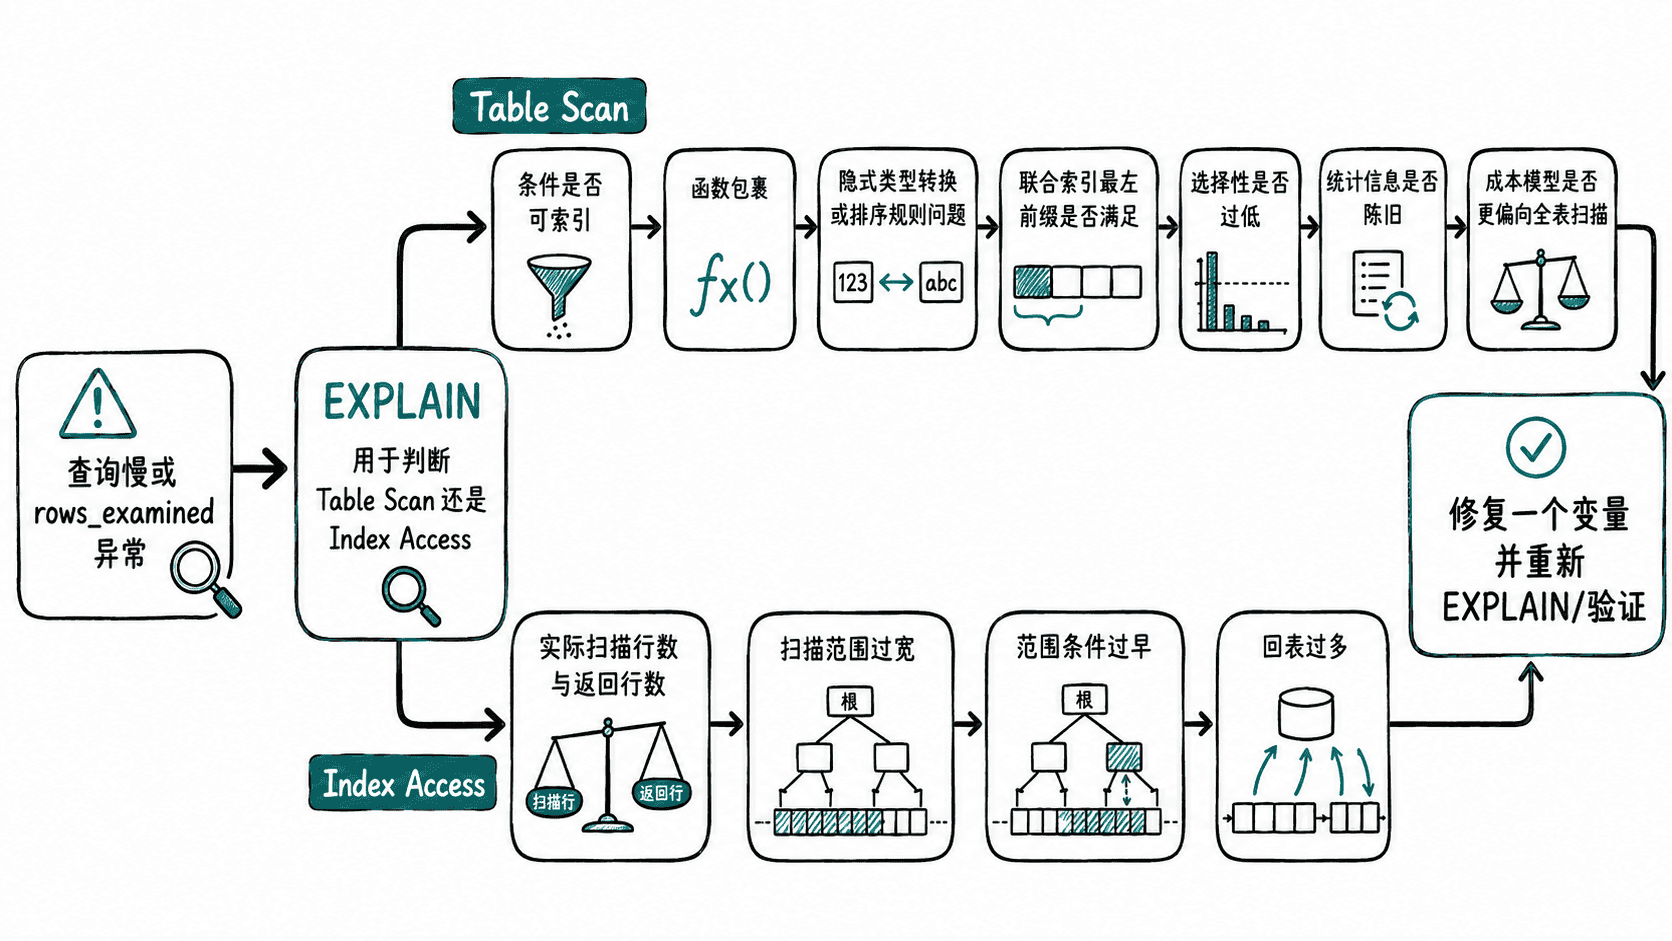
“表上明明有索引,优化器却没走”不能直接归因于 MySQL 选错了。应先确认访问路径,再按条件可索引性、类型转换、联合索引前缀、选择性、统计信息与成本逐层排除,同时用实际扫描行数判断问题究竟是未命中还是扫描范围过大。
学习目标
- 从执行计划证据区分索引未使用与索引扫描放大
- 识别函数、隐式转换、前导通配符和联合索引顺序造成的访问路径问题
- 判断统计信息与成本模型何时会让优化器主动选择全表扫描
先确认“没走索引”的证据
不要只看 possible_keys。真正需要关注的是最终访问路径、估算行数,以及运行时实际扫描了多少行。下面是片段示例,依赖业务中的 orders 表和已有索引:
EXPLAIN FORMAT=TREE
SELECT id, created_at
FROM orders
WHERE tenant_id = 42
  AND status = 'PAID'
  AND created_at >= '2026-09-01';
预期输出
-> Table scan on orders
   -> Filter: <predicate>
      <estimated rows and cost>
如果计划显示 Table scan,才属于“未使用索引”的直接证据;如果已经是 Index range scan,但仍读取大量行,问题通常变成“索引范围太宽”或“过滤条件未充分参与定位”。
先排除条件写法破坏索引定位
B+Tree 能高效定位的前提是条件能直接落到有序键上。常见问题包括:对索引列做函数计算、列与参数发生隐式类型转换、LIKE '%abc' 使用前导通配符,以及联合索引没有从有效左前缀开始。
例如索引列是 created_at 时,DATE(created_at) = '2026-09-03' 会把函数作用在列上;改成 created_at >= '2026-09-03 00:00:00' AND created_at < '2026-09-04 00:00:00',优化器才更容易把条件转成连续范围。类似地,字符串列与数字常量比较时,也要确认字段类型、参数类型和字符集/排序规则没有触发额外转换。
看扫描放大而不是只看是否用了索引
索引命中并不代表访问路径高效。一个低选择性的索引可能命中几十万行,再回表过滤出几十行;这时 key 看起来正确,实际扫描量仍然很大。
可以用扫描放大率辅助判断:
当放大率很高时,重点检查联合索引列顺序。等值条件通常应尽量形成稳定前缀,再让首个范围条件限定连续区间;如果范围条件过早出现,后面的列即使写在索引里,也可能无法继续缩小扫描边界。
再判断统计信息和成本选择
即使条件和索引结构都合理,优化器仍可能因为估算结果选择全表扫描。典型场景是某个状态值占据表中大多数记录,走二级索引后需要大量回表,此时顺序读全表可能更便宜;另一类场景是数据刚批量导入或分布发生明显变化,而统计信息尚未反映现状。
怀疑统计信息陈旧时,可以先刷新目标表统计信息:
ANALYZE TABLE orders;预期输出
Table        Op       Msg_type  Msg_text
<DB>.orders  analyze  status    OK
数据库名可能不同。刷新后应重新获取执行计划;如果访问路径恢复合理,说明旧统计信息影响了基数和成本估算。如果仍然全表扫描,就继续比较选择性与回表成本,不要反复 ANALYZE TABLE 期待强制走索引。
用最小对照确认真正根因
修复时一次只改变一个变量:先记录原计划和扫描量,再改条件写法、索引列顺序或统计信息中的一项,然后重新执行计划分析。若估算行数明显下降、访问类型改善且实际扫描量同步减少,才能说明修改命中了根因。
如果索引存在但优化器始终不选,最后再检查它是否可见、是否覆盖当前过滤与排序需求,以及查询返回比例是否已经高到不值得走二级索引。优化目标不是“强迫使用索引”,而是在真实数据分布下让扫描范围、回表次数和总成本一起下降。