
MySQL / 系统课时
用直方图改善基数估算
用直方图改善基数估算
当过滤列的数据高度倾斜时,优化器如果不了解真实分布,就可能把少量值估成大量行,进而误判访问路径或连接顺序。本节在 MySQL 8.4 中构造倾斜数据,创建直方图,并对比创建前后的估算结果。
学习目标
- 判断哪些倾斜列值得建立直方图。
- 读懂 singleton、equi-height、桶数与选择性之间的关系。
- 用
ANALYZE TABLE创建、检查和维护直方图,并用EXPLAIN ANALYZE验证估算是否改善。
倾斜数据为什么会误导估算
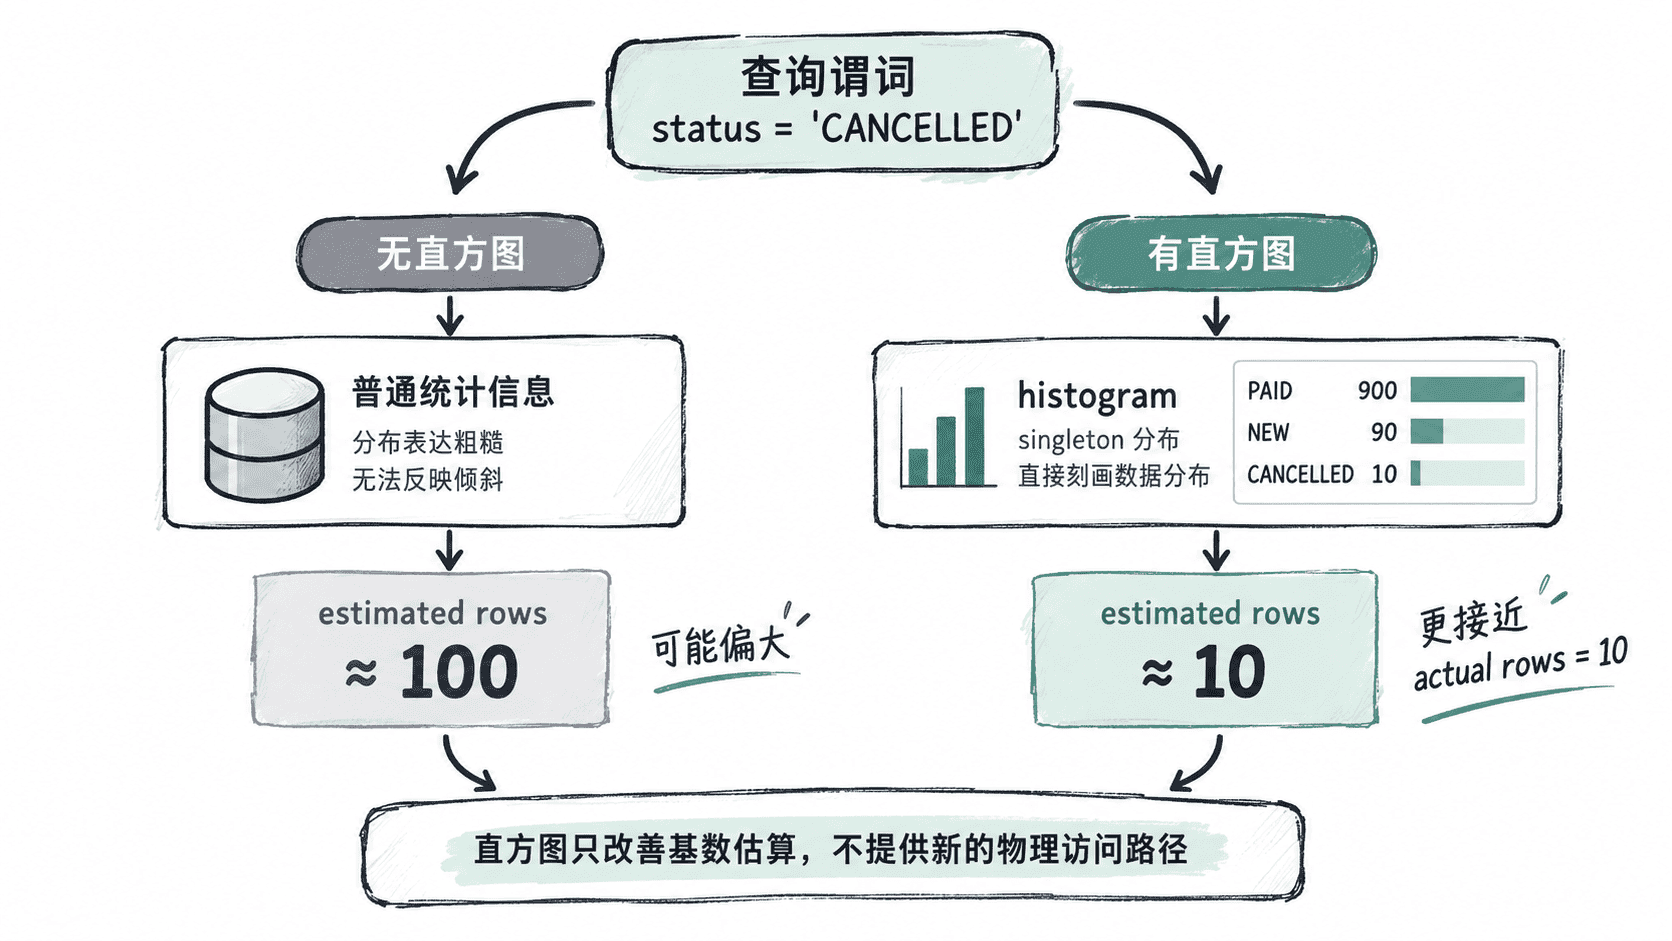
优化器比较计划时依赖“预计会有多少行继续向下流动”。对于没有合适索引、且值分布很不均匀的列,普通统计信息难以表达“90% 行为 PAID、1% 行为 CANCELLED”这样的分布,过滤行数就可能估偏。
直方图记录的是列值分布统计,作用是帮助优化器估算谓词选择性;它不会像 B+Tree 索引那样提供新的物理访问路径。对于已经能通过索引范围估算或 index dive 得到较可靠行数的条件,直方图通常不是第一选择。
构造可重复的倾斜样本
下面创建 1000 行订单状态,其中 900 行是 PAID、90 行是 NEW、10 行是 CANCELLED。表上故意不为 status 建索引,让估算主要依赖统计信息。实验表统一使用 histogram_demo,清理语句也必须删除同名表。
DROP TABLE IF EXISTS histogram_demo;

CREATE TABLE histogram_demo (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    status VARCHAR(16) NOT NULL,
    amount DECIMAL(10,2) NOT NULL
);

INSERT INTO histogram_demo (status, amount)
WITH RECURSIVE seq(n) AS (
    SELECT 1
    UNION ALL
    SELECT n + 1 FROM seq WHERE n < 1000
)
SELECT
    CASE
        WHEN n <= 900 THEN 'PAID'
        WHEN n <= 990 THEN 'NEW'
        ELSE 'CANCELLED'
    END,
    100.00 + n / 100
FROM seq;

SELECT status, COUNT(*) AS rows_count
FROM histogram_demo
GROUP BY status
ORDER BY rows_count DESC;
预期结果
status     rows_count
PAID       900
NEW        90
CANCELLED 10先刷新普通表统计,再观察没有直方图时的估算。EXPLAIN ANALYZE 会真正执行查询,因此实验应放在测试环境。
ANALYZE TABLE histogram_demo;

EXPLAIN ANALYZE
SELECT id, amount
FROM histogram_demo
WHERE status = 'CANCELLED';
预期结果
实际返回行数应为 10。
执行树会同时显示 estimated rows 与 actual rows;未创建直方图时的 estimated rows 取决于当前统计信息,记为 <VALUE>。
创建并读取直方图
WITH 16 BUCKETS 表示请求最多 16 个桶。示例列只有 3 个不同值,因此会形成 singleton 直方图,每个值都可以单独表示;当不同值更多、无法由桶逐个覆盖时,则使用 equi-height 桶近似值域分布。
ANALYZE TABLE histogram_demo
UPDATE HISTOGRAM ON status
WITH 16 BUCKETS
MANUAL UPDATE;

SELECT
    COLUMN_NAME,
    HISTOGRAM->>'$."histogram-type"' AS histogram_type,
    HISTOGRAM->>'$."number-of-buckets-specified"' AS requested_buckets,
    HISTOGRAM->>'$."sampling-rate"' AS sampling_rate
FROM INFORMATION_SCHEMA.COLUMN_STATISTICS
WHERE SCHEMA_NAME = DATABASE()
  AND TABLE_NAME = 'histogram_demo'
  AND COLUMN_NAME = 'status';
预期结果
COLUMN_NAME  histogram_type  requested_buckets  sampling_rate
status       singleton       16                 <VALUE>
sampling_rate 表示生成统计时读取的数据比例,1 表示未采样。大表可能因为直方图生成时的采样而使用低于 1 的比例,因此生产环境不要把桶内容理解成逐行精确计数。
MySQL 8.4 支持 AUTO UPDATE 和 MANUAL UPDATE。MANUAL UPDATE 适合由变更流程或维护窗口显式控制统计刷新;AUTO UPDATE 则允许直方图随父表统计维护而自动更新。未显式指定时使用 MANUAL UPDATE,因此需要自动维护时应在创建直方图时明确启用 AUTO UPDATE。
ANALYZE TABLE histogram_demo
UPDATE HISTOGRAM ON status
WITH 16 BUCKETS
AUTO UPDATE;

ANALYZE TABLE histogram_demo;
预期结果
两条语句均应成功执行。
第二条 ANALYZE TABLE 会重新计算表统计,并按已启用的 AUTO UPDATE 策略刷新 status 直方图。
再次执行同一条查询即可验证估算是否向真实值收敛。
EXPLAIN ANALYZE
SELECT id, amount
FROM histogram_demo
WHERE status = 'CANCELLED';
预期结果
actual rows 仍为 10。
创建直方图后,estimated rows 应更接近真实的 10 行;具体 cost 与计时为 <VALUE>。这里关注的不是执行时间变快了多少,而是估算行数更可信。估算改善后,真正受益的往往是更复杂查询中的连接顺序、访问路径或排序方案选择。
桶数与维护边界
桶越多,通常越能描述细粒度分布,但会增加统计生成与存储成本;桶太少则可能把差异很大的值压进同一范围。实际调优时应通过计划对比验证桶数,而不是机械地把桶数设得很大。
直方图尤其适合分布明显倾斜、经常参与过滤但不值得单独建索引的列;不同值较少时常能形成 singleton,不同值较多时则由 equi-height 桶近似分布。如果过滤列已有高效索引,范围优化器或 index dive 能给出更直接的估算,应先验证它们是否已经足够准确。
在 MySQL 8.4 中,维护策略应同时考虑数据变化和更新方式:需要随表统计自动刷新时,可以创建直方图时启用 AUTO UPDATE;希望由变更流程或维护窗口显式控制时,使用 MANUAL UPDATE,再按实际数据分布执行 UPDATE HISTOGRAM。无论采用哪种模式,都应把“统计是否仍然代表当前数据”纳入验证,而不是只依赖模式本身。
数据分布发生明显变化后,应重新检查 INFORMATION_SCHEMA.COLUMN_STATISTICS,并根据所选维护模式确认直方图是否已经更新。判断是否值得保留它的标准不是“计划看起来更复杂”,而是同一业务谓词的 estimated rows 是否更接近 actual rows,以及最终计划是否因此更合理。