
MySQL / 系统课时
理解查询执行与优化链路
理解查询执行与优化链路
一条 SQL 变慢,不一定是“索引没建好”。本课把查询从进入 MySQL 到结果返回的链路拆开,建立一套可定位成本来源的心智模型,并用 EXPLAIN ANALYZE 把优化器估算与真实执行行为对应起来。
学习目标
- 说清 SQL 解析、优化器选路、InnoDB 访问、执行算子和结果返回之间的关系
- 区分“优化器估算成本”和“执行阶段真实耗时”,避免只凭
type或key下结论 - 能用
EXPLAIN ANALYZE找到实际执行中的高耗时节点和行数偏差
一条查询经历了什么
客户端发送 SQL 后,MySQL 先完成解析与语义检查,确认表、列和表达式是否合法。随后优化器基于统计信息、可用索引、连接顺序和代价模型生成执行方案。执行器按该方案驱动存储引擎读取数据,再完成过滤、连接、聚合、排序等算子,最后把结果返回客户端。
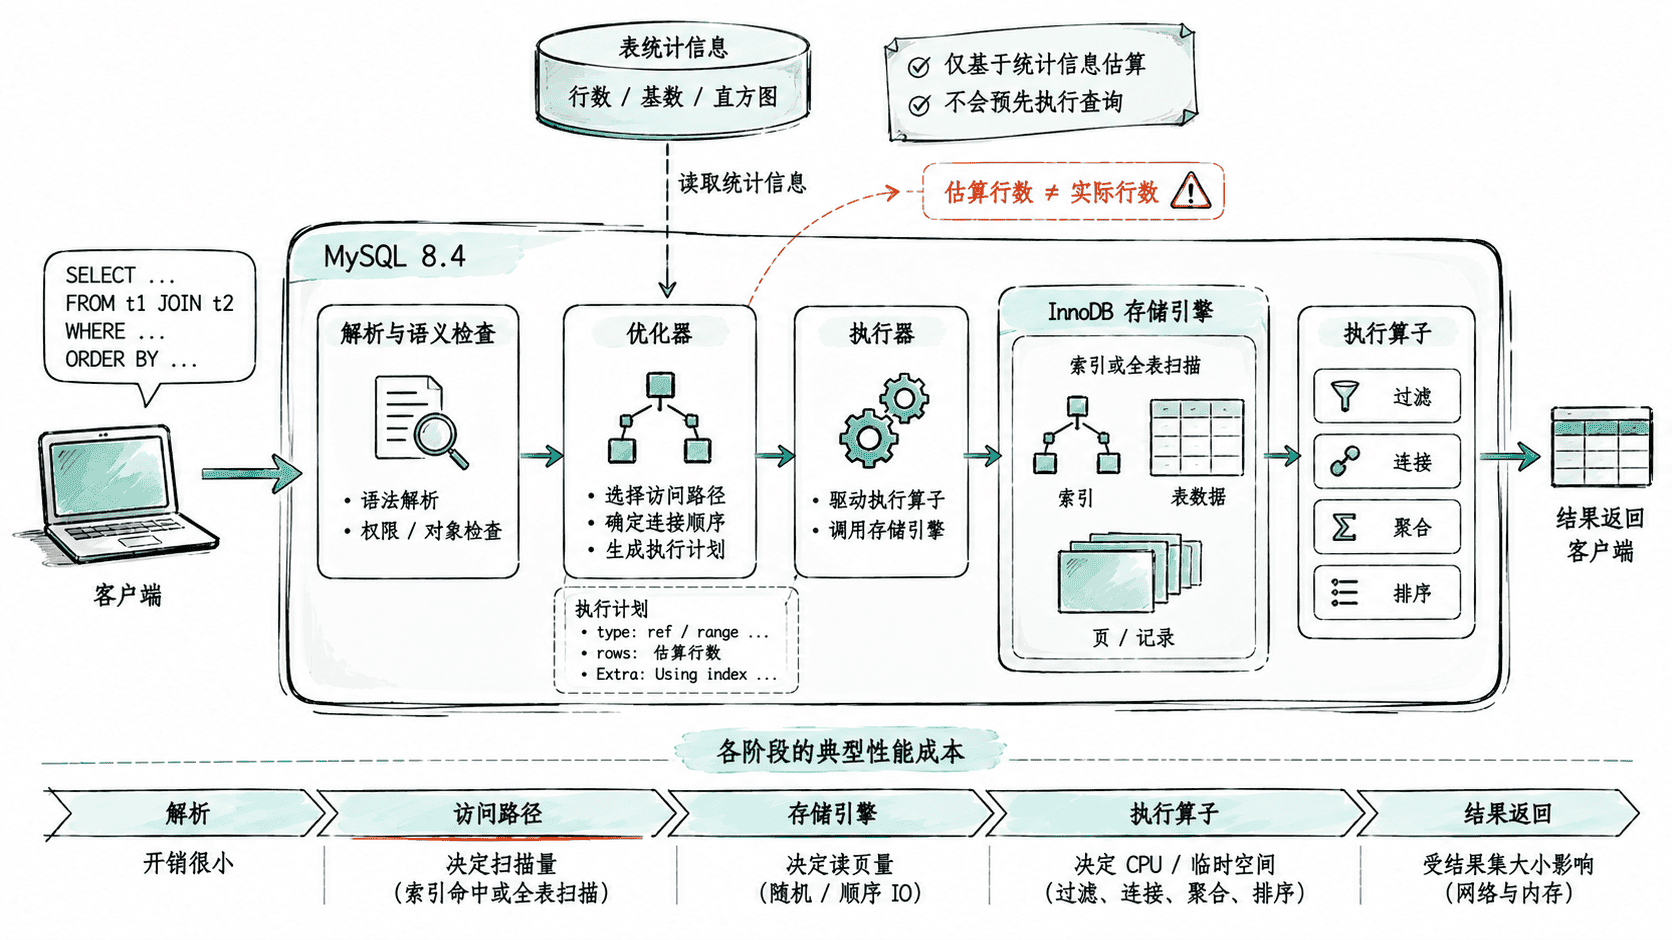
这里最关键的分界是:优化器负责决定怎么做,执行器和 InnoDB 负责真正去做。因此执行计划首先是“选择结果”,不是实际运行日志。普通 EXPLAIN 展示的是估算;EXPLAIN ANALYZE 会真正执行语句,并补充真实时间、循环次数与实际行数。
访问路径决定扫描量
同一个查询可能有多种候选路径:全表扫描、主键点查、二级索引范围扫描,或者在多表查询中使用不同连接顺序。优化器会比较候选方案的预估代价,而不是简单遵循“有索引就一定用索引”。
先用一个最小示例观察执行计划。假设已经存在 orders 表,且 customer_id 上有普通索引:
EXPLAIN ANALYZE
SELECT id, customer_id, status
FROM orders
WHERE customer_id = 10001;
预期输出会包含实际执行节点、估算行数、实际行数和耗时;具体数字会随数据量、缓存状态与统计信息变化:
-> Index lookup on orders using idx_customer_id (customer_id=10001)
   (cost=<VALUE> rows=<VALUE>)
   (actual time=<TIME>..<TIME> rows=<VALUE> loops=1)
看到 Index lookup 只能说明选中了索引访问,不能直接证明查询已经足够快。仍要继续看实际返回行数、节点耗时,以及上层是否还有昂贵的排序、聚合或重复循环。
从执行计划看真实成本
阅读 EXPLAIN ANALYZE 时,优先回答三个问题。
第一,实际扫描了多少行。如果索引节点实际读取几十万行,但最终只返回几十行,通常说明访问路径或索引前缀的过滤能力不足。
第二,估算与实际是否严重偏离。优化器依赖统计信息估算行数。估算 10 行、实际 100000 行时,后续连接顺序、连接算法或是否使用某个索引都可能因此受到影响。
第三,时间花在哪个节点。查询总耗时往往集中在少数节点,例如大范围扫描、嵌套循环反复执行内表访问、排序或聚合。不要把所有注意力都放在最底层的索引名称上。
优化动作要对应链路位置
如果问题出在访问路径,应优先检查谓词写法、索引列顺序、选择性和统计信息;如果实际扫描量已经很小,但排序或聚合很重,就应继续处理算子成本;如果服务端执行很快而客户端仍慢,则要检查结果集大小、网络传输和应用消费速度。
一个有效的优化过程不是“看到慢 SQL 就加索引”,而是先确认成本发生在哪一段,再对症修改。后续分析执行计划、设计索引和验证优化效果,都应沿着这条链路逐层收敛。