
MySQL / 系统课时
处理执行计划突变与性能回退
处理执行计划突变与性能回退
当同一条 SQL 在代码未改动时突然变慢,重点不是立刻加索引,而是证明“哪一个选择变了、为什么变、怎样安全恢复”。本节给出一套可复用的 plan regression 排查路径,把计划差异、估算偏差、统计信息和环境变化串成证据链。
学习目标
- 用同一 SQL、同一参数对比回退前后的执行计划与实际行数
- 根据数据分布、统计信息、索引、参数和版本变化定位计划突变来源
- 选择统计信息修复、索引调整、查询提示或回滚,并完成复测
先确认慢的是计划而不是别的资源
计划回退的前提是:SQL 逻辑与关键参数基本一致,但访问路径、连接顺序、扫描范围或排序方式发生变化。先排除锁等待、磁盘抖动、并发飙升等“计划没变但执行环境变了”的情况,再比较计划。
片段示例:下面假设当前库存在 orders 表,且线上慢 SQL 的关键条件如下。先用 EXPLAIN FORMAT=JSON 保存优化器估算,再在可控环境用 EXPLAIN ANALYZE 获取实际行数与循环次数。
EXPLAIN FORMAT=JSON
SELECT id, customer_id, total_amount, created_at
FROM orders
WHERE tenant_id = 42
  AND status = 'PAID'
  AND created_at >= '2026-08-01 00:00:00'
ORDER BY created_at DESC
LIMIT 50;

EXPLAIN ANALYZE
SELECT id, customer_id, total_amount, created_at
FROM orders
WHERE tenant_id = 42
  AND status = 'PAID'
  AND created_at >= '2026-08-01 00:00:00'
ORDER BY created_at DESC
LIMIT 50;
预期结果
EXPLAIN FORMAT=JSON:返回包含访问路径、索引选择和估算行数的 JSON 计划。
EXPLAIN ANALYZE:返回 TREE 计划,并在各算子上出现 actual time、rows、loops。
具体 cost、time 与 rows 会随数据和机器变化,应记录为 <VALUE> 后与历史基线比较。对比时不要只看“用了哪个索引”。真正有诊断价值的是从上到下找到第一个明显分叉点:估算行数是否突然失真、驱动表是否变化、一次索引探测是否被放大成大量循环、是否新增了临时表或排序。
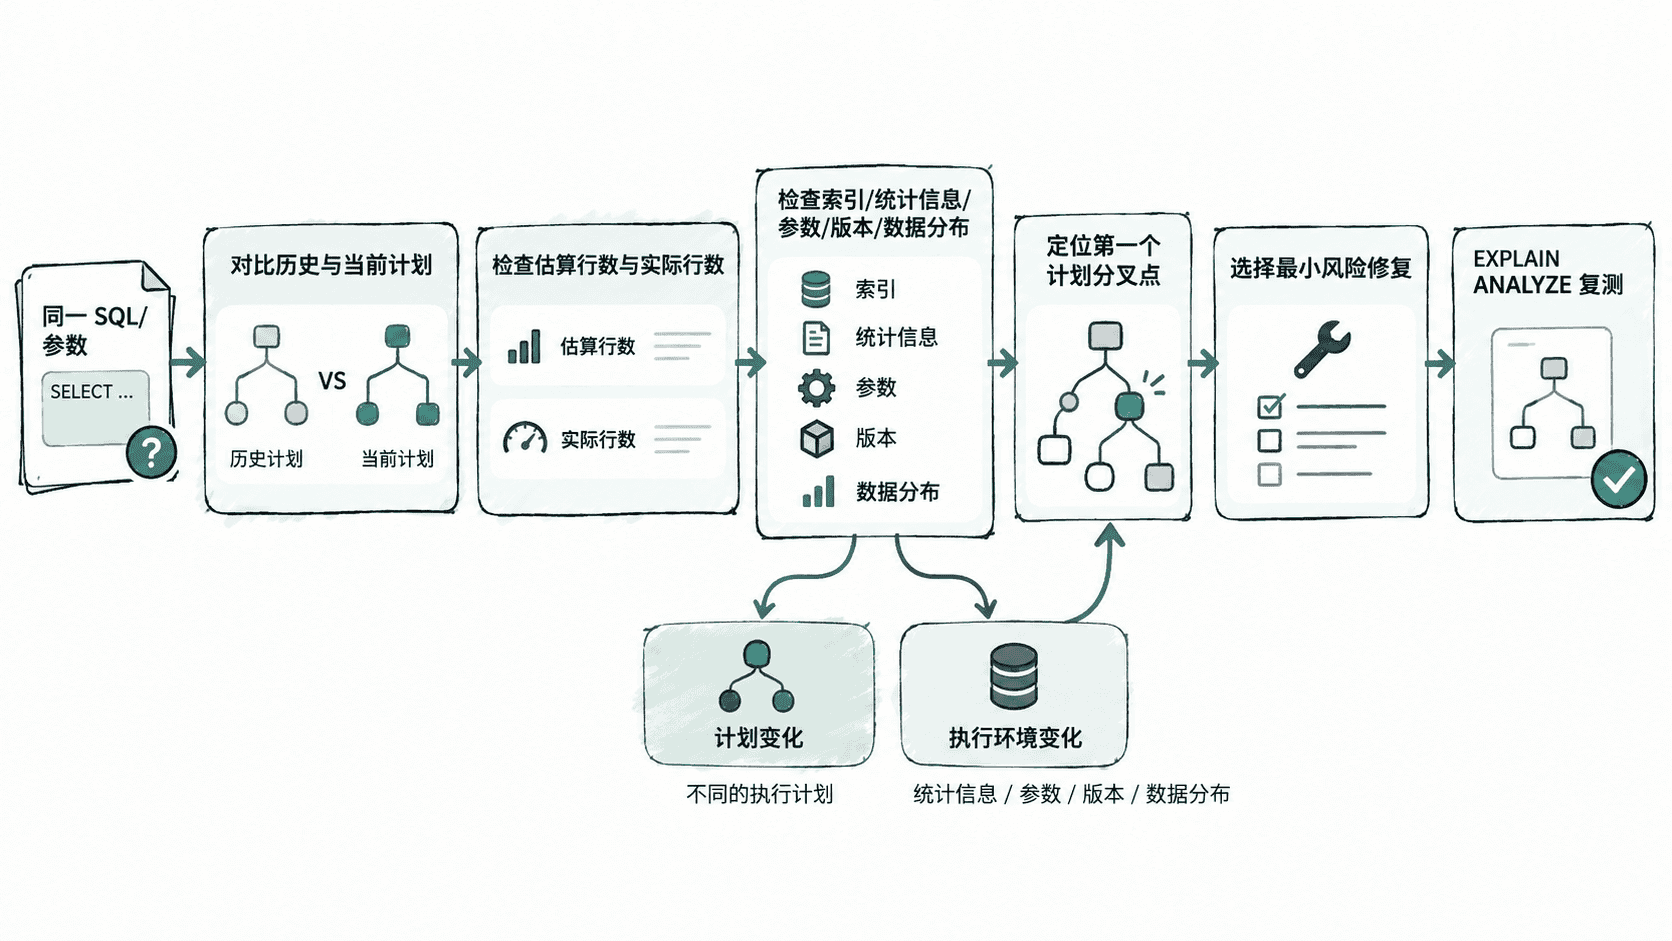
把计划差异和环境变化放到同一张证据表里
计划为什么会变,通常不是单一原因。相同 SQL 可能因为数据倾斜加剧、统计信息重新采样、索引新增或失效、optimizer_switch 改动、参数值变化,甚至版本升级后成本模型不同而选择另一条路径。
片段示例:下面的采集语句依赖当前会话有权读取相应系统信息,并假设目标表为 orders。把结果和“最后一次正常时”的同类快照对比。
SELECT
    @@version AS mysql_version,
    @@optimizer_switch AS optimizer_switch,
    @@sql_mode AS sql_mode,
    @@transaction_isolation AS tx_isolation;

SELECT
    table_name,
    last_update,
    n_rows
FROM mysql.innodb_table_stats
WHERE database_name = DATABASE()
  AND table_name = 'orders';

SHOW INDEX FROM orders;
预期结果
mysql_version / optimizer_switch / sql_mode / tx_isolation:返回当前会话与服务器相关值。
innodb_table_stats:返回 orders 的统计信息更新时间与估算行数,值记为 <TIME>、<VALUE>。
SHOW INDEX:返回当前索引、列顺序、可见性与基数估计,具体数值为 <VALUE>。
如果历史计划估算 100 行而当前实际返回数万行,优先怀疑统计信息或数据分布;如果估算仍准确但连接顺序改变,则继续检查索引、优化器开关、版本与 SQL 参数。不要把“计划不同”直接等同于“新计划错误”,因为数据规模变化后换计划可能反而是合理选择。
在必要时追到优化器的选择过程
当两个候选索引成本接近,单看 EXPLAIN 不容易解释“为什么它选了 A 没选 B”,可以在当前会话临时开启 Optimizer Trace。Trace 的作用是查看优化阶段考虑过的访问路径和成本,不是长期监控工具。
片段示例:仍依赖现有 orders 表。
SET optimizer_trace = 'enabled=on';

EXPLAIN
SELECT id, customer_id, total_amount, created_at
FROM orders
WHERE tenant_id = 42
  AND status = 'PAID'
  AND created_at >= '2026-08-01 00:00:00'
ORDER BY created_at DESC
LIMIT 50;

SELECT JSON_PRETTY(TRACE) AS trace
FROM INFORMATION_SCHEMA.OPTIMIZER_TRACE;

SET optimizer_trace = 'enabled=off';
预期结果
EXPLAIN:返回当前计划。
trace:返回 <JSON_TRACE>,可搜索候选访问路径、行数估算和成本比较。
最后一条 SET 成功后关闭当前会话的 optimizer trace。
Trace 很大时只围绕发生分叉的表和索引阅读,不要把整份 JSON 当日志逐行解释。最重要的问题始终是:哪个估算导致哪个候选路径成本发生反转。
选择最小风险的修复与回滚
如果根因是统计信息陈旧,先刷新统计信息再复测;如果是明显数据倾斜,可评估列直方图。若新建索引导致计划回退,可先把该二级索引设为不可见,观察优化器是否恢复旧路径,再决定是否删除。紧急止血时可以使用精确范围的 optimizer hint,但应把它当临时约束,而不是长期替代统计信息和索引设计。
ANALYZE TABLE orders;
ANALYZE TABLE orders
    UPDATE HISTOGRAM ON status
    WITH 64 BUCKETS;

ALTER TABLE orders
    ALTER INDEX idx_candidate INVISIBLE;

EXPLAIN
SELECT id, customer_id, total_amount, created_at
FROM orders
WHERE tenant_id = 42
  AND status = 'PAID'
  AND created_at >= '2026-08-01 00:00:00'
ORDER BY created_at DESC
LIMIT 50;
预期结果
ANALYZE TABLE:成功后刷新表与索引统计信息。
UPDATE HISTOGRAM:成功后更新 status 的列值分布统计。
ALTER INDEX ... INVISIBLE:成功后 idx_candidate 不再参与默认优化器选路。
最后的 EXPLAIN:应重新生成计划;是否恢复目标路径必须以实际输出为准。修复完成后必须用同一 SQL、同一参数、相近数据快照重新采集 EXPLAIN ANALYZE,并比较总耗时、扫描行数、关键算子的 rows 与 loops。只有计划恢复且实际工作量下降,才算关闭这次性能回退;否则应继续沿证据链定位,而不是叠加更多 hint。