
MySQL / 系统课时
为 ORDER BY 设计索引顺序
为 ORDER BY 设计索引顺序
这节课解决 ORDER BY + LIMIT 的索引设计:如何把等值过滤列和排序列排进联合索引,让 MySQL 按 B+Tree 顺序直接取前 N 行,尽量避免 filesort。以下以 MySQL 8.x InnoDB 为准。
学习目标
- 根据等值过滤前缀与排序列推导联合索引顺序
- 判断 ASC、DESC、混合方向与范围条件是否破坏索引排序
- 用
EXPLAIN验证计划中是否仍出现Using filesort
先把排序需求写成索引前缀
B+Tree 联合索引按键值从左到右排序。若查询先把若干前导列固定为单值,那么这些列相当于常量,后面的索引列仍能为结果提供连续有序的扫描路径。
例如订单列表固定租户和状态,再按创建时间与主键倒序分页:
WHERE tenant_id = 1 AND status = 'PAID' ORDER BY created_at DESC, id DESC LIMIT 3
可优先考虑索引 (tenant_id, status, created_at DESC, id DESC)。前两列负责缩小范围,后两列负责稳定排序;id 作为并列时间的第二排序键,可避免同一时间戳下分页顺序不稳定。
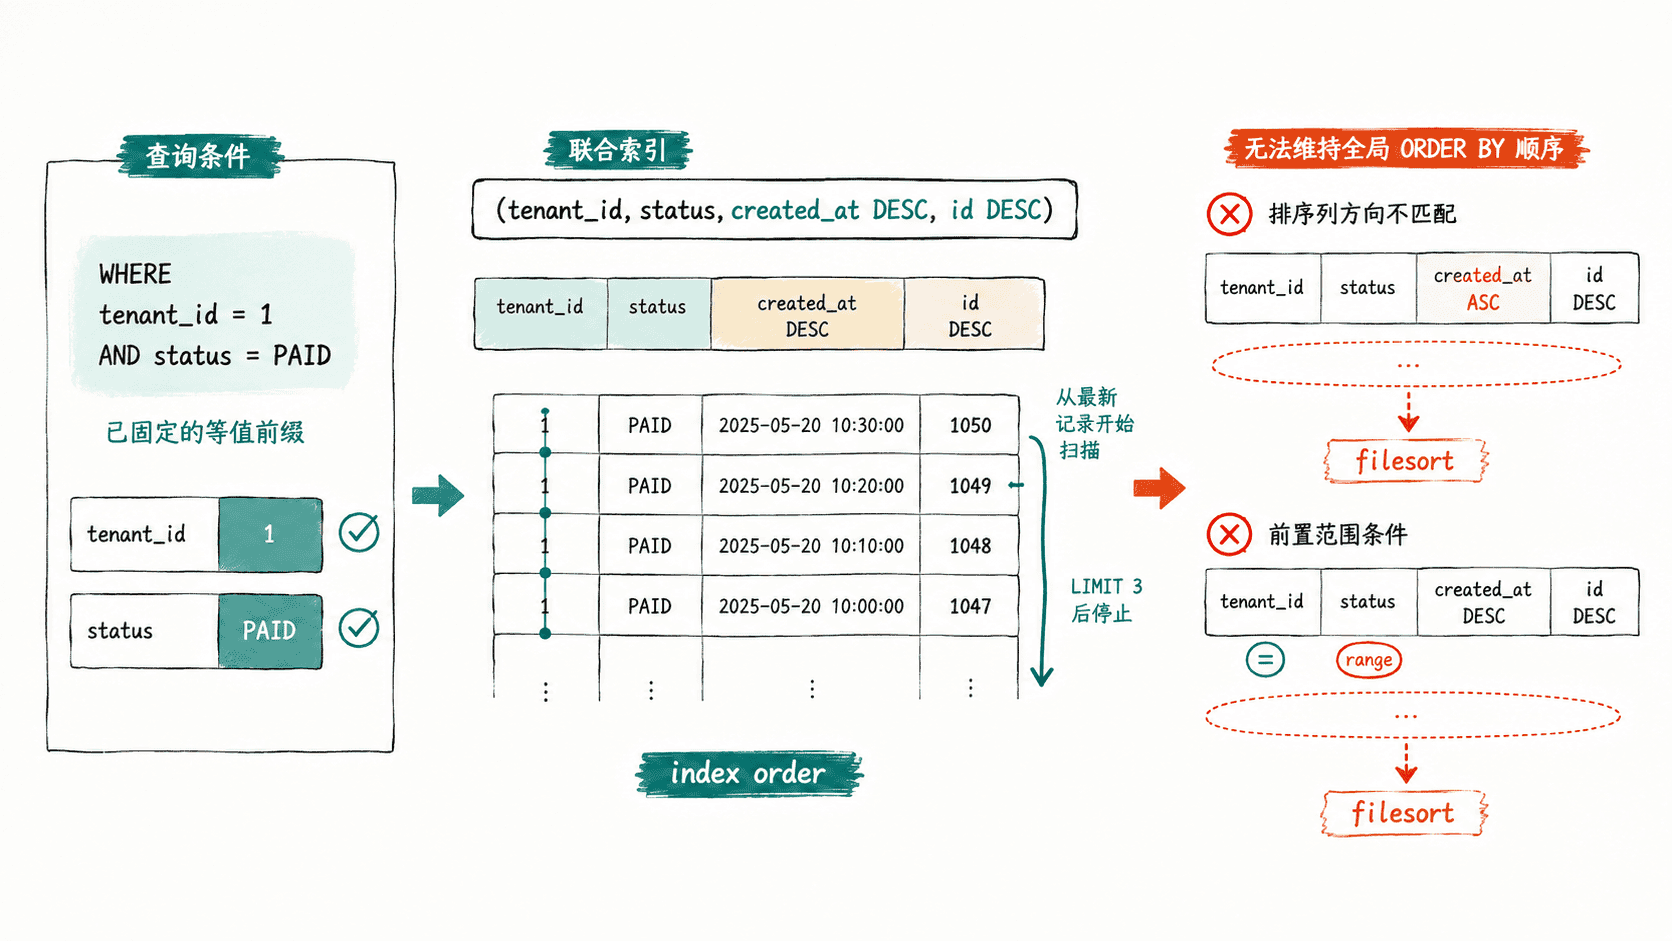
下面的 SQL 可直接建立一个最小实验:
DROP TABLE IF EXISTS order_feed;

CREATE TABLE order_feed (
  id BIGINT PRIMARY KEY,
  tenant_id BIGINT NOT NULL,
  status VARCHAR(16) NOT NULL,
  created_at DATETIME NOT NULL,
  amount DECIMAL(10,2) NOT NULL,
  KEY idx_tenant_status_created_id
    (tenant_id, status, created_at DESC, id DESC)
) ENGINE=InnoDB;

INSERT INTO order_feed
  (id, tenant_id, status, created_at, amount)
VALUES
  (101, 1, 'PAID', '2026-09-01 10:00:00', 100.00),
  (102, 1, 'PAID', '2026-09-01 10:05:00', 80.00),
  (103, 1, 'NEW',  '2026-09-01 10:06:00', 20.00),
  (104, 1, 'PAID', '2026-09-01 10:05:00', 120.00),
  (105, 2, 'PAID', '2026-09-01 10:07:00', 60.00);

SELECT id, created_at, amount
FROM order_feed
WHERE tenant_id = 1
  AND status = 'PAID'
ORDER BY created_at DESC, id DESC
LIMIT 3;
预期结果
id   created_at           amount
104  2026-09-01 10:05:00  120.00
102  2026-09-01 10:05:00   80.00
101  2026-09-01 10:00:00  100.00
判断方向与范围条件
排序方向要看整个索引扫描能否产生目标顺序,而不是机械地给每个 ORDER BY 列都声明 DESC。若排序列方向一致,MySQL 可以正向或反向扫描索引;真正需要重点设计的是混合方向,例如 created_at DESC, id ASC,它不能由 (created_at ASC, id ASC) 简单整体反扫得到。
| 查询形态 | 索引形态 | 能否直接提供目标顺序 | 关键原因 |
|---|---|---|---|
两列等值过滤后 ORDER BY created_at DESC, id DESC |
(tenant_id, status, created_at, id) |
通常可以 | 排序方向一致,可整体反向扫描 |
两列等值过滤后 ORDER BY created_at DESC, id ASC |
(tenant_id, status, created_at DESC, id ASC) |
可以作为匹配设计 | 混合方向需要与索引方向模式一致 |
tenant_id = ? AND created_at >= ? 后再 ORDER BY amount |
(tenant_id, created_at, amount) |
通常不可以 | created_at 是范围,多段 amount 顺序不能合并成一个全局顺序 |
tenant_id IN (...) 后按后续列排序 |
以 tenant_id 为首列 |
需看执行计划 | 前导键不再是单一常量,可能形成多个有序区间 |
用 EXPLAIN 验证是否省掉 filesort
索引设计只是候选方案,最终必须看优化器实际选择。对上面的查询执行:
EXPLAIN
SELECT id, created_at, amount
FROM order_feed
WHERE tenant_id = 1
  AND status = 'PAID'
ORDER BY created_at DESC, id DESC
LIMIT 3;
预期结果
关键检查项:
key 应优先为 idx_tenant_status_created_id
Extra 不应包含 Using filesort
rows、filtered 等估算值会随统计信息和数据规模变化
若 Extra 仍出现 Using filesort,先检查实际使用的 key,再核对排序列是否紧跟在可固定的索引前缀之后。不要仅为了消除 filesort 就强制索引;当过滤选择性差、回表成本高或待排序数据很少时,优化器选择其他访问路径可能更便宜。
把 LIMIT 当成收益放大器
LIMIT 本身不会让一个错误的索引突然满足排序,但当索引已经能同时完成定位与排序时,它允许执行器在得到足够结果后尽早停止扫描。对于“最新 20 条订单”“最高 50 个分数”这类 Top-N 查询,这通常比先收集大量候选行再排序更有价值。
如果还有未进入索引的残余过滤条件,执行器可能需要扫描超过 N 个索引项才能得到 N 行结果。因此最终要同时观察扫描行数、回表次数和 Using filesort,而不是只盯着一个 Extra 标记。