
MySQL / 系统课时
判断访问类型与扫描范围
判断访问类型与扫描范围
本节不背“type 从好到坏”的顺序,而是把 const、ref、range、index、ALL 翻译成实际扫描范围,并结合 key、key_len、rows 判断计划是否真的合理。
学习目标
- 能解释
const、ref、range、index、ALL对应的访问方式 - 会结合
key、key_len、rows与过滤条件判断实际扫描范围 - 能区分“访问类型看起来不错”和“扫描量真的合理”
用一张表复现五种访问方式
下面的表包含主键、客户状态复合索引和时间索引。示例中的 FORCE INDEX、IGNORE INDEX 只用于稳定复现访问类型;分析真实业务 SQL 时,不要先强制索引。
CREATE TABLE orders_plan_demo (
  id BIGINT PRIMARY KEY,
  customer_id BIGINT NOT NULL,
  status VARCHAR(16) NOT NULL,
  created_at DATETIME NOT NULL,
  amount DECIMAL(10,2) NOT NULL,
  KEY idx_customer_status (customer_id, status),
  KEY idx_created_at (created_at)
);

INSERT INTO orders_plan_demo VALUES
  (101, 42, 'PAID', '2026-08-01 10:00:00', 120.00),
  (102, 42, 'PAID', '2026-08-02 11:00:00', 80.00),
  (103, 42, 'PENDING', '2026-08-03 12:00:00', 200.00),
  (104, 7, 'PAID', '2026-08-04 13:00:00', 60.00),
  (105, 8, 'PAID', '2026-08-05 14:00:00', 300.00);
预期结果:
表创建成功并写入 5 行;执行耗时会因环境不同而变化。五种访问类型对应什么扫描范围
下面一次查看五条计划。const 通常表示通过主键或唯一索引等值定位到单行;ref 通常表示通过非唯一索引等值匹配一组记录;range 表示扫描一个或多个索引区间;index 表示完整索引扫描;ALL 表示完整表扫描。
EXPLAIN SELECT * FROM orders_plan_demo WHERE id = 101;

EXPLAIN SELECT *
FROM orders_plan_demo FORCE INDEX (idx_customer_status)
WHERE customer_id = 42;

EXPLAIN SELECT *
FROM orders_plan_demo FORCE INDEX (idx_created_at)
WHERE created_at >= '2026-08-01'
  AND created_at < '2026-09-01';

EXPLAIN SELECT customer_id, status
FROM orders_plan_demo FORCE INDEX (idx_customer_status)
ORDER BY customer_id, status;

EXPLAIN SELECT *
FROM orders_plan_demo IGNORE INDEX (idx_customer_status, idx_created_at)
WHERE amount > 100;
预期结果:
关键 type 依次通常应接近:
const
ref
range
index
ALL

rows 等估算值会受表规模、数据分布和统计信息影响,不应照抄固定数字。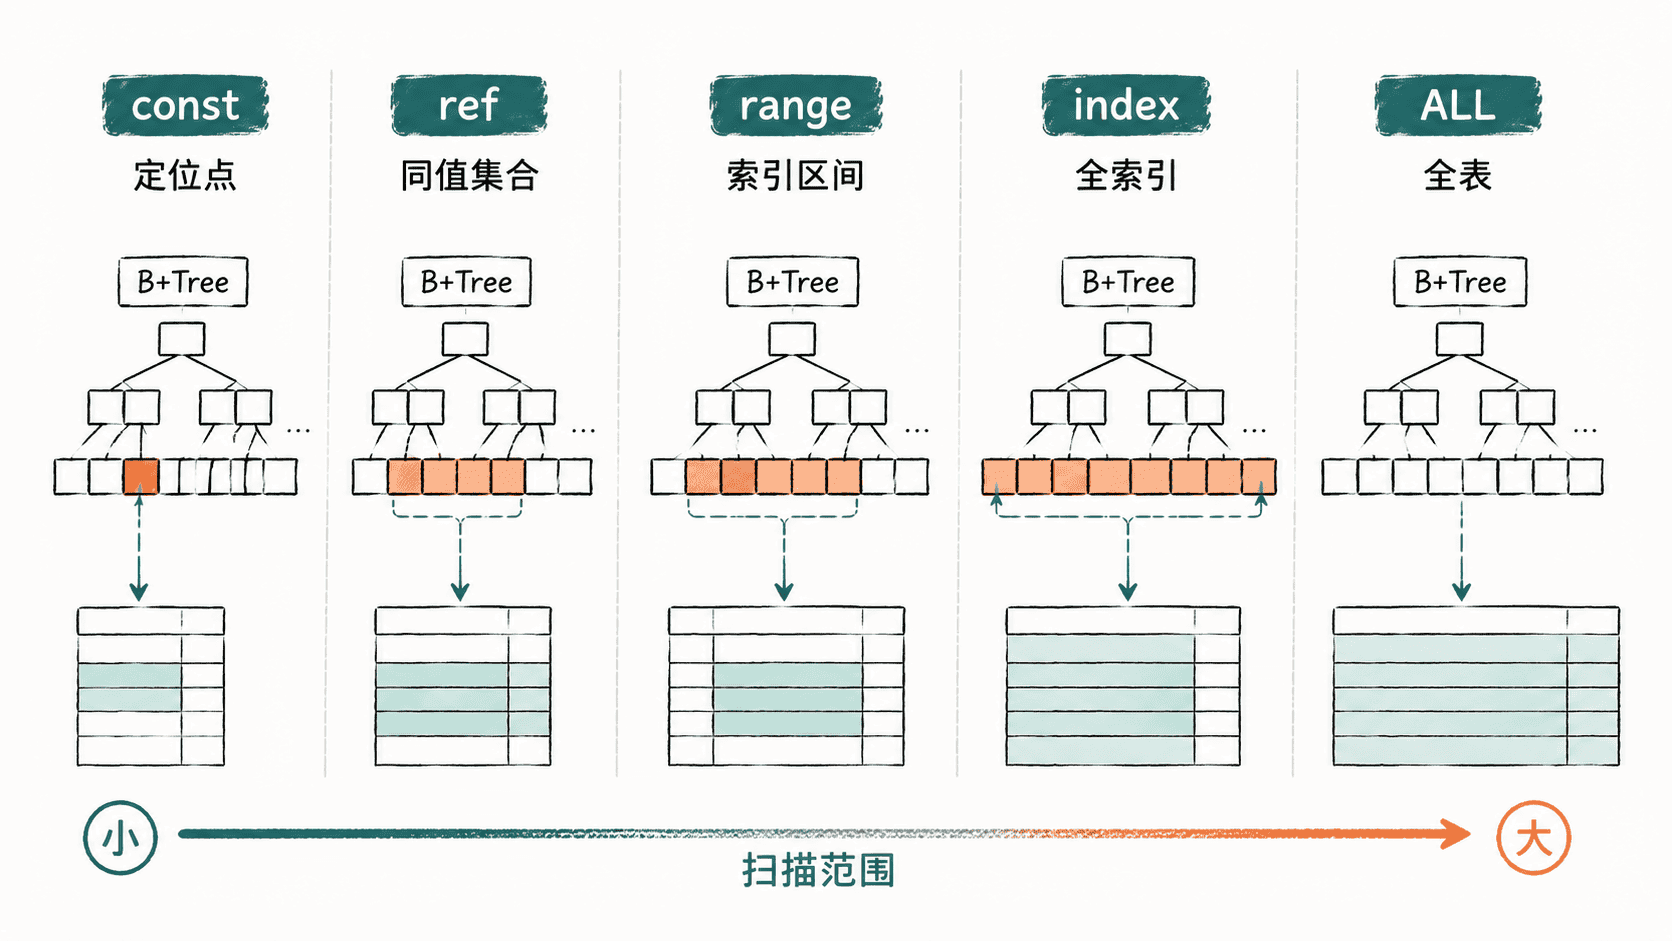
这里有两个容易误判的点。第一,index 不是“用了索引所以很好”,它可能只是把整棵二级索引从头扫到尾;第二,range 也不天然便宜,如果范围覆盖了大部分数据,实际工作量仍然可能很大。
把 type 和其他列一起看
传统 EXPLAIN 至少要把下面几列放在一起判断:
type:访问方式,只说明“怎么找”,不直接说明“找了多少”。key:优化器最终选择的索引;possible_keys只是候选索引。key_len:实际用于查找的索引键长度,可辅助判断复合索引使用了多长前缀。ref:等值查找时,索引列拿什么值进行匹配。rows:预计扫描的行数或索引记录数,是估算值而不是实测值。filtered:预计经过剩余条件后保留下来的百分比。
例如下面两条查询都可能是 range,但扫描范围完全不同:
EXPLAIN SELECT *
FROM orders_plan_demo FORCE INDEX (idx_created_at)
WHERE created_at >= '2026-08-04'
  AND created_at < '2026-08-05';

EXPLAIN SELECT *
FROM orders_plan_demo FORCE INDEX (idx_created_at)
WHERE created_at >= '2020-01-01'
  AND created_at < '2030-01-01';
预期结果:
两条计划的 type 都可能是 range。
第一条只覆盖较窄时间区间;第二条覆盖几乎整张示例表,rows 估算通常更大。
所以不要停在“它是 range,所以没问题”。真正要问的是:索引边界切出了多大的区间,预计扫描量是否符合业务选择性。
从条件反推扫描范围
判断扫描范围时,可以按下面的顺序检查:
- 先看等值条件是否命中主键或唯一索引;能唯一定位时,常见为
const。 - 再看非唯一索引的等值前缀;匹配一组同值记录时,常见为
ref。 - 出现
<、>、BETWEEN或多个离散区间时,通常进入range。 - 没有可用于缩小范围的条件,却顺序读取整棵索引时,常见为
index。 - 如果没有采用索引访问,需要逐行读取整张表,则为
ALL。
复合索引还要结合最左前缀判断。以 idx_customer_status(customer_id, status) 为例,只有 status = 'PAID' 而没有 customer_id 条件时,通常不能像 customer_id = 42 AND status = 'PAID' 那样直接缩小同一索引前缀的扫描范围。
什么时候 ALL 也可能合理
ALL 是风险信号,不是自动判错。表非常小、查询本来就需要返回大部分数据,或者回表成本高于顺序扫描时,优化器选择全表扫描可能是合理的。反过来,ref 也可能扫描几十万条同值记录。
判断计划是否健康,最终应把访问类型与业务选择性放在一起看:扫描范围是否与需要返回的数据规模相匹配。这比单纯追求更“漂亮”的 type 更接近索引优化的真实目标。