
MySQL / 系统课时
为 GROUP BY 与去重设计索引
为 GROUP BY 与去重设计索引
这节课解决 GROUP BY 与 DISTINCT 的索引设计:利用 B+Tree 有序键值让相同分组键尽量连续出现,减少临时表、额外排序或重复扫描,并判断过滤前缀与聚合方式是否仍允许索引优化。
学习目标
- 判断
GROUP BY、DISTINCT是否匹配联合索引的左侧顺序 - 区分 Loose Index Scan 与 Tight Index Scan 的适用边界
- 用
EXPLAIN检查Using temporary、Using filesort与Using index for group-by
把分组和去重看成有序键扫描
对 B+Tree 来说,若相同分组键在索引中连续排列,MySQL 可以边扫描边识别分组边界,而不必先把所有候选行写入临时结构再重新组织。DISTINCT 也可以按同样思路理解:只保留每个键组合的一份结果。
但要注意,GROUP BY 只定义分组语义,不承诺最终输出顺序。业务需要稳定排序时仍应显式写 ORDER BY,不要依赖某次执行恰好按索引顺序返回。
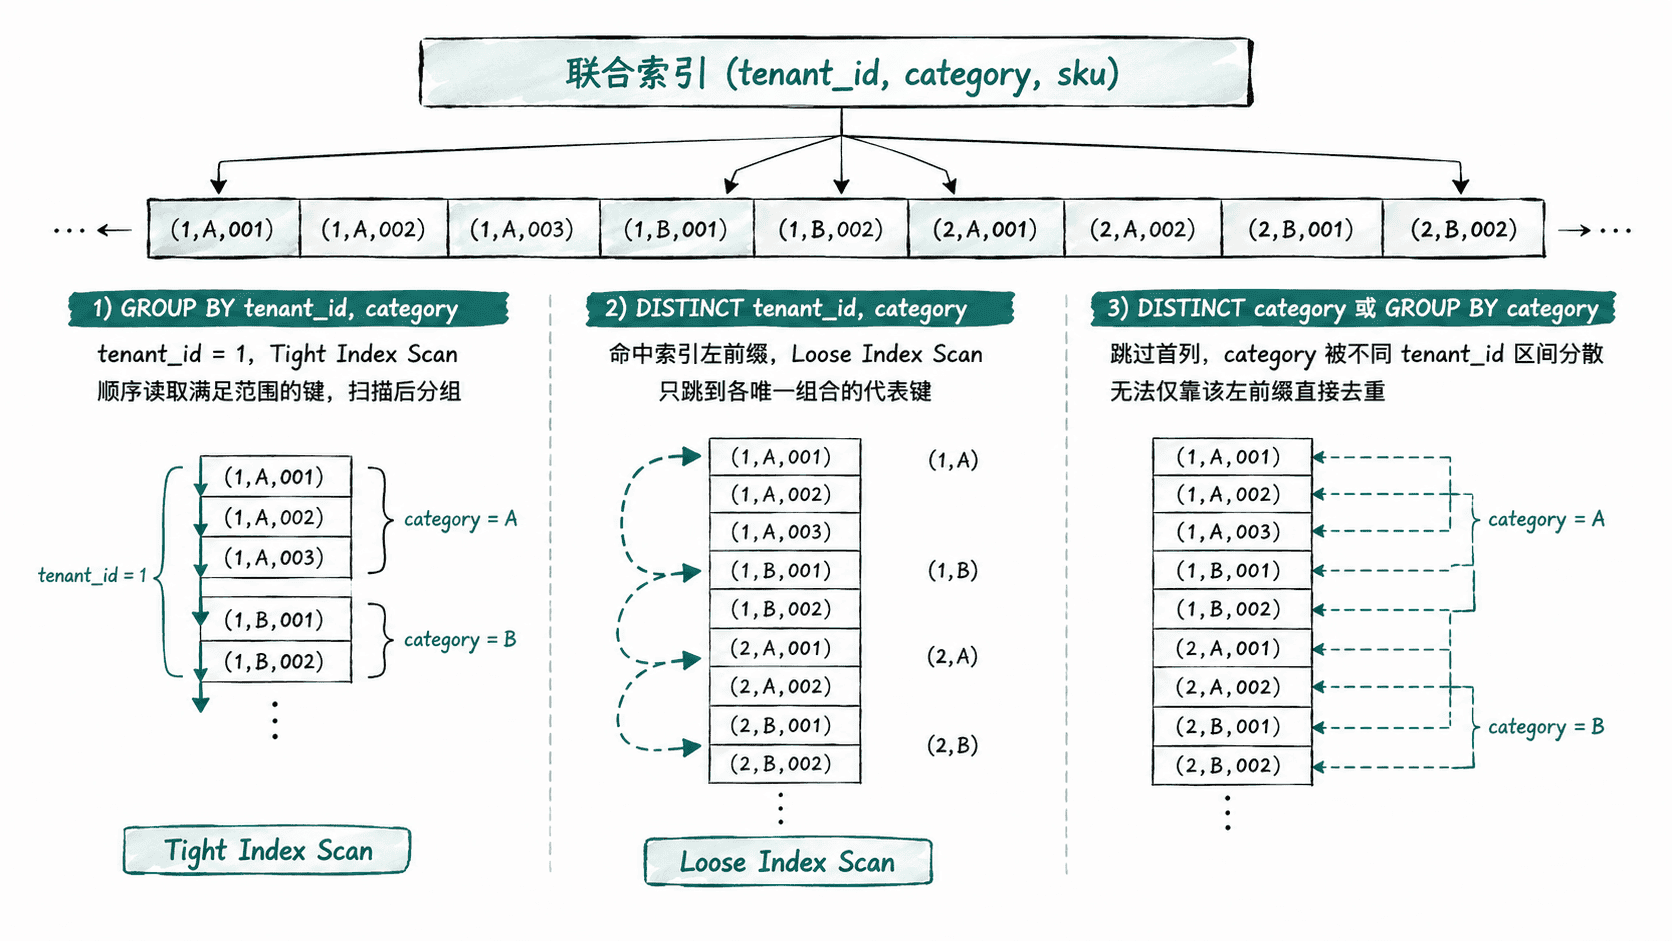
先检查左前缀与等值过滤
假设已有索引 (tenant_id, category, sku),可以先按下面的方式判断:
| 查询形态 | 索引利用判断 |
|---|---|
WHERE tenant_id = 1 GROUP BY category, sku |
前导 tenant_id 被常量固定,可形成连续索引前缀,适合 Tight Index Scan 候选 |
GROUP BY tenant_id, category |
分组列就是索引左前缀,是 Loose Index Scan 的典型候选 |
DISTINCT tenant_id, category |
去重列是索引左前缀,可利用有序键跳过重复组合 |
GROUP BY category, sku 且无 tenant_id 条件 |
跳过首列,不能仅凭该索引左前缀直接完成分组 |
DISTINCT category 且无 tenant_id 条件 |
相同 category 可能散落在多个租户区间,不能按相邻键直接去重 |
这里最容易误判的是“过滤列一定要放在 GROUP BY 前面”。只有当这些前导列被等值条件固定为常量时,后续分组键才能保持一个连续、可利用的顺序;若前导列是范围或多值条件,就要重新验证执行计划。
用最小数据验证分组与去重
下面建立一张销售明细表,并让 (tenant_id, category, sku) 同时承担过滤、分组和去重的顺序基础:
DROP TABLE IF EXISTS sales_items;

CREATE TABLE sales_items (
  id BIGINT PRIMARY KEY,
  tenant_id BIGINT NOT NULL,
  category VARCHAR(20) NOT NULL,
  sku VARCHAR(20) NOT NULL,
  amount DECIMAL(10,2) NOT NULL,
  KEY idx_tenant_category_sku (tenant_id, category, sku)
) ENGINE=InnoDB;

INSERT INTO sales_items
  (id, tenant_id, category, sku, amount)
VALUES
  (1, 1, 'book', 'A', 100.00),
  (2, 1, 'book', 'A', 120.00),
  (3, 1, 'book', 'B', 90.00),
  (4, 1, 'game', 'C', 200.00),
  (5, 2, 'book', 'A', 50.00);

SELECT category, sku, COUNT(*) AS cnt
FROM sales_items
WHERE tenant_id = 1
GROUP BY category, sku
ORDER BY category, sku;

SELECT DISTINCT tenant_id, category
FROM sales_items
ORDER BY tenant_id, category;
预期结果
第一条查询:
category  sku  cnt
book      A    2
book      B    1
game      C    1

第二条查询:
tenant_id  category
1          book
1          game
2          book
用 EXPLAIN 区分扫描方式
继续检查两个查询的计划:
EXPLAIN
SELECT category, sku, COUNT(*) AS cnt
FROM sales_items
WHERE tenant_id = 1
GROUP BY category, sku
ORDER BY category, sku;

EXPLAIN
SELECT DISTINCT tenant_id, category
FROM sales_items;
预期结果
重点观察:
1. key 是否选择 idx_tenant_category_sku
2. GROUP BY 计划若利用有序索引完成分组,通常不需要 Using temporary;排序同样被索引顺序满足时也不需要 Using filesort
3. DISTINCT 若采用 Loose Index Scan,Extra 会出现 Using index for group-by
4. 小样本下优化器可能因成本选择其他计划,rows 等估算值也会变化
Using index for group-by 是 Loose Index Scan 的强信号,但没有这个标记不代表索引完全没价值。Tight Index Scan 会读取满足范围的全部索引键,再利用其有序性完成分组;它通常比 Loose Index Scan 读得更多,却仍可能省掉临时表或额外排序。
聚合函数会改变可用优化
Loose Index Scan 的条件更严格:单表查询、分组列匹配索引左前缀,并且常见聚合场景主要适合紧跟分组键之后的 MIN() 或 MAX()。普通 COUNT(*)、SUM() 等聚合通常需要读取组内更多键,因此更常见的是 Tight Index Scan 或其他执行方式。
例如索引 (category, created_at) 对 GROUP BY category 配合 MIN(created_at) 很友好,因为每组最小值位于该组有序区间的边界;但若要计算每组总销售额,索引顺序并不能免除读取并累加组内记录。
为分组或去重增加宽联合索引前,还要计算写入维护成本与索引体积。只有高频查询确实能借助该顺序显著减少扫描或中间结果时,这个索引才值得长期保留。