
MySQL / 系统课时
完成端到端查询优化演练
完成端到端查询优化演练
这次演练把慢查询优化串成一条可执行链路:先准备稳定数据并采集基线,再用 EXPLAIN ANALYZE 找到扫描、过滤和排序浪费,随后改写条件并建立联合索引,最后用统一指标复测并记录风险与回滚方式。
学习目标
- 独立完成慢查询的基线采集、计划分析、索引设计与查询改写
- 用
EXPLAIN ANALYZE对比优化前后的实际行数、排序和耗时 - 把证据、变更、收益、风险和回滚方式整理成可复用的优化结论
建立可复现的慢查询实验
下面创建 10 万行订单数据。初始只有 tenant_id 单列索引,原查询还对 created_at 使用 DATE(),因此普通索引不能直接利用原日期表达式形成范围边界;查询同时要求按时间倒序取前 50 行。
DROP DATABASE IF EXISTS query_opt_lab;
CREATE DATABASE query_opt_lab;
USE query_opt_lab;

CREATE TABLE digits (
    n TINYINT PRIMARY KEY
);

INSERT INTO digits (n)
VALUES (0),(1),(2),(3),(4),(5),(6),(7),(8),(9);

CREATE TABLE orders (
    id BIGINT PRIMARY KEY,
    tenant_id INT NOT NULL,
    status ENUM('PAID','NEW','CANCELLED') NOT NULL,
    customer_id BIGINT NOT NULL,
    created_at DATETIME NOT NULL,
    total_amount DECIMAL(10,2) NOT NULL,
    KEY idx_tenant (tenant_id)
) ENGINE=InnoDB;

INSERT INTO orders (id, tenant_id, status, customer_id, created_at, total_amount)
SELECT
    seq + 1,
    MOD(seq, 20) + 1,
    CASE
        WHEN MOD(FLOOR(seq / 20), 10) < 7 THEN 'PAID'
        WHEN MOD(FLOOR(seq / 20), 10) < 9 THEN 'NEW'
        ELSE 'CANCELLED'
    END,
    MOD(seq, 10000) + 1,
    TIMESTAMP('2025-01-01 00:00:00') + INTERVAL seq MINUTE,
    ROUND((MOD(seq, 50000) + 100) / 100, 2)
FROM (
    SELECT d0.n + d1.n * 10 + d2.n * 100 + d3.n * 1000 + d4.n * 10000 AS seq
    FROM digits d0
    CROSS JOIN digits d1
    CROSS JOIN digits d2
    CROSS JOIN digits d3
    CROSS JOIN digits d4
) AS numbers;

ANALYZE TABLE orders;

SELECT COUNT(*) AS row_count,
       MIN(created_at) AS min_created_at,
       MAX(created_at) AS max_created_at
FROM orders;
预期结果
row_count  min_created_at       max_created_at
100000     2025-01-01 00:00:00   2025-03-11 10:39:00
这里的数据边界由生成规则决定;机器快慢只会影响执行耗时,不会改变行数和时间范围。
采集基线并定位浪费
先执行未经优化的查询。EXPLAIN ANALYZE 会展示实际执行时间、实际行数和循环次数。重点不是背计划文本,而是确认读取了多少候选行、过滤后剩多少,以及排序是否产生额外工作。
EXPLAIN ANALYZE
SELECT id, customer_id, total_amount, created_at
FROM orders
WHERE tenant_id = 7
  AND status = 'PAID'
  AND DATE(created_at) >= '2025-03-01'
ORDER BY created_at DESC
LIMIT 50;
预期结果
返回 TREE 执行计划,并包含 actual time=<VALUE>..<VALUE>、rows=<VALUE>、loops=<VALUE> 等信息。
实际访问路径和耗时会因 MySQL 8.x 版本、统计信息、缓存与机器性能而不同。
先把基线记下来,再做任何变更。单看总耗时容易受缓存和并发影响;扫描行数、过滤后行数、排序工作和 loops 更适合解释性能变化。
这条 SQL 的主要浪费有两个:现有索引只能先定位 tenant_id,之后仍需过滤 status 与日期;DATE(created_at) 把索引列包在函数中,使普通索引不能直接把原条件转化为 created_at 的范围边界。
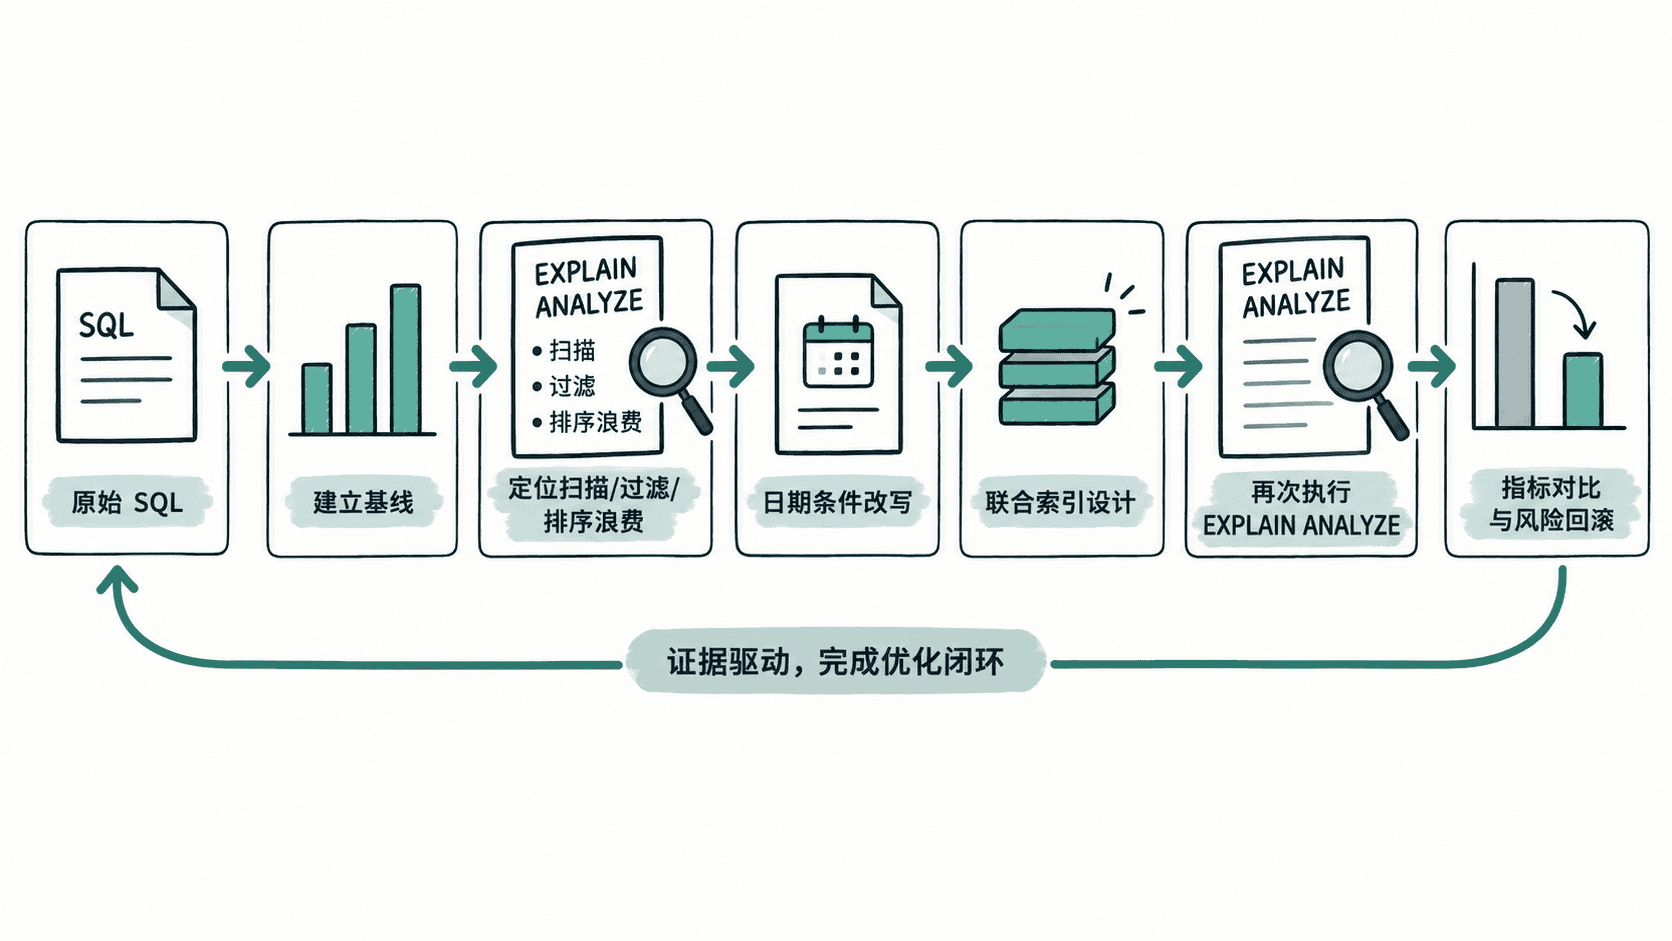
让查询条件与索引顺序对齐
先把日期条件改写成对原始列的范围比较,再创建 (tenant_id, status, created_at DESC) 联合索引。这里前两列承接等值条件,created_at 承接时间范围并尽量匹配倒序取数的访问顺序。
CREATE INDEX idx_tenant_status_created
ON orders (tenant_id, status, created_at DESC);

ANALYZE TABLE orders;

EXPLAIN ANALYZE
SELECT id, customer_id, total_amount, created_at
FROM orders
WHERE tenant_id = 7
  AND status = 'PAID'
  AND created_at >= '2025-03-01 00:00:00'
ORDER BY created_at DESC
LIMIT 50;
预期结果
CREATE INDEX:索引创建成功。
ANALYZE TABLE:统计信息刷新成功。
新的 TREE 计划应以 idx_tenant_status_created 为候选访问路径,并利用 tenant_id、status 与 created_at 条件缩小访问范围。
是否完全消除排序、实际 rows 与 loops 以及耗时,以实际执行计划为准,记录为 <VALUE>。
这里的改写不是单纯“把 SQL 写漂亮”,而是把等价的日期判断转换成更适合 B+Tree 范围访问的条件。对于非空 DATETIME,且业务确实按数据库会话日期语义解释该条件时,DATE(created_at) >= '2025-03-01' 可改写为 created_at >= '2025-03-01 00:00:00';若业务涉及显式时区转换、日期边界或字符串隐式转换,必须先确认语义,否则可能优化了执行路径却改变了结果。
用统一口径比较前后收益
把两次 EXPLAIN ANALYZE 的关键数据放在同一张表中,避免只写“从 800 ms 降到 50 ms”而没有证据。
| 指标 | 优化前 | 优化后 | 判断 |
|---|---|---|---|
| 总体 actual time | <BEFORE_TIME> |
<AFTER_TIME> |
越低越好,但应多次复测 |
| 关键访问节点 actual rows | <BEFORE_ROWS> |
<AFTER_ROWS> |
是否减少无效扫描 |
| loops | <BEFORE_LOOPS> |
<AFTER_LOOPS> |
是否避免循环放大 |
| 独立排序 | <BEFORE_SORT> |
<AFTER_SORT> |
是否由索引访问顺序减少排序工作 |
| 使用索引 | idx_tenant 或实际结果 |
idx_tenant_status_created 或实际结果 |
以真实计划为准 |
优化报告至少写清四件事:固定参数下的原 SQL、基线证据、具体变更和复测结果。随后补充风险与回滚:新索引会增加存储与写入维护成本;若收益不足,可以先将新索引设为不可见,观察优化器行为,再决定是否保留。
ALTER TABLE orders
ALTER INDEX idx_tenant_status_created INVISIBLE;
预期结果
Query OK, <VALUE> rows affected设为 INVISIBLE 后,优化器默认不会把该索引作为普通可见索引参与计划选择,但索引本身仍然存在,因此适合用于低风险验证。重新测试时仍应使用相同查询和参数,并与基线保持一致。
验收优化是否真正闭环
最终验收需要同时满足三个条件:结果集与原查询语义一致;扫描、排序或循环工作量确实下降;在相同参数和相近数据条件下重复执行仍然稳定。对于高频接口,还应补充一个常见参数和一个极端参数,避免只针对单一样本优化后引入新的计划回归。
完成验证后可以保留 query_opt_lab 继续做实验;清理环境时执行:
DROP DATABASE query_opt_lab;预期结果
Query OK,数据库 query_opt_lab 删除成功;具体 rows affected 可能因 MySQL 版本与对象元数据不同而不同。一次完整的查询优化交付,最终应能用执行计划和复测指标回答“为什么慢、改了什么、为什么会快、证据是什么、如何回滚”。这五个问题都能被验证,才算真正完成了端到端优化闭环。