
MySQL / 系统课时
读懂多表 JOIN 的驱动顺序
读懂多表 JOIN 的驱动顺序
多表 JOIN 的关键不是“先写哪张表”,而是优化器最终让哪张表先产出行、后续表又被探测多少次。本课用可运行的三表查询读懂 JOIN order,并把表规模、过滤率和索引组合成一个可估算的成本模型。
学习目标
- 从
EXPLAIN FORMAT=TREE识别多表 JOIN 的实际驱动顺序 - 用过滤后行数和单次探测成本估算不同顺序的放大效应
- 判断什么时候应通过索引、过滤条件或统计信息改善驱动表选择
驱动顺序决定循环规模
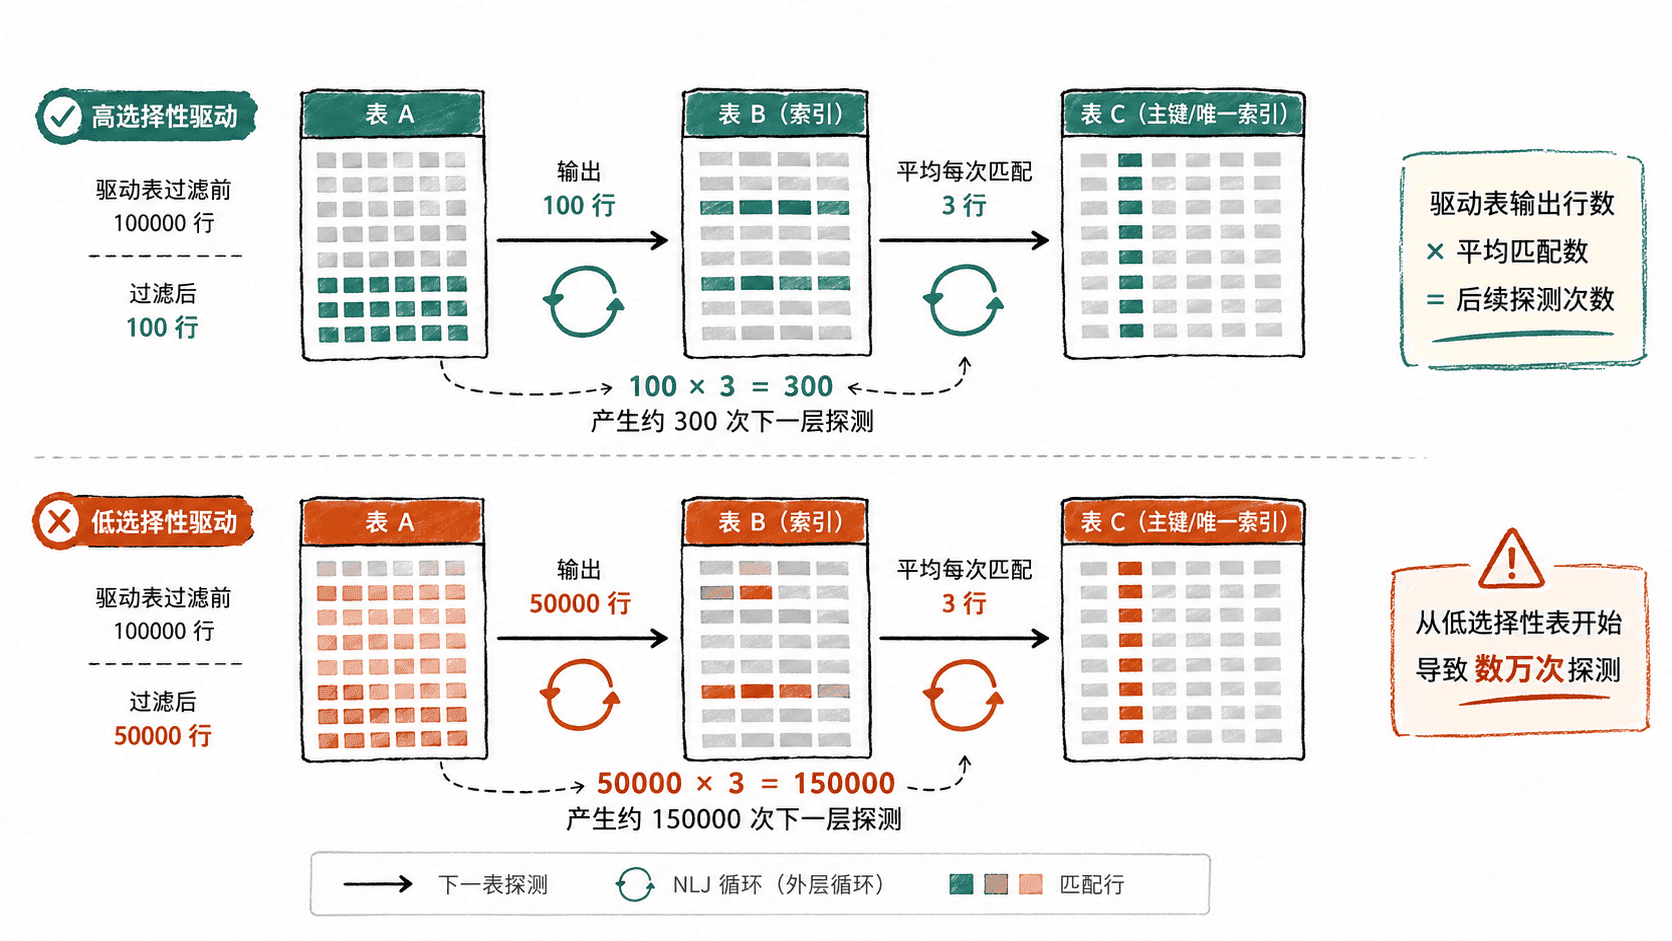
在典型 Nested Loop 执行中,第一张被访问的表是驱动端。它每输出一行,执行器都会继续访问下一层;如果第二层又匹配多行,第三层的探测次数会继续被放大。粗略估算可写成:下一层探测次数 ≈ 上一层输出行数 × 平均匹配行数。
因此,不能只看原始表有多少行。更重要的是经过过滤后还能留下多少行,以及这些行访问下一张表时能否使用高选择性的索引。一个百万行表如果能先通过唯一条件缩到 1 行,反而可能是理想驱动表。
用一条三表查询观察计划
下面创建客户、订单和订单明细三张表。查询只找一个活跃客户最近状态为 PAID 的订单明细;customers.email 是唯一索引,orders(customer_id, status) 和 order_items.order_id 都可用于后续查找。
DROP TABLE IF EXISTS order_items;
DROP TABLE IF EXISTS orders;
DROP TABLE IF EXISTS customers;

CREATE TABLE customers (
  id BIGINT PRIMARY KEY,
  email VARCHAR(100) NOT NULL,
  active TINYINT NOT NULL,
  UNIQUE KEY uk_customers_email (email)
);

CREATE TABLE orders (
  id BIGINT PRIMARY KEY,
  customer_id BIGINT NOT NULL,
  status VARCHAR(20) NOT NULL,
  KEY idx_orders_customer_status (customer_id, status)
);

CREATE TABLE order_items (
  id BIGINT PRIMARY KEY,
  order_id BIGINT NOT NULL,
  sku VARCHAR(50) NOT NULL,
  KEY idx_items_order (order_id)
);

INSERT INTO customers VALUES
(1, 'a@example.com', 1),
(2, 'b@example.com', 1);

INSERT INTO orders VALUES
(101, 1, 'PAID'),
(102, 1, 'NEW'),
(103, 2, 'PAID');

INSERT INTO order_items VALUES
(1001, 101, 'SKU-A'),
(1002, 101, 'SKU-B'),
(1003, 103, 'SKU-C');

EXPLAIN FORMAT=TREE
SELECT oi.sku
FROM customers AS c
JOIN orders AS o
  ON o.customer_id = c.id
JOIN order_items AS oi
  ON oi.order_id = o.id
WHERE c.email = 'a@example.com'
  AND c.active = 1
  AND o.status = 'PAID';
预期输出中应出现三层访问关系:先通过 uk_customers_email 定位 customers,再用 idx_orders_customer_status 查 orders,最后用 idx_items_order 查 order_items。不同 MySQL 8.0 小版本的文字和成本数字可能不同。
-> Nested loop inner join
    -> Nested loop inner join
        -> Filter: (c.active = 1)
            -> Index lookup on c using uk_customers_email (email='a@example.com')
        -> Index lookup on o using idx_orders_customer_status (customer_id=c.id, status='PAID')
    -> Index lookup on oi using idx_items_order (order_id=o.id)
把表规模换成过滤后行数
假设三张表原始规模分别是客户 100 万、订单 5000 万、明细 2 亿。若 email 唯一条件把客户先缩到 1 行,那么后续只需探测这个客户的订单,再探测这些订单的明细。此时“客户很大”并不重要,因为真正进入 JOIN 循环的是 1 行。
反过来,如果先从 orders.status='PAID' 开始,而 PAID 占全部订单的 70%,驱动端可能先产生数千万行。即使后面每次客户查找都是主键命中,总探测次数仍会非常大。判断顺序时应同时看估算行数 rows、过滤比例 filtered、索引访问方式和每层实际输出。
发现顺序不理想时怎么改
优先修正能改变成本估算或单次探测成本的因素,而不是一上来强制 JOIN 顺序。常见动作是给高频连接键补合适索引、让高选择性过滤尽早可用,并通过 ANALYZE TABLE 刷新统计信息。
ANALYZE TABLE customers, orders, order_items;

EXPLAIN FORMAT=TREE
SELECT oi.sku
FROM customers AS c
JOIN orders AS o
  ON o.customer_id = c.id
JOIN order_items AS oi
  ON oi.order_id = o.id
WHERE c.email = 'a@example.com'
  AND c.active = 1
  AND o.status = 'PAID';
预期结果是三张表的统计信息被更新,随后再次查看计划;若数据分布和索引与示例一致,驱动顺序仍应从高选择性的 customers.email 查找开始。
Table        Op       Msg_type  Msg_text
customers    analyze  status    OK
orders       analyze  status    OK
order_items  analyze  status    OK
只有在你确认统计信息可靠、索引设计合理,而优化器仍持续选择明显更差的顺序时,才考虑 STRAIGHT_JOIN 这类强制手段。强制顺序会把当前数据分布假设写死在 SQL 中,数据规模变化后可能从“修复”变成新的性能问题。