
MySQL / 系统课时
刷新表与索引统计信息
刷新表与索引统计信息
当数据量或分布发生明显变化时,索引本身可能没有问题,真正过期的是优化器对“会命中多少行”的估计。本课说明 InnoDB 持久化统计信息与 ANALYZE TABLE 的关系,并给出什么时候刷新、刷新后怎样验证查询计划的最短流程。
学习目标
- 理解表与索引统计信息如何影响基数、选择性和访问路径判断
- 能判断批量数据变化后是否需要执行
ANALYZE TABLE - 能用执行计划验证刷新前后的估算和索引选择是否改善
统计信息决定优化器的成本估算
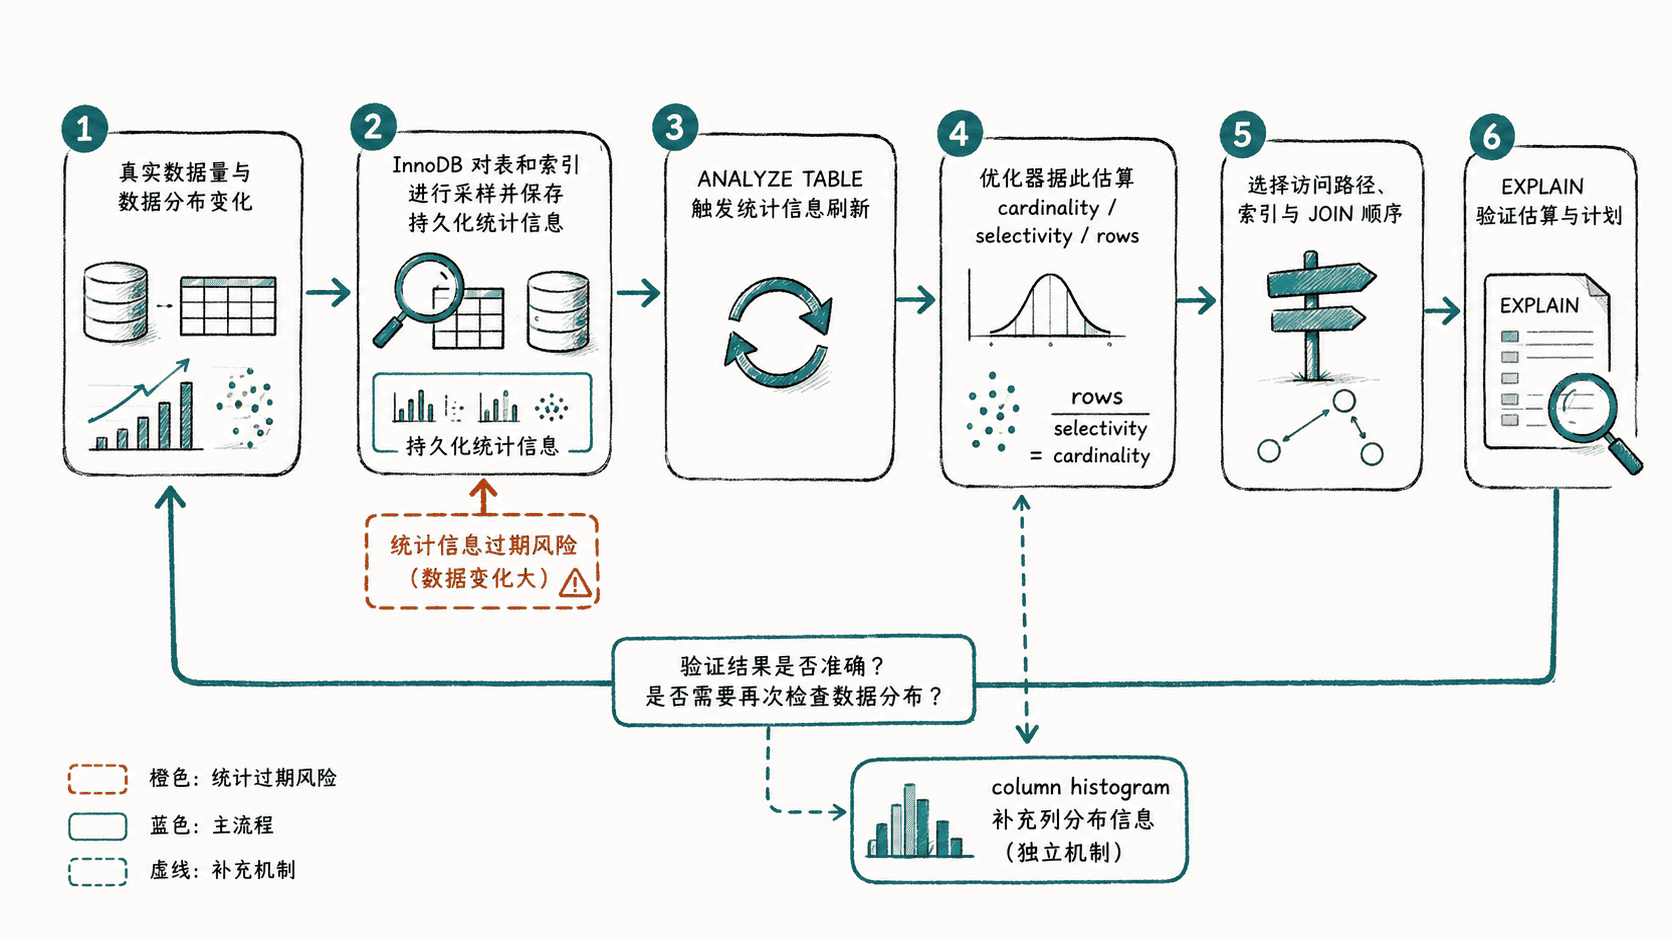
优化器不会为每个候选计划都先真正执行一遍,而是根据表行数、索引基数、值分布等统计信息估算扫描成本,再决定使用哪个索引、怎样连接表以及各表的访问顺序。
对 InnoDB 来说,持久化统计信息让这些估算可以跨实例重启保存。它们并不是业务数据的精确计数,而是采样得到的近似信息,所以当数据分布发生剧烈变化时,统计值可能暂时跟不上真实情况。
典型症状是:SQL 和索引都没改,但 EXPLAIN 的 rows 估算明显偏离实际;优化器突然放弃原本有效的索引;或者连接顺序在批量导入、归档、租户迁移之后出现明显回退。
什么时候需要重新采样
正常的持续写入并不意味着每次 DML 后都要手工刷新。更值得执行 ANALYZE TABLE 的情况,是数据规模或分布在短时间内发生了足以改变选择性的变化。
常见触发点包括大批量导入或删除、冷热数据归档、某个状态值突然从少数变成多数、租户数据迁移,以及查询计划回退同时伴随明显错误的行数估算。相反,如果只是少量增删改,而且执行计划和估算都稳定,没有必要把 ANALYZE TABLE 当成固定的高频保养动作。
执行刷新并验证计划
下面是生产排查常用的片段示例,依赖上下文:假设已经存在 app.orders,并且查询条件使用 tenant_id、status 和 created_at。执行前请替换为实际库表和业务条件。
ANALYZE TABLE app.orders;

EXPLAIN
SELECT id, customer_id, created_at
FROM app.orders
WHERE tenant_id = 42
  AND status = 'PAID'
ORDER BY created_at DESC
LIMIT 50;
预期结果
ANALYZE TABLE 返回状态为 OK。

随后 EXPLAIN 会基于刷新后的统计信息重新给出 key、rows、filtered 等估算。
这些具体值取决于真实数据分布与现有索引,因此不应预设固定数字;应与刷新前的执行计划对比。验证时至少比较三件事:候选索引是否改变,rows 与 filtered 的估算是否更接近实际,访问类型和连接顺序是否回到合理范围。若刷新后计划没有变化,但实际执行仍慢,说明根因更可能在索引设计、SQL 形态、锁等待、I/O 或缓存命中,而不是统计信息。
不要把索引统计与直方图混为一体
ANALYZE TABLE 的常规作用是刷新表和索引统计信息;列直方图是另一类补充信息,用来描述非索引列或高度偏斜列的值分布。两者都能影响选择性估算,但解决的问题不同。
如果过滤条件落在没有索引、且分布极不均匀的列上,仅刷新普通索引统计可能仍不足以改善估算。此时再评估是否需要显式维护该列的 histogram,而不是反复执行同一个 ANALYZE TABLE 期待计划变化。
刷新后仍不稳定怎么办
如果同一张表反复出现估算漂移,先检查问题是否来自极端数据倾斜,而不是简单地提高刷新频率。对高度偏斜的数据,优化器只靠抽样可能很难稳定估算;对经常变化的查询条件,过度依赖单一统计快照也可能造成计划波动。
更可靠的做法是把统计信息刷新视为诊断闭环中的一个动作:先用 EXPLAIN 记录旧计划,再确认数据分布变化,执行刷新,随后重新比较计划并用真实执行指标验证。只有当“估算更准、计划更合理、实际延迟也下降”同时成立时,才能确认这次刷新真正解决了问题。