
MySQL / 系统课时
使用 EXPLAIN 获取执行计划
使用 EXPLAIN 获取执行计划
这节课解决一个直接问题:拿到一条 SQL 后,怎样用 EXPLAIN 看清优化器准备如何访问表、按什么顺序连接,以及哪些算子真正决定扫描量。完成后你会形成一套固定阅读顺序,而不是只盯着某一个字段猜性能。
学习目标
- 会使用传统、
TREE与JSON三种格式获取执行计划 - 能从计划中定位查询块、表访问路径与算子层级
- 建立“先看结构,再看访问路径,最后看估算量”的阅读顺序
准备一条可观察的查询
下面示例使用客户表与订单表。customers.email 是唯一索引,orders 上的复合索引同时覆盖连接条件、状态过滤和时间排序,便于观察不同层级的计划信息。
CREATE TABLE customers (
  id BIGINT PRIMARY KEY,
  email VARCHAR(128) NOT NULL,
  status TINYINT NOT NULL,
  UNIQUE KEY uk_email (email)
);

CREATE TABLE orders (
  id BIGINT PRIMARY KEY,
  customer_id BIGINT NOT NULL,
  status VARCHAR(16) NOT NULL,
  created_at DATETIME NOT NULL,
  KEY idx_customer_status_created (customer_id, status, created_at)
);

INSERT INTO customers VALUES
  (1, 'alice@example.com', 1),
  (2, 'bob@example.com', 1);

INSERT INTO orders VALUES
  (101, 1, 'PAID', '2026-08-01 10:00:00'),
  (102, 1, 'PAID', '2026-08-02 10:00:00'),
  (103, 1, 'PENDING', '2026-08-03 10:00:00'),
  (104, 2, 'PAID', '2026-08-04 10:00:00');
预期结果:
两张表创建成功;customers 写入 2 行,orders 写入 4 行。客户端显示的耗时可能不同。后续都分析同一条查询:
SELECT o.id, o.created_at
FROM customers AS c
JOIN orders AS o ON o.customer_id = c.id
WHERE c.email = 'alice@example.com'
  AND o.status = 'PAID'
ORDER BY o.created_at DESC
LIMIT 10;
预期结果:
id   created_at
102  2026-08-02 10:00:00
101  2026-08-01 10:00:00
传统格式先看每张表怎么访问
最常用的入口是直接在查询前加 EXPLAIN。传统表格格式适合快速回答“先访问谁、用了什么索引、预计读多少行”。
EXPLAIN
SELECT o.id, o.created_at
FROM customers AS c
JOIN orders AS o ON o.customer_id = c.id
WHERE c.email = 'alice@example.com'
  AND o.status = 'PAID'
ORDER BY o.created_at DESC
LIMIT 10;
预期结果:
关键现象应为:
- c 先访问,type 通常为 const,key 为 uk_email
- o 后访问,type 通常为 ref,key 为 idx_customer_status_created
- rows、filtered 会随统计信息与数据量变化
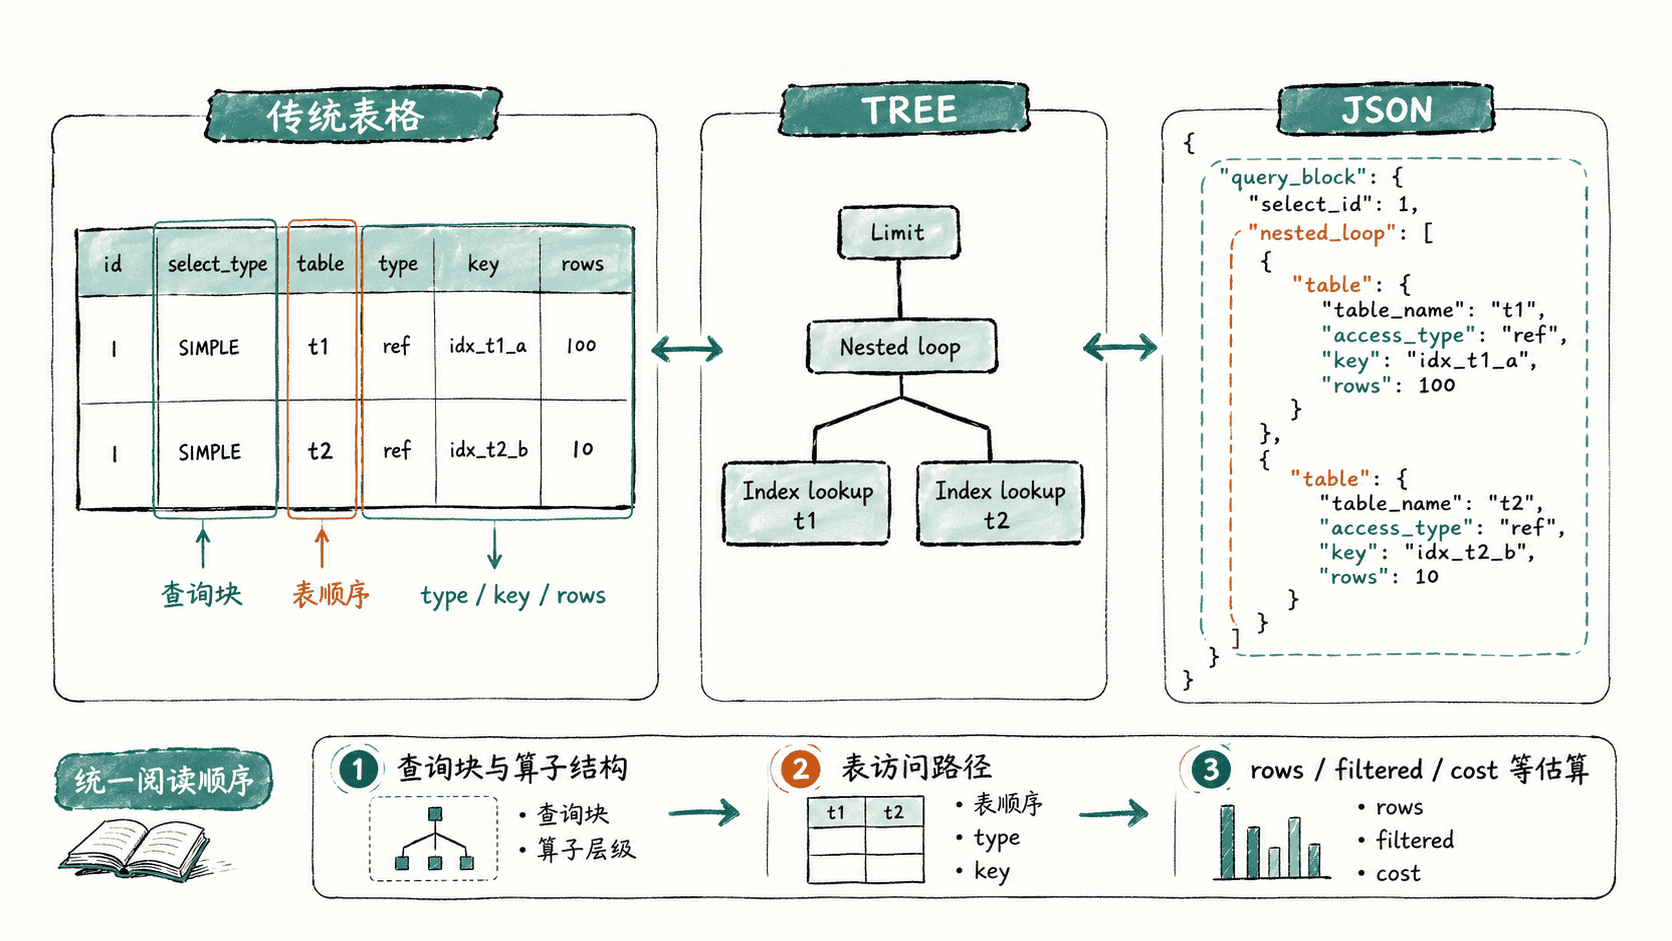
阅读传统格式时先看 id 和 select_type 确认查询块,再按输出中的表顺序看 table、type、key、key_len、ref,最后看 rows、filtered 与 Extra。不要把 rows 当成实际读取行数,它是优化器估算值。
TREE 格式按算子层级阅读
FORMAT=TREE 把计划表达成树,更适合看连接、排序、限制和索引查找之间的父子关系。缩进越深,通常越接近先被执行的数据访问节点。
EXPLAIN FORMAT=TREE
SELECT o.id, o.created_at
FROM customers AS c
JOIN orders AS o ON o.customer_id = c.id
WHERE c.email = 'alice@example.com'
  AND o.status = 'PAID'
ORDER BY o.created_at DESC
LIMIT 10;
预期结果:
会返回以 -> 和缩进表示的算子树。
关键节点应包含:
- 对 customers 的唯一索引查找
- 对 orders 的索引查找
- Nested loop inner join
- Limit;是否出现额外 Sort 取决于索引是否能直接满足排序
TREE 最重要的不是记住节点名字,而是沿着树回答三个问题:数据从哪个叶子节点进入、在哪个节点过滤或连接、上层是否还出现排序、临时结果或去重等额外工作。
JSON 格式用于查细节
当你需要查看更完整的键、条件和成本信息时,使用 FORMAT=JSON。它更适合程序化解析,也能保留传统表格没有展开的层级结构。
EXPLAIN FORMAT=JSON
SELECT o.id, o.created_at
FROM customers AS c
JOIN orders AS o ON o.customer_id = c.id
WHERE c.email = 'alice@example.com'
  AND o.status = 'PAID'
ORDER BY o.created_at DESC
LIMIT 10;
预期结果:
{
  "query_block": {
    "nested_loop": [
      {
        "table": {
          "table_name": "c",
          "access_type": "const",
          "key": "uk_email"
        }
      },
      {
        "table": {
          "table_name": "o",
          "access_type": "ref",
          "key": "idx_customer_status_created"
        }
      }
    ]
  }
}
上面只保留稳定的关键结构;真实输出还会包含更多估算字段,具体成本和行数会随统计信息变化。JSON 计划中最值得先找的是 query_block、连接或排序等上层对象,以及每个 table 下的 access_type、possible_keys、key、used_key_parts 和行数估算。
固定阅读顺序避免误判
面对复杂 SQL,可以固定按下面顺序读计划:
- 先确认查询块和最外层算子,判断是否存在子查询、派生表、排序、分组或限制。
- 再确认连接顺序,找到每张表在计划中的位置。
- 对每张表检查访问类型、实际选择的索引和使用到的索引列。
- 最后结合
rows、filtered、成本与Extra判断扫描量和额外工作。
EXPLAIN 描述的是优化器的计划与估算,不等于真实运行数据。计划结构合理但线上仍慢时,再进入实际执行分析;但在此之前,先把“结构、访问路径、估算量”三层读清楚,通常已经能排除大量明显问题。