
MySQL / 系统课时
识别 filesort 与内部临时表
识别 filesort 与内部临时表
当查询带有 ORDER BY、GROUP BY 或 DISTINCT 时,真正需要关注的不是“出现了额外操作”本身,而是参与排序或物化的数据量有多大。本课用执行计划识别 Using filesort 与 Using temporary,再把成本还原到扫描行数、排序方式和临时表是否落盘。
学习目标
- 能从
EXPLAIN中识别 filesort 与内部临时表信号 - 能解释排序、分组和去重为什么会产生额外 CPU、内存与 I/O
- 能判断应该通过索引顺序、过滤条件还是查询改写降低成本
从执行计划识别额外操作
Using filesort 表示 MySQL 不能直接利用当前访问路径的索引顺序得到最终顺序,需要执行额外排序。它的名字容易误导:filesort 不等于一定写磁盘文件,小结果集完全可能在内存中完成。
Using temporary 表示执行过程中需要内部临时表保存中间结果。GROUP BY、DISTINCT、某些复杂排序或派生结果都可能触发它,但是否出现仍取决于索引、查询形态和优化器选择。
下面用一个可复现实验同时制造分组物化与按聚合结果排序。数据量很小,因此访问方式可能因版本和统计信息略有不同,判断时只看 Extra 中的关键信号。
DROP TABLE IF EXISTS demo_orders;

CREATE TABLE demo_orders (
  id BIGINT PRIMARY KEY,
  customer_id BIGINT NOT NULL,
  status VARCHAR(16) NOT NULL,
  amount DECIMAL(10,2) NOT NULL,
  created_at DATETIME NOT NULL,
  KEY idx_status (status)
);

INSERT INTO demo_orders VALUES
  (1, 101, 'PAID', 120.00, '2026-01-01 10:00:00'),
  (2, 102, 'PAID', 80.00,  '2026-01-01 10:05:00'),
  (3, 101, 'PAID', 45.00,  '2026-01-01 10:10:00'),
  (4, 103, 'NEW',  30.00,  '2026-01-01 10:15:00'),
  (5, 103, 'PAID', 70.00,  '2026-01-01 10:20:00'),
  (6, 102, 'PAID', 25.00,  '2026-01-01 10:25:00');

EXPLAIN
SELECT customer_id, SUM(amount) AS total_amount
FROM demo_orders
WHERE status = 'PAID'
GROUP BY customer_id
ORDER BY total_amount DESC;
预期结果
EXPLAIN 的 Extra 重点可观察到:
Using temporary
Using filesort

是否同时出现 Using where、使用哪个 key,以及 rows 的估算值可能随版本、统计信息和小表成本判断而变化。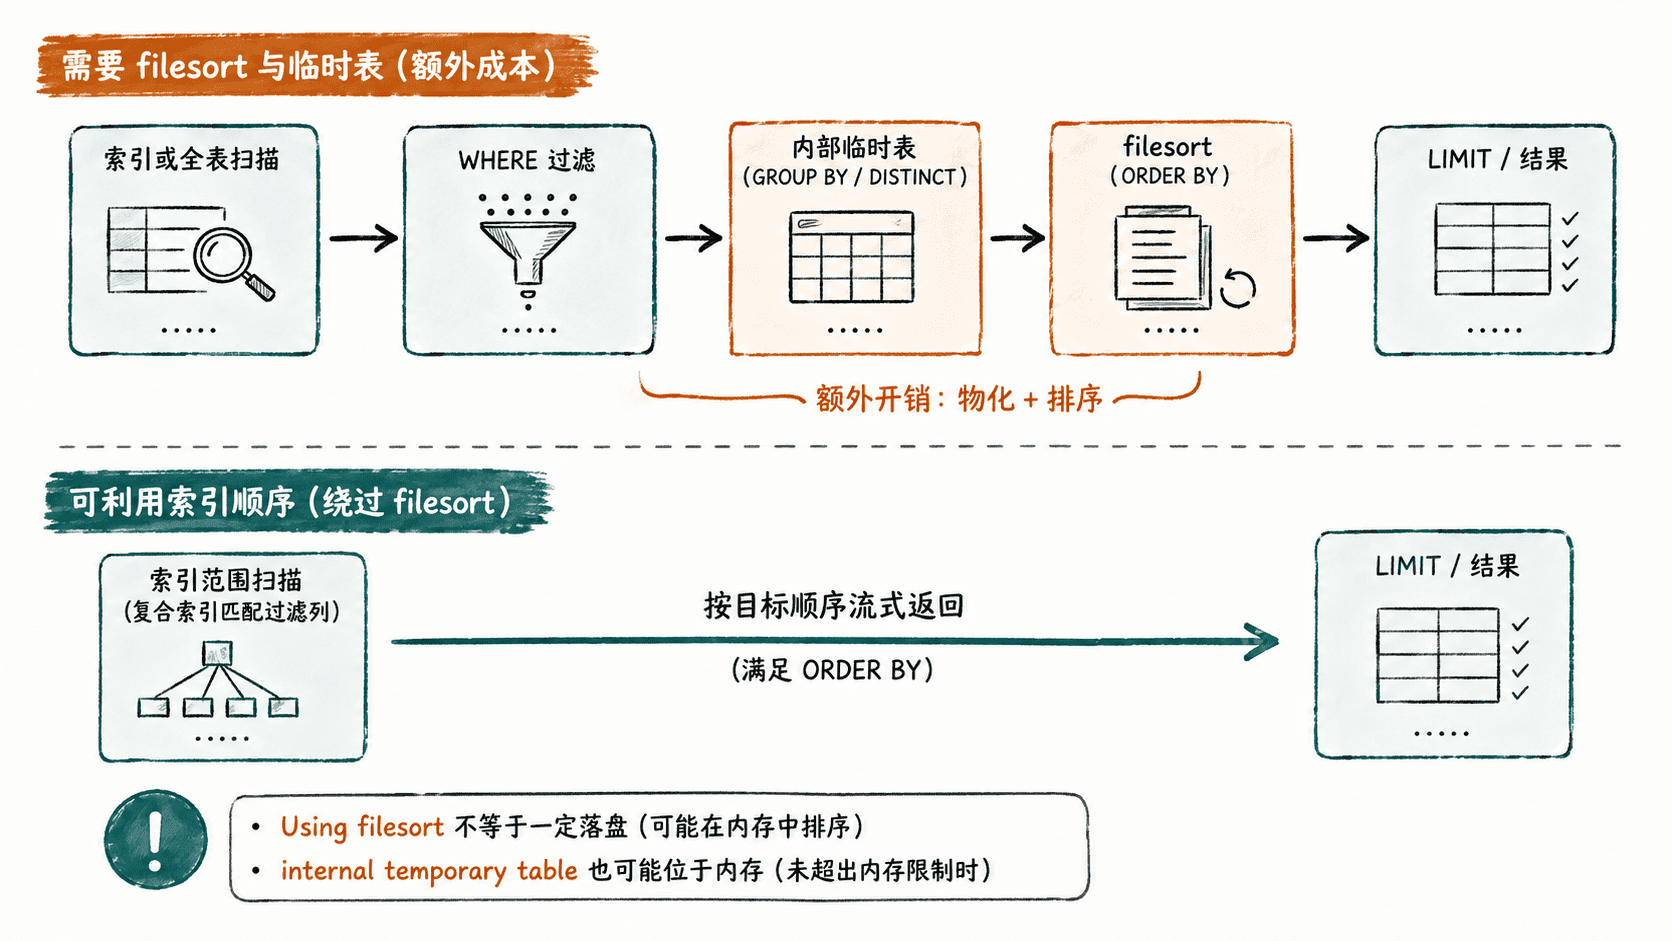
成本来自进入算子的行数
排序和临时表的第一成本不是“有或没有”,而是有多少行、多少列进入该阶段。如果前置过滤只能把一百万行缩到八十万行,即使最后只 LIMIT 20,排序器仍可能处理很大的候选集合。
filesort 的成本主要受参与排序的行数、排序键宽度、返回列宽度和内存是否足够影响。排序数据超过可用缓冲区后,可能产生多路归并和临时文件 I/O。内部临时表则会承担写入、比较、分组或去重成本;当中间结果过大或包含不适合纯内存保存的数据时,落盘成本会进一步放大。
因此看到 Using filesort 或 Using temporary 后,不要立刻把目标定成“让标记消失”。先确认它处理的数据量是否已经足够小,以及它是否真的是响应时间中的主要部分。
用索引顺序减少排序
对常见的“等值过滤 + 排序”查询,复合索引可以让过滤列先定位范围,再利用后续索引列的有序性直接输出。例如条件是 status = 'PAID',结果又按 created_at 排序时,索引 (status, created_at) 往往比两个单列索引更有机会同时服务过滤与排序。
这个规则有三个常见边界:排序列被函数或表达式包裹时,原始索引顺序通常不能直接复用;混合升降序必须与索引定义和可逆扫描能力匹配;一旦前导索引列不是等值约束,后续列能否继续提供全局有序结果要重新判断。
GROUP BY 和 DISTINCT 也可能借助有序索引降低中间物化成本,但按聚合表达式排序,例如 ORDER BY SUM(amount),通常仍需要额外排序,因为聚合结果并不存在于原始索引中。
判断是否值得优化
排查时优先回答四个问题:进入排序或临时表之前还剩多少行;最终只返回多少行;是否存在能同时服务过滤与排序的复合索引;查询是否在按计算结果或聚合结果排序。
如果只是几十或几百行的小集合,保留 filesort 往往比维护一个低收益索引更合理。真正需要治理的是“扫描很多、物化很多、排序很多、最后只取很少”的查询。优化完成后重新执行 EXPLAIN,同时结合实际延迟、扫描行数和临时表相关监控判断收益,而不是只追求 Extra 字段看起来更干净。